NVIDIAが自社GPUの演算性能にリミッターを掛けて、RTX ProシリーズとGeForceシリーズを差別化しているのは有名な話です。類似の事例として、QuadroとGeForceでCADソフトの計算精度が桁違い、といった話も昔から存在しています。
その演算性能のリミッターを解除して、RTX 4090をRTX 5090相当の性能まで跳ね上げる(倍増)とんでもない手法が発見されました。
グラフィックボードを40枚以上も所有する筆者にとって、非常に興味深い話です。実際に「RTX 4090 Unlock」を実践して、画像生成AIやLoRA学習など、ローカル生成AIタスクで利益が得られるか検証します。
(公開:2026/10/29 | 更新:2026/10/30)
「RTX 4090 Unlock」の全体像
RTX 4090から演算性能のリミッターを解除する手法を、すごくおおまかに説明するなら「Windows 11が起動する直前に、リミッター解除済みのドライバを先に読ませてGPUを起動する」です。
とてもシンプル、単純明快なテクニックです。
しかも・・・ GeForceドライバーの書き換え、vBIOSの上書き、ヒューズ回路の改造など。グラボを不可逆的に破壊するリスクのある行為は一切含まれません。
仮に失敗しても、リミッターが適用された状態でRTX 4090がのんきに起動します。
- 解除に成功 → RTX 4090の性能が2倍
- 失敗しても → いつもどおりのRTX 4090
コア電圧を弄ったり、VRAMをオーバークロックしたり、消費電力の上限枠を増やすなど。物理的にRTX 4090を故障に導く可能性がある一般的なテクニックと比べて、Unlock手法は意外とローリスクです。

購入時の価格から
なんと2.5倍もの値上がりを遂げた「RTX 4090」
1. Unlock手法の事前準備
| 準備するもの | |
|---|---|
| ❶ | GeForce RTX 4090 PCI ID = PCI\VEN_10DE&DEV_2684を確認 |
| ❷ | 任意のGeForceドライバ RTX 4090を認識できるバージョンなら何でもOK |
| ❸ | Windows 11(UEFIブートを確認) |
| ❹ | Cドライブに未割り当て領域を追加する |
| ❺ | システムドライブのBitLockerを解除 |
| ❻ | 高速スタートアップを無効化 |
| ❼ | Secure Bootを無効化 |
事前準備を満たせているか、順番に確認してみましょう。
❶「RTX 4090」のPCI IDを確認する
Get-CimInstance Win32_VideoController | Where-Object {$_.Name -like '*GeForce*'} | Select-Object Name, PNPDeviceIDPowerShellを起動して、コマンドをコピーして実行します。「PCI\VEN_10DE&DEV_2684」と表示されていれば、リミッター解除を再現できる可能性が極めて高いRTX 4090です。
❷ GeForceドライバーが入ってるか確認する
nvidia-smi --query-gpu=driver_versionPowerShellを起動して、コマンドをコピーして実行します。「610.88」など、ドライバのバージョンが表示されれば問題なし。
何も出ないならドライバのインストールが中途半端に破損している可能性があるので、念のためクリーンインストールしてください。
- GeForce Game Ready Driver 621.01 (nvidia.com)
❸ UEFIブートが有効かチェックする
$env:firmware_typePowerShellを起動して、コマンドをコピーして実行します。「UEFI」と表示されれば問題なし。
❹ Cドライブに未割り当て領域を追加する
Windowsのディスク管理画面から、Cドライブ(OSが入っているドライブ)に未割り当て領域を追加します。
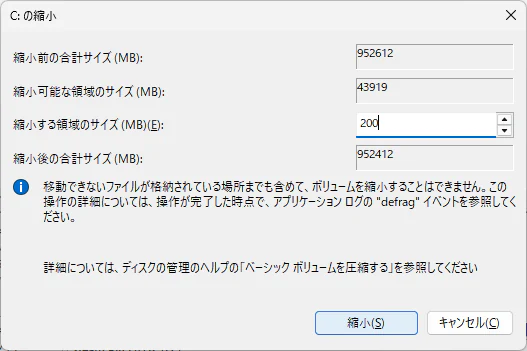
Cドライブ(OSが入っているドライブ)を右クリックして「ボリュームの縮小」をクリックし、「200 MB」くらいの未割り当て領域を追加します。
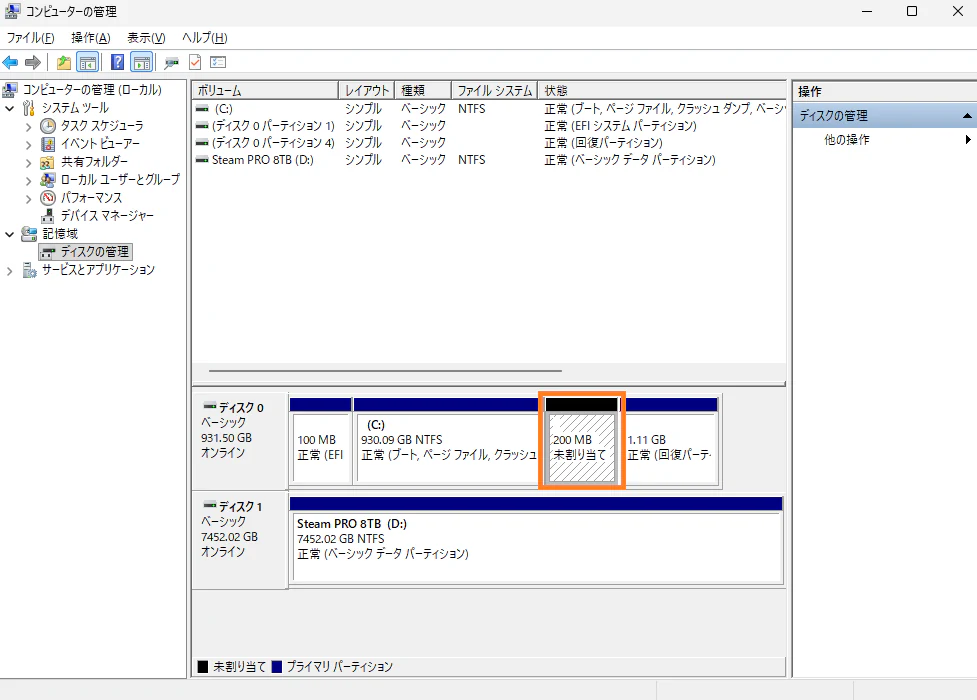
何もない空き容量が200 MB増えました。ここに、リミッターを解除する先読みドライバを常駐させる作戦です。
❺ BitLockerを解除する
manage-bde -status C:PowerShellを管理者として起動して、コマンドをコピーして実行します。
ボリューム C: []
[OS ボリューム]

サイズ: 893.26 GB
BitLocker のバージョン: なし
変換状態: 暗号化は完全に解除されています
暗号化された割合: 0.0%
暗号化の方法: なし
保護状態: 保護はオフです
ロック状態: ロック解除
識別子フィールド: なし
キーの保護機能: 見つかりません「暗号化は完全に解除されています」と表示されていれば問題なし。
ハイエンドGPUを所有する自作PCユーザーなら、おそらくWindows 11インストール時に「Rufus」を使っているはずです。その時に、BitLockerは明示的に無効化されています。
BitLockerが解除されていない人は、適当に検索して解除するか、実験用のWindows 11をRufusを使って環境整備するのもいいでしょう。
❻ 高速スタートアップを無効化する
コントロールパネル → 電源オプション → システム設定 → 電源ボタンの設定を開きます。
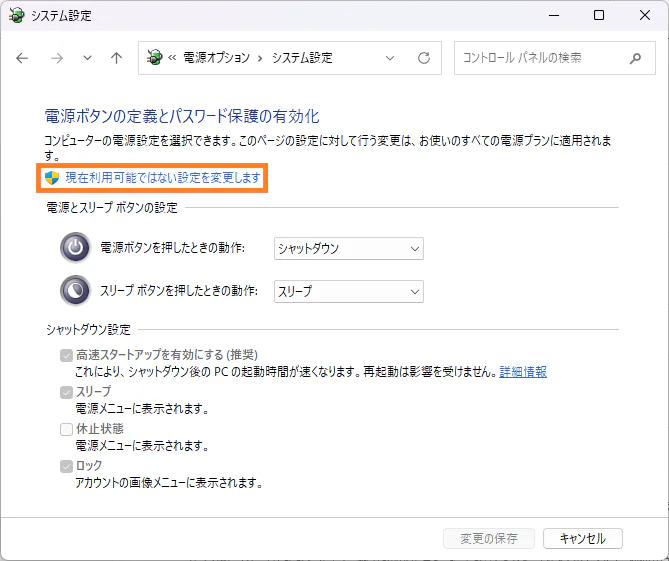
「現在利用可能ではない設定を変更します」をクリックします。
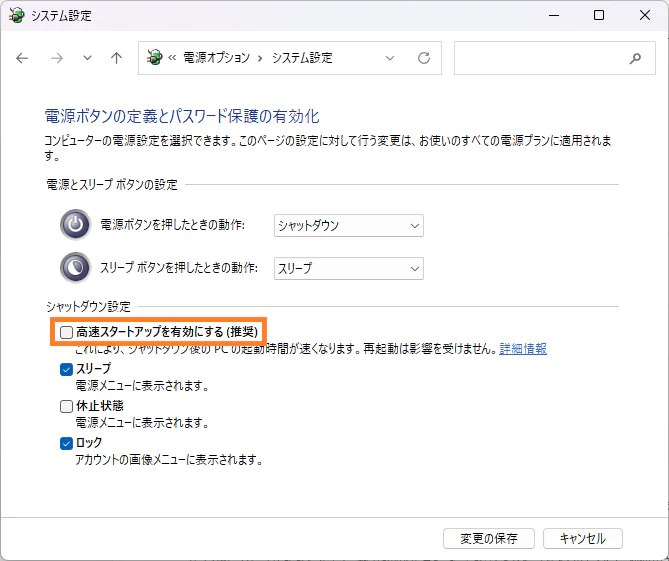
「高速スタートアップを有効にする(推奨)」から、チェックを外して完了です。
Get-ItemProperty 'HKLM:\SYSTEM\CurrentControlSet\Control\Session Manager\Power' -Name HiberbootEnabledパソコンを再起動してからPowerShellを起動して、コマンドをコピーして実行します。「HiberbootEnabled : 0」と表示されれば問題なし。
❼ Secure Bootを無効化する
パソコンを再起動して、BIOS画面を開いてください。Delete連打でBIOSを開けるマザーボードがほとんどです。
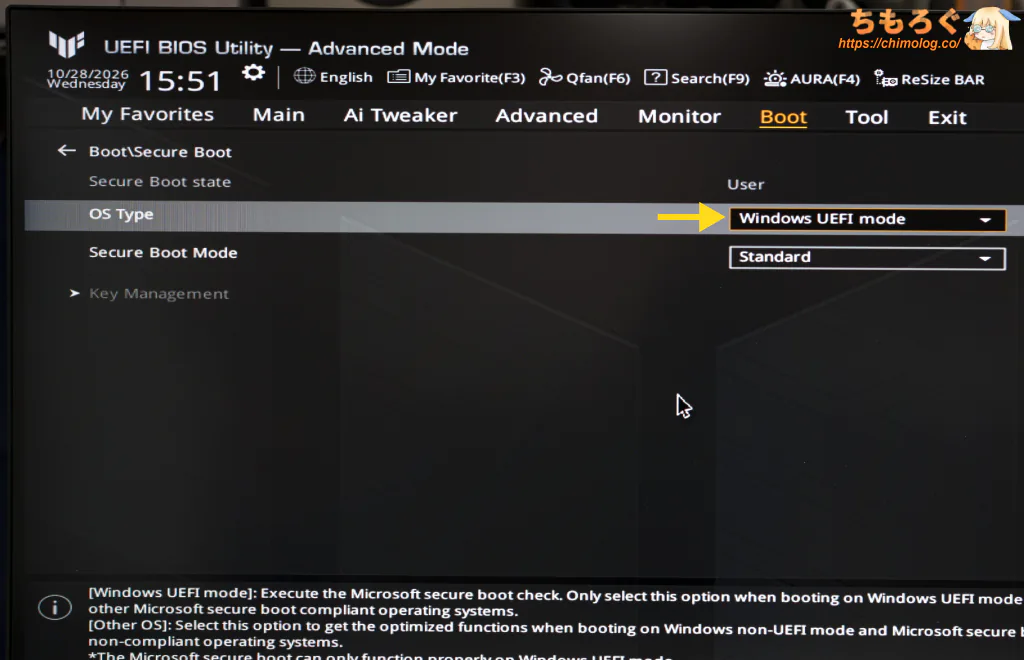
ブート設定 → Secure Bootを開いて「Windows UEFI Mode」を探します。
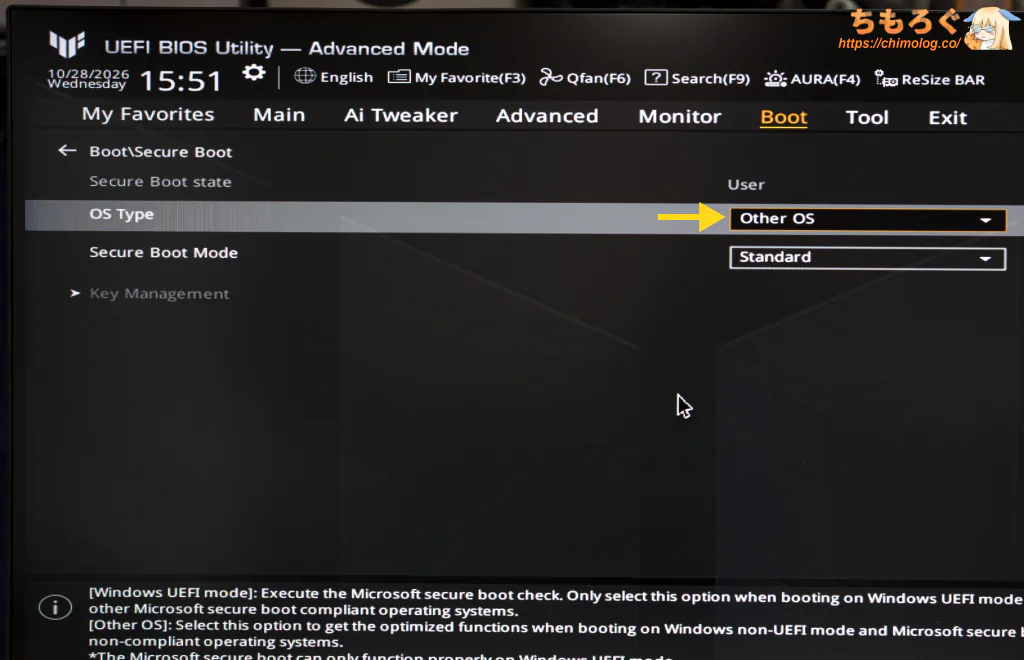
OS Typeを「Other OS」に変更します。
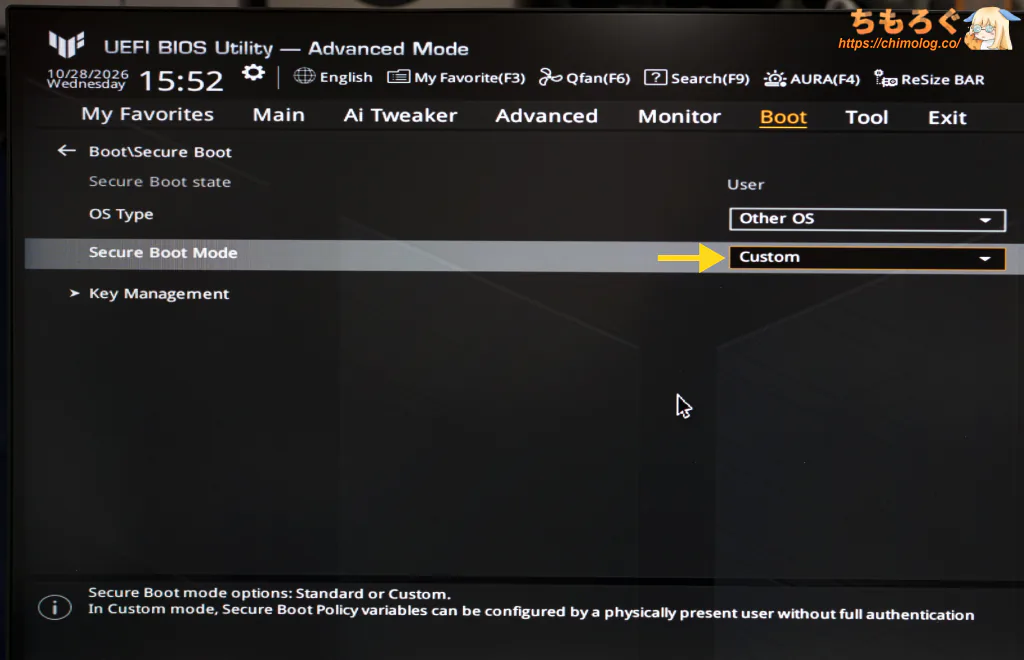
Secure Boot Modeを「Custom」に変更します。
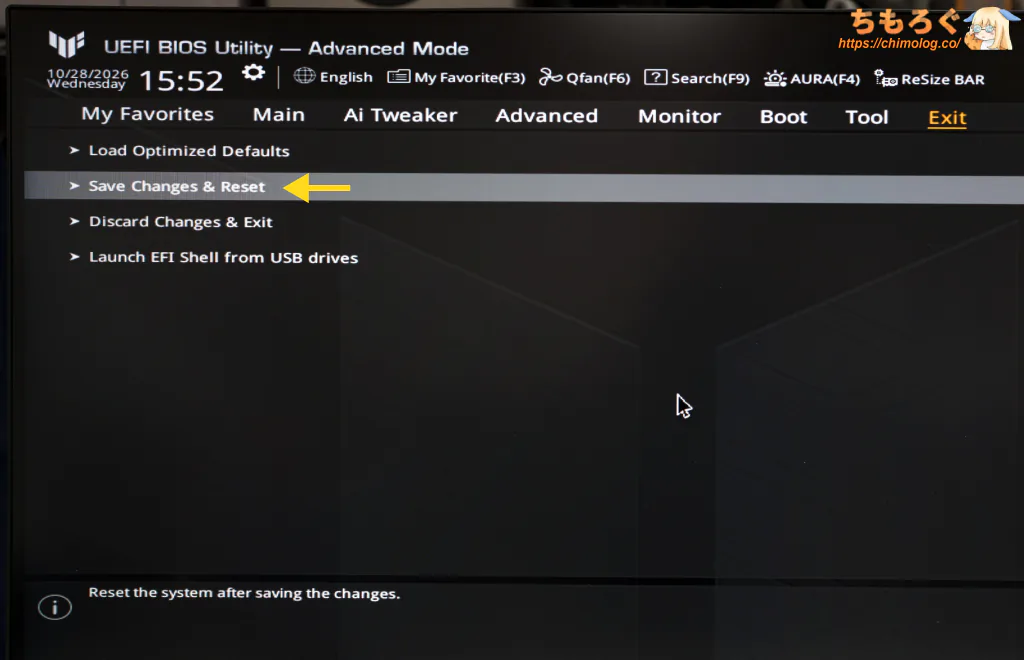
「Save Changes & Reset」で、BIOS設定を保存して再起動です。
2. リミッター解除ツールをダウンロード
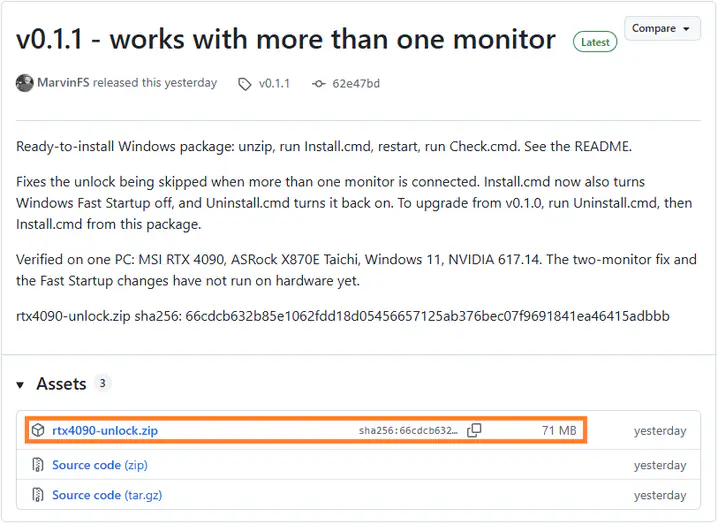
- MarvinFS / rtx4090-uefi (github.com)
Githubから、RTX 4090のWindows 11用リミッター解除ツールをダウンロードします。
Get-FileHash .\rtx4090-unlock.zip -Algorithm SHA256ダウンロードしたら、展開する前にハッシュ検証(本物かどうか確かめる)してください。PowerShellを起動して、上記のコマンドを貼り付けて実行します。
「66cdcb632b85e1062fdd18d05456657125ab376bec07f9691841ea46415adbbb」と表示されれば本物です。
ツール一式をC:ドライブ直下に配置
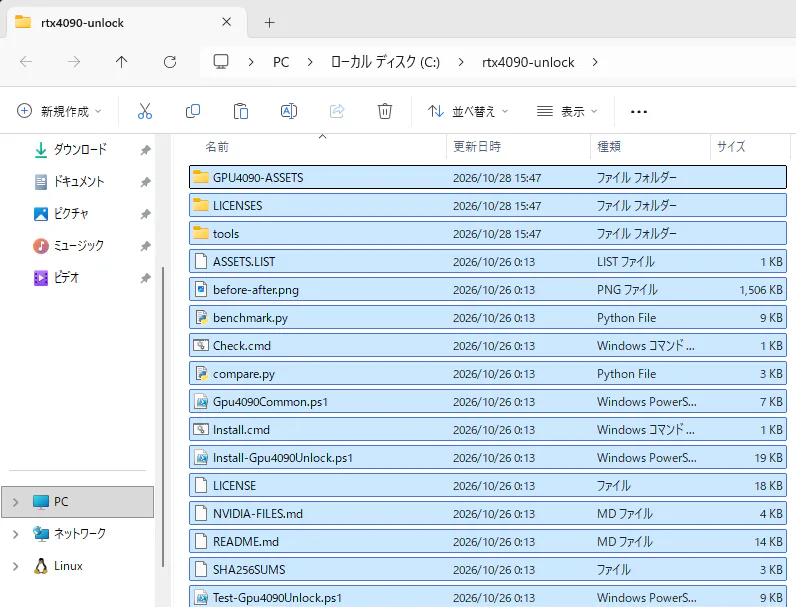
ダウンロードした「rtx4090-unlock」一式を、C:ドライブ直下に展開します。
たくさんファイルが入っていますが、RTX 4090のリミッター解除に使うツールは「Install.cmd」と「Check.cmd」の2つだけです。
リミッター解除する前に演算性能を測定
rtx4090-unlock → tools → mma_bench.exe を実行して、RTX 4090の演算性能をベンチマークしておきます。リミッター解除の前後で本当に性能が上がっているか、後で確認できます。
# GPU 0: NVIDIA GeForce RTX 4090, 128 SMs, sm_89, iters=20000 reps=3
mode best TF/s all runs
f16/f16 307.4 294.0/291.4/307.4
f16/f32 160.5 160.5/155.6/138.5
bf16/f32 160.1 160.1/160.0/158.3
s8/s32 641.6 641.4/641.6/640.3
dp4a 163.6 163.6/163.6/163.4
ffma 78.7 69.8/78.6/78.7
RTX 4090の演算性能です。FP16(FP32累積)が約160 TFLOPS、BF16(FP32累積)も約160 TFLOPSです。
# GPU 0: NVIDIA GeForce RTX 5090, 170 SMs, sm_120, iters=20000 reps=3
mode best TF/s all runs
f16/f16 429.9 421.5/416.6/429.9
f16/f32 223.8 222.9/223.8/213.2
bf16/f32 223.1 203.7/221.5/223.1
s8/s32 446.5 441.1/446.2/446.5
dp4a 224.2 193.9/224.2/224.0
ffma 108.4 108.4/107.9/108.0
参考程度に、RTX 5090の演算性能です。FP16(FP32累積)が約224 TFLOPS、BF16(FP32累積)も約223 TFLOPSです。
「Install.cmd」を実行して解除ドライバーを仕込む
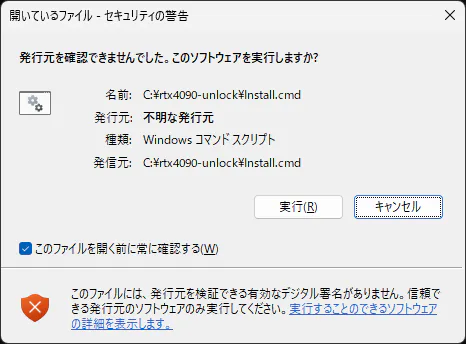
「Install.cmd」を実行してください。セキュリティの警告が2回出るので、2回とも「実行」です。
GPU: NVIDIA GeForce RTX 4090 PCI\VEN_10DE&DEV_2684&SUBSYS_40BF1458&REV_A1\4&1BABDF5B&0&0009
Package verified: 6 files, about 85 MB needed on the target.
Windows boot disk 0: GPT, 512-byte sectors, ESP free 61 MB, largest unallocated extent 200 MB, GPU4090 partition none Chosen automatically: FreeSpace [plan] create a 128 MB GPT partition in the existing unallocated space on disk 0, format FAT32, label GPU4090 [plan] copy UNLOCK4090.EFI to X:\EFI\GPU4090\UNLOCK4090.EFI and the five firmware files to X:\GPU4090-ASSETS\ (files already there with the same SHA-256 are kept) [plan] add a firmware boot entry 'RTX 4090 unlock' (bcdedit /copy {bootmgr}) pointing at \EFI\GPU4090\UNLOCK4090.EFI on X: [plan] put it first in the firmware display order; Windows Boot Manager stays in the list as the fallback Fast Startup is already off. [plan] remove the drive letter from the new partition and keep Windows from assigning one (the boot entry does not use letters)
[plan] copy the check and uninstall tools to C:\ProgramData\Gpu4090Unlock

Nothing was changed. Run again with -Apply to perform the steps above.

Install it now (creates the files, the partition if planned, and the firmware boot entry) [Y,N]?事前準備をちゃんと完了していれば、上記のメッセージが表示されるはずです。リミッター解除に進む覚悟ができたらYと打ってください。
GPU: NVIDIA GeForce RTX 4090 PCI\VEN_10DE&DEV_2684&SUBSYS_40BF1458&REV_A1\4&1BABDF5B&0&0009
Package verified: 6 files, about 85 MB needed on the target.
Windows boot disk 0: GPT, 512-byte sectors, ESP free 61 MB, largest unallocated extent 200 MB, GPU4090 partition none
Chosen automatically: FreeSpace
[do] create a 128 MB GPT partition in the existing unallocated space on disk 0, format FAT32, label GPU4090
[do] copy UNLOCK4090.EFI to E:\EFI\GPU4090\UNLOCK4090.EFI and the five firmware files to E:\GPU4090-ASSETS\ (files already there with the same SHA-256 are kept)
[do] add a firmware boot entry 'RTX 4090 unlock' (bcdedit /copy {bootmgr}) pointing at \EFI\GPU4090\UNLOCK4090.EFI on E:
[do] put it first in the firmware display order; Windows Boot Manager stays in the list as the fallback
この操作を正しく終了しました。
この操作を正しく終了しました。
この操作を正しく終了しました。
Firmware boot order: {■■■■}, {bootmgr}, {■■■■}, {■■■■}, {■■■■}
Fast Startup is already off.
[do] remove the drive letter from the new partition and keep Windows from assigning one (the boot entry does not use letters)
[do] copy the check and uninstall tools to C:\ProgramData\Gpu4090Unlock

Installed. Restart. On the next boot you get a 3 second countdown; Esc opens the menu.
If the screen does not come back, power off, then use the firmware boot menu to pick Windows Boot Manager.
Sleep returns the card to stock: after waking the PC from sleep, restart to unlock again.
After the restart, check it: C:\ProgramData\Gpu4090Unlock\Check.cmd

続行するには何かキーを押してください . . .
1分もかからず、リミッター解除用の先読みドライバーがEFI領域(または未割り当て領域)に展開されています。
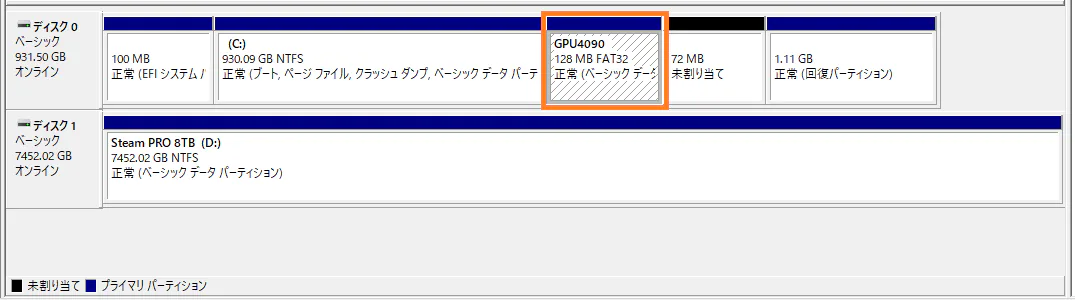
ディスクの管理画面で「GPU4090」パーティーションを確認できます。容量128 MB(FAT32)です。
電源ケーブルを抜いて30秒待ってから再起動
パソコンをシャットダウンして、電源ケーブルを抜いて30秒以上待ちます。
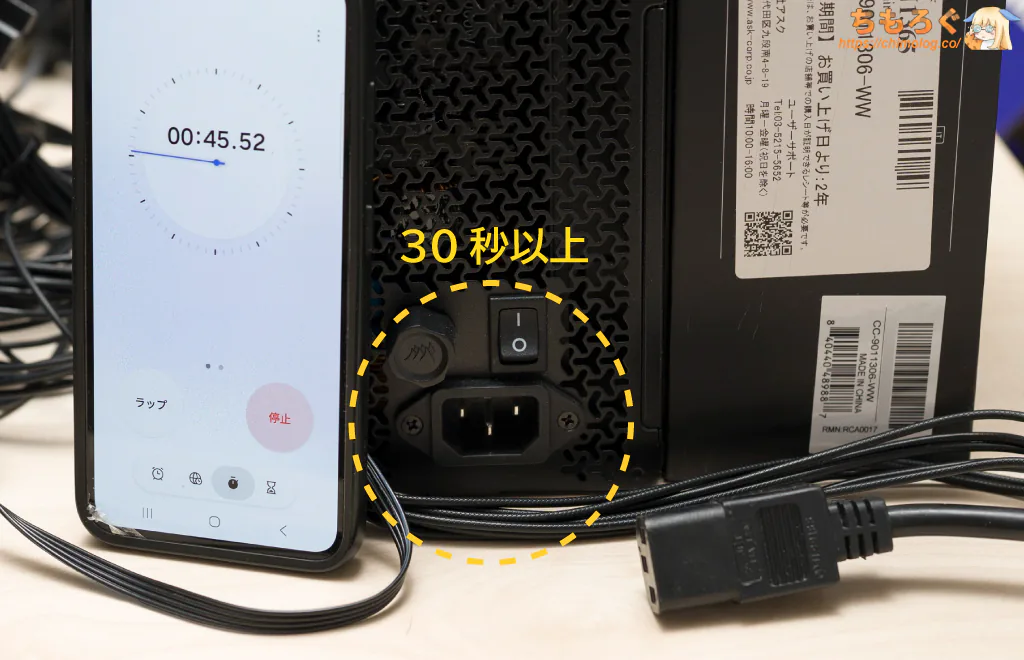
電源ユニットから抜くか、コンセントから抜いても同じです。電力供給を完全に切った状態で、30秒以上待ってから電源を入れます。
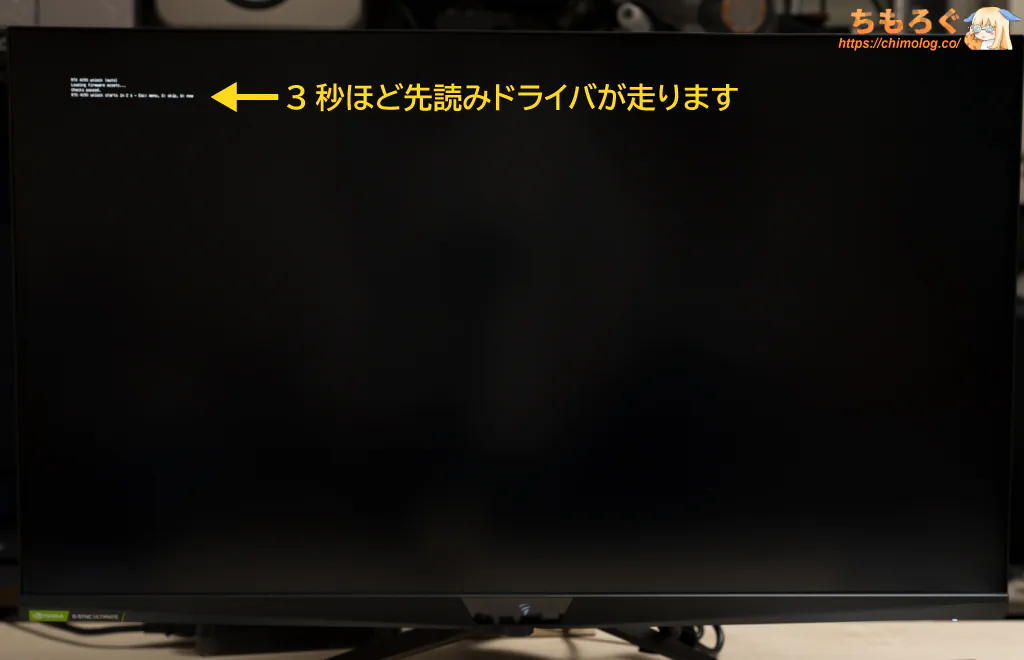
パソコンを起動すると、画面が真っ暗に暗転して、左上にリミッター解除用のドライバーが約3秒走ります。何もせず、そのまま待っていれば正常にWindows 11が起動するはずです。
「Check.cmd」を実行して効果を確認する
Windows 11が起動したら、「Check.cmd」を実行してください。
Also run the one-minute GPU benchmark that measures the unlock [Y,N]?Y「アンロックの効果を確かめるために、ベンチマークを実行しますか?」と表示されるのでYで実行します。
[info] Windows started 10/28/2026 16:43:03
[ok] installed: target FreeSpace, disk 0, variant Auto
[ok] boot entry 'RTX 4090 unlock' is first in the firmware boot order
[ok] Windows Fast Startup is off
[ok] the app and its 5 firmware files are intact on the install partition
[info] newest app log: RUN0001.TXT, written 10/28/2026 16:43:00 (this boot)
[ok] the app unlocked the GPU at this boot (TRANSACTION OK, POST-GOP SS0=0x88888888 SS1=0x8)
[ok] driver: NVIDIA GeForce RTX 4090, 0x268410DE, 610.88, 450.00 W, P8
[ok] no NVIDIA driver errors since boot
[info] running tools\mma_bench.exe 20000 5 (about a minute of full GPU load) ...
# NVIDIA GeForce RTX 4090, 128 SMs, sm_89, iters=20000 reps=5
mode best TF/s all runs
f16/f16 312.4 280.2/283.6/308.3/304.4/312.4
f16/f32 312.8 308.3/312.8/309.0/300.9/306.8
bf16/f32 328.7 319.7/328.7/328.7/328.7/328.7
s8/s32 657.6 657.5/657.6/657.5/657.6/657.5
dp4a 163.5 163.5/163.5/163.5/163.5/163.4
ffma 78.7 78.6/78.6/78.6/78.7/78.6
[ok] UNLOCKED in this session: FP32-accumulate rate 313 / 329 TF/s (FP16/BF16) vs FP16-accumulate 312 TF/s, ratio 1.00

All checks passed.

続行するには何かキーを押してください . . .
RTX 4090のリミッター解除が無事成功しました。
| GPU | RTX 4090 | RTX 4090 Unlock | RTX 5090 |
|---|---|---|---|
| f16/f16 | 307.4 TF/s | 312.4 TF/s | 429.9 TF/s |
| f16/f32 | 160.5 TF/s | 312.8 TF/s | 223.8 TF/s |
| bf16/f32 | 160.1 TF/s | 328.7 TF/s | 223.1 TF/s |
| s8/s32 | 641.6 TF/s | 657.6 TF/s | 446.5 TF/s |
| dp4a | 163.6 TF/s | 163.5 TF/s | 224.2 TF/s |
| ffma | 78.7 TF/s | 78.7 TF/s | 108.4 TF/s |
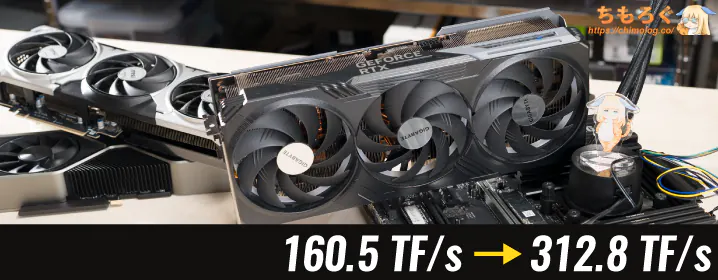
リミッター解除(Unlcok)後、RTX 4090のFP16(FP32累積)が約313 TFLOPS、BF16(FP32累積)は約329 TFLOPSまで大幅に性能アップ。
- FP16(FP32累積):1.95倍(+95%)
- BF16(FP32累積):2.05倍(+105%)
ほぼ2倍の演算性能です。価格が2倍近いRTX 5090と比べて、約1.5倍(+47%)も上回るスループットを叩き出しており、数値だけなら「下剋上」と表現して差し支えない状況です。
3. ローカルAI性能はどれくらい向上する?
実験用のPCスペック & 使用するソフト
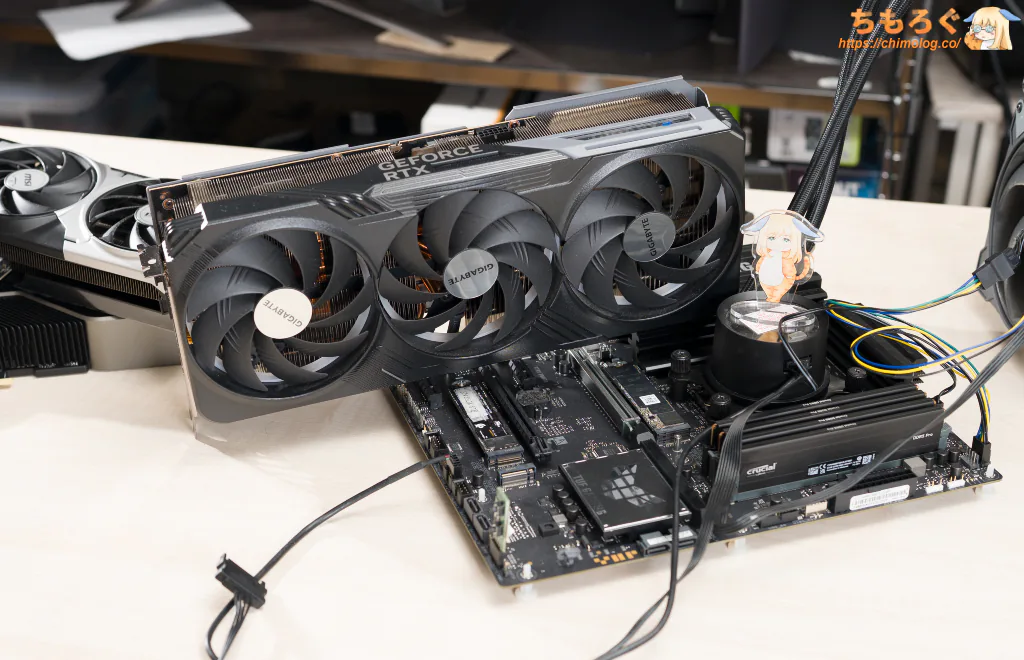
検証用の機材(PCスペック)を紹介します。
- CPU:Ryzen 7 9800X3D
- メモリ:DDR5-5600(192 GB)
- GPU:RTX 4090 Unlock / RTX 5090
- SSD:WD Black SN850X(8 TB)
- OS:Windows 11 Pro 25H2
- ドライバ:GeForce Game Ready 610.84 WHQL(CUDA 13.3)
ローカル生成AI界隈でそれほど珍しくもない、凡庸なPCスペックです。動画生成AIの黎明期(Wan2.2)にハマった人なら、なおさら普通のPCスペックでしょう。
- 画像生成 / 動画生成:ComfyUI (v0.43.0)
- LoRA学習:AI-Toolkit(b69b983)
- 小型LLM推論(Dense):llama.cpp(b11938)
- 大型LLM推論(MoE):Strata Engine (v0.1.52)
生成に使用するソフトは以上の4つです。各ベンチマークごとに、使用したモデル(量子化の程度)と生成設定を記載します。
IllustriousXL(BF16)
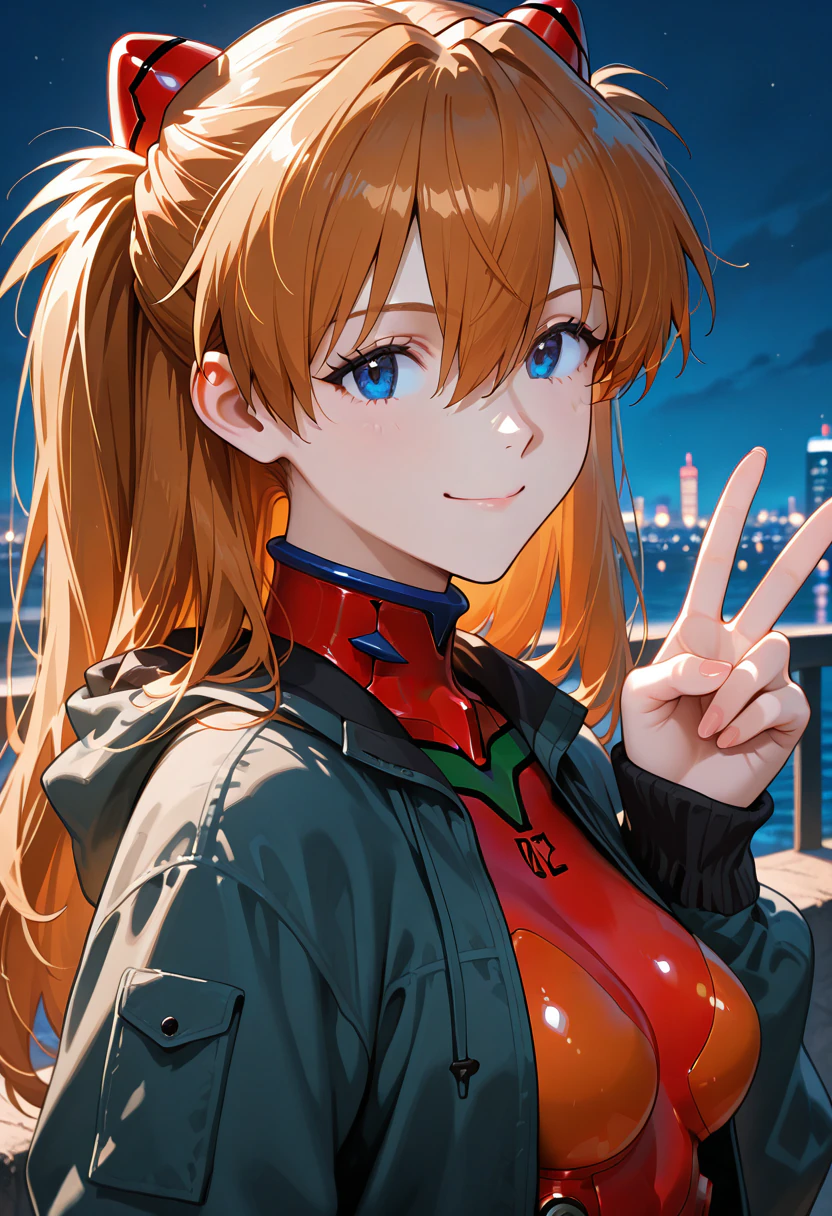
832 x 1216 / 28 steps / 10 counts
今もなお主流の画像生成モデル「IllustriousXL」から始めます。某Wikiが推奨している定番ベンチマーク「Asuka Benchmark XL」です。
| GPU | 生成時間 | 速度 |
|---|---|---|
| RTX 5090 | 23.15 秒 | 12.10 it/s |
| RTX 4090 Unlock | 27.62 秒 | 10.14 it/s |
| RTX 4090 Unlock –fast なし | 30.21 秒 | 9.27 it/s |
| RTX 4090 | 30.11 秒 | 9.30 it/s |
今回使った「prefectIllustriousXL_v10.safetensors」は、BF16形式のモデルです。リミッター解除の影響が少し出ていて、約1.1倍(+9%)の高速化が見られます。
Anima Base v1.0(BF16)
832 x 1216 / 25 steps / 10 counts
IllustriousXLの次に高い人気を集めている、比較的新しいモデル「Anima Base v1.0」です。Asuka Benchmark XLの設定を流用しつつ、ステップ数を28 → 25に減らしました。
| GPU | 生成時間 | 速度 |
|---|---|---|
| RTX 5090 | 44.06 秒 | 5.67 it/s |
| RTX 4090 Unlock | 62.35 秒 | 4.01 it/s |
| RTX 4090 Unlock –fast なし | 56.59 秒 | 4.42 it/s |
| RTX 4090 | 62.65 秒 | 3.99 it/s |
生成モデルとテキストエンコーダーどちらもBF16形式なので、SDXLより高い効果を期待していましたが、まったく変化が見られない結果に終わります。
・・・変化が出ない理由を説明しましょう。
現在のComfyUIは起動オプションに「- -fast fp16_accumulation」引数を付けると、FP32累積を回避してFP16累積モードで動かせます。
- f16/f16:307.4 TF/s → 312.4 TF/s
- bf16/f32:160.1 TF/s → 328.7 TF/s
リミッターを解除する前から、RTX 4090はAnima Base v1.0の生成において、すでに全力を出せています。リミッター解除しても性能がまったく変化しない最大の要因です。
一方、RTX 5090はf16/f16で約430 TF/sを叩き出し、RTX 4090に対して約1.4倍です。Animaの生成速度もおおむね約1.4倍に一致しているので、f16/f16演算性能だけで合理的な説明ができます。
FP16累積モードを解除する(fastを外す)と、Animaの場合は約9%の性能アップが見られますが、リミッター解除後のFP16とBF16演算性能はどちらも同じです。
約9%の差分は、中身がすべてBF16で構成されているAnimaを、わざわざFP16を経由(変換)させた時に発生するペナルティです。
Krea2 Raw(BF16)
832 x 1216 / 18+12 steps / 5 counts
生成モデル本体だけで約26.3 GB、テキストエンコーダーで約8.9 GBもの容量を誇る巨大モデル「Krea2 Raw」です。
RTX 5090ですらVRAM容量に収まりきらないですが、ComfyUIのお得意技「キャッシュ」や「オフロード」技術の見せ所です。VRAMから大量に漏れているのに、かなりの生成速度を出せてしまいます。
| GPU | 生成時間 | 速度 |
|---|---|---|
| RTX 5090 | 128.82 秒 | 1.16 it/s |
| RTX 4090 Unlock | 180.05 秒 | 0.83 it/s |
| RTX 4090 Unlock –fast なし | 211.54 秒 | 0.71 it/s |
| RTX 4090 | 182.11 秒 | 0.82 it/s |
モデルとテキストエンコーダーどちらもBF16形式を使ったものの、リミッター解除の効果はまったく見られません。
先ほどと同じく、「- -fast fp16_accumulation」引数によるFP16累積モードが主な理由です。最初から全力で動いているから、リミッターを解除しても特に変わらないです。
RTX 5090はf16/f16で約430 TF/s前後、RTX 4090が約307 TF/sだから、約1.4倍の性能差とほぼ一致します。
Qwen Image 2.1(BF16)
1024 x 1536 / 40 steps / 5 counts
プロンプトはQwen3.8 Next Flash IQ3_Sが設計
生成モデル本体が約14.2 GB、テキストエンコーダーで約17.5 GBもの容量を持ちながらも、優れた編集性能(Edit)が高く評価され熱い人気を集めている「Qwen Image 2.1」もベンチマーク。
Krea2と同じく、RTX 5090ですらVRAM容量に収まりきらない巨大モデルですが、ComfyUIなら何とか処理してしまいます。
| GPU | 生成時間 | 速度 |
|---|---|---|
| RTX 5090 | 96.82 秒 | 2.07 it/s |
| RTX 4090 Unlock | 116.61 秒 | 1.72 it/s |
| RTX 4090 Unlock –fast なし | 116.88 秒 | 1.71 it/s |
| RTX 4090 | 130.57 秒 | 1.53 it/s |
BF16形式でも「- -fast」を使っているから・・・ と思いきや、Qwen Image 2.1はなぜか高速化の効果が出ています。リミッター解除の前後で約1.1倍(+12%)です。
model weight dtype torch.bfloat16「- -fast」を付けてもComfyUI側がBF16のまま動かしたほうが良いと判断すると、BF16で生成が始まります。
RTX 5090とRTX 4090の性能差(bf16/f32)は約1.4倍で、実際の速度が約1.35倍です。逆算して、リミッター解除後のRTX 4090はRTX 5090を容易く突破できるはずですが、実際は超えられませんでした。
理由はシンプルにBF16形式モデルがあまりにも巨大過ぎて、容量24 GBのVRAMに入り切らず、ComfyUIのオフロード技術「Dynamic VRAM」を発動させるからです。
RTX 4090とDDR5メモリをつなぐPCIeスロットが「Gen4 x16」なのも災いしています。
- PCIe 4.0 x16:1秒あたり32 GB
- DDR5-5600:1秒あたり50~60 GB前後(Zen5 IFOP経由)
DDR5メモリより遥かに遅いです。せめて「Gen5 x16」ならもう少し性能を伸ばせたでしょう。
MOSS Image Base(BF16)
1024 x 1536 / 50 steps / 5 counts
画像の元ネタ(@_a5_s_)
プロンプトはQwen3.8 Next Flash IQ3_Sが設計
ようやく筆者やかもちのイチオシモデル「MOSS Image Base」の出番です。
Baseモデルの時点で完全な無検閲、二次からセルシェーディングから実写まで、あらゆるジャンルで検閲なしの画像生成を楽しめる最強モデルです。荒ぶる画風はLoRAで容易にコントロール可能。
引き続き「BF16」版を使ってベンチマークします。Kohaku氏の「FP16」版と「- -fp16-unet」を使う手もありますが、確実にRTX 5090に勝てなくなるので、忖度してBF16でテストです。
| GPU | 生成時間 | 速度 |
|---|---|---|
| RTX 5090 | 98.35 秒 | 2.54 it/s |
| RTX 4090 Unlock | 128.25 秒 | 1.95 it/s |
| RTX 4090 Unlock –fast なし | 127.96 秒 | 1.95 it/s |
| RTX 4090 | 142.51 秒 | 1.75 it/s |
残念ながら、Qwen Image 2.1と同じ結末に帰結します。
倍速化したBF16演算を使って高速化しても約1.1倍(+12%)です。FP16モデル自体が巨大すぎてVRAMに入り切らず、PCIeスロット(32 GB/s)に足を引っ張られます。
つくづくRTX 4090が「Gen5 x16(最大64 GB/s)」だったらと思わずにいられない。または、FP16やBF16でも収納できるほど、VRAM容量が大きかったら良かったのに。
MOSS Image Base(INT8)
「Int8_ConvRot」版もついでにベンチマークします。
| GPU | 生成時間 | 速度 |
|---|---|---|
| RTX 5090 | 42.44 秒 | 5.89 it/s |
| RTX 4090 Unlock | 58.84 秒 | 4.25 it/s |
| RTX 4090 Unlock –fast なし | 58.54 秒 | 4.27 it/s |
| RTX 4090 | 59.07 秒 | 4.23 it/s |
予想どおり、まったく高速化しなかったです。
RTX 5090との性能差は約1.4倍も開いています。INT8演算性能は約1.3倍(+27%)の差なので、VRAM漏れによるPCIe帯域ボトルネックも足を引っ張ります。
MiniMax H3(BF16)
864 x 480 / 20 steps / 1 counts
(※音は削除済み / 圧縮したのでノイズ多め)
ローカルでまともに動作する動画生成モデルとしては最高峰「MiniMax H3」も検証します。
テキストエンコーダーとVAEに「Int8_ConvRot」版、生成モデル本体に「BF16(pruned)」版を使います。
| GPU | 生成時間 | 速度 |
|---|---|---|
| RTX 5090 | 86.05 秒 | 0.23 it/s |
| RTX 4090 Unlock | 105.04 秒 | 0.19 it/s |
| RTX 4090 Unlock –fast なし | 104.51 秒 | 0.19 it/s |
| RTX 4090 | 115.74 秒 | 0.17 it/s |
倍速化したBF16演算を使って高速化しても約1.1倍(+10%)です。Qwen Image 2.1、MOSS Imageと同様に、BF16モデル自体があまりにも大きいです。
VRAM容量から溢れてしまうため、PCIeスロット(32 GB/s)がボトルネックになってしまい、せっかく倍速化したBF16演算を最大限に利用できない状態です。
LoRA学習:AI-Toolkit
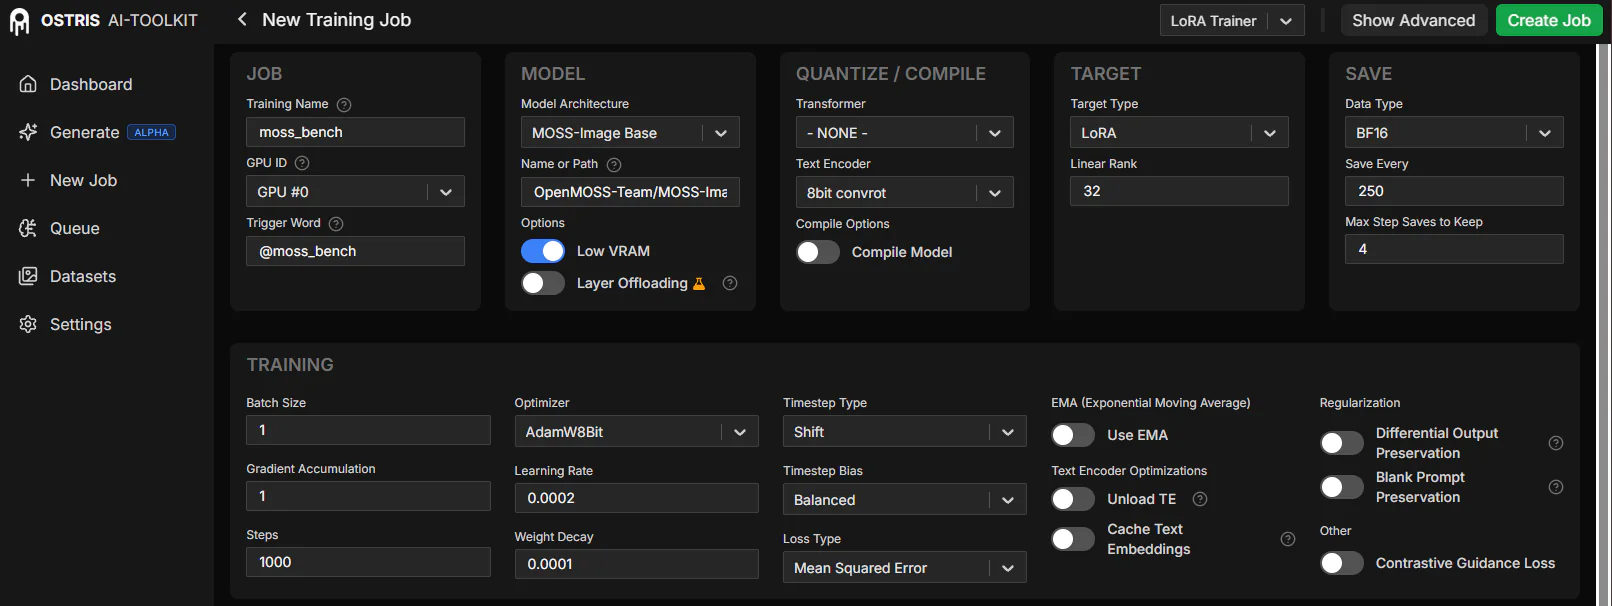
初期設定のまま回すだけで、簡単にそれなりの学習効果を得られるLoRAキット「AI-Toolkit」を使って、LoRA学習にかかる時間をベンチマークします。
- 学習モデル:MOSS Image Base(BF16)
- テキストエンコーダー:Int8_ConvRot版
- 学習ステップ数:1000
- 学習バッチサイズ:1
- 学習率:0.0002
- 学習サイズ:512~1024 px
オプティマイザーやタイムステップはデフォルト設定(既定値)のまま、1000ステップ完了するのに掛かった時間で競います。
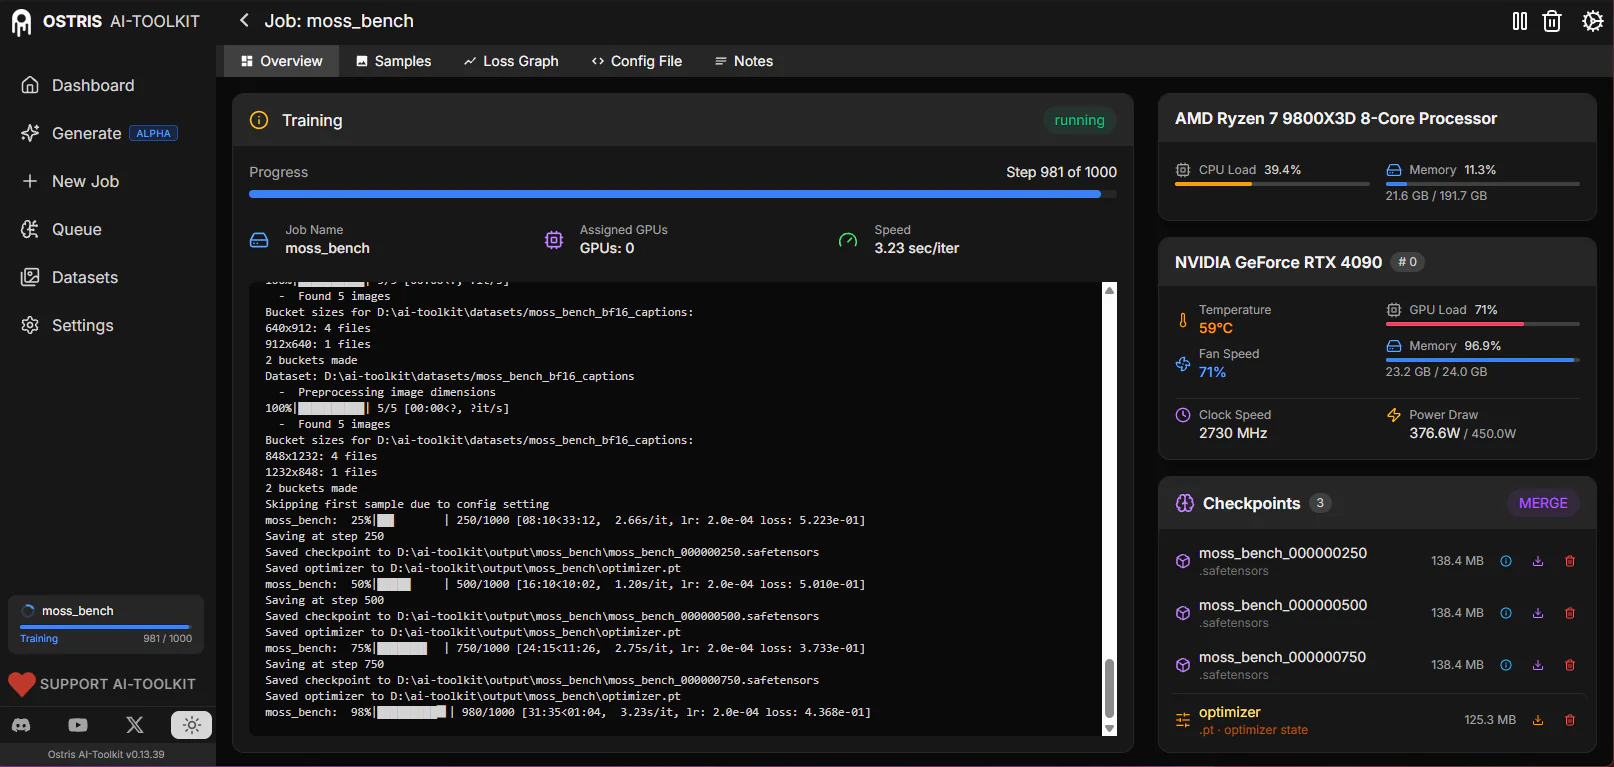
| GPU | 学習時間 | 速度 |
|---|---|---|
| RTX 5090 | 1521 秒 | 0.66 it/s |
| RTX 4090 Unlock | 1789 秒 | 0.56 it/s |
| RTX 4090 | 1932 秒 | 0.52 it/s |
リミッター解除の効果は約1.1倍(+8%)の性能アップを遂げて、なんとRTX 5090にあと一歩で匹敵します。
バッチサイズや学習サイズを大きくすれば、VRAM使用量が増えて性能差が開く可能性は十分に考えられますが、少なくともバッチ:1(1024 px)の条件においてRTX 4090 ≒ RTX 5090です。
| LoRAなし | LoRA適用 |
|---|---|
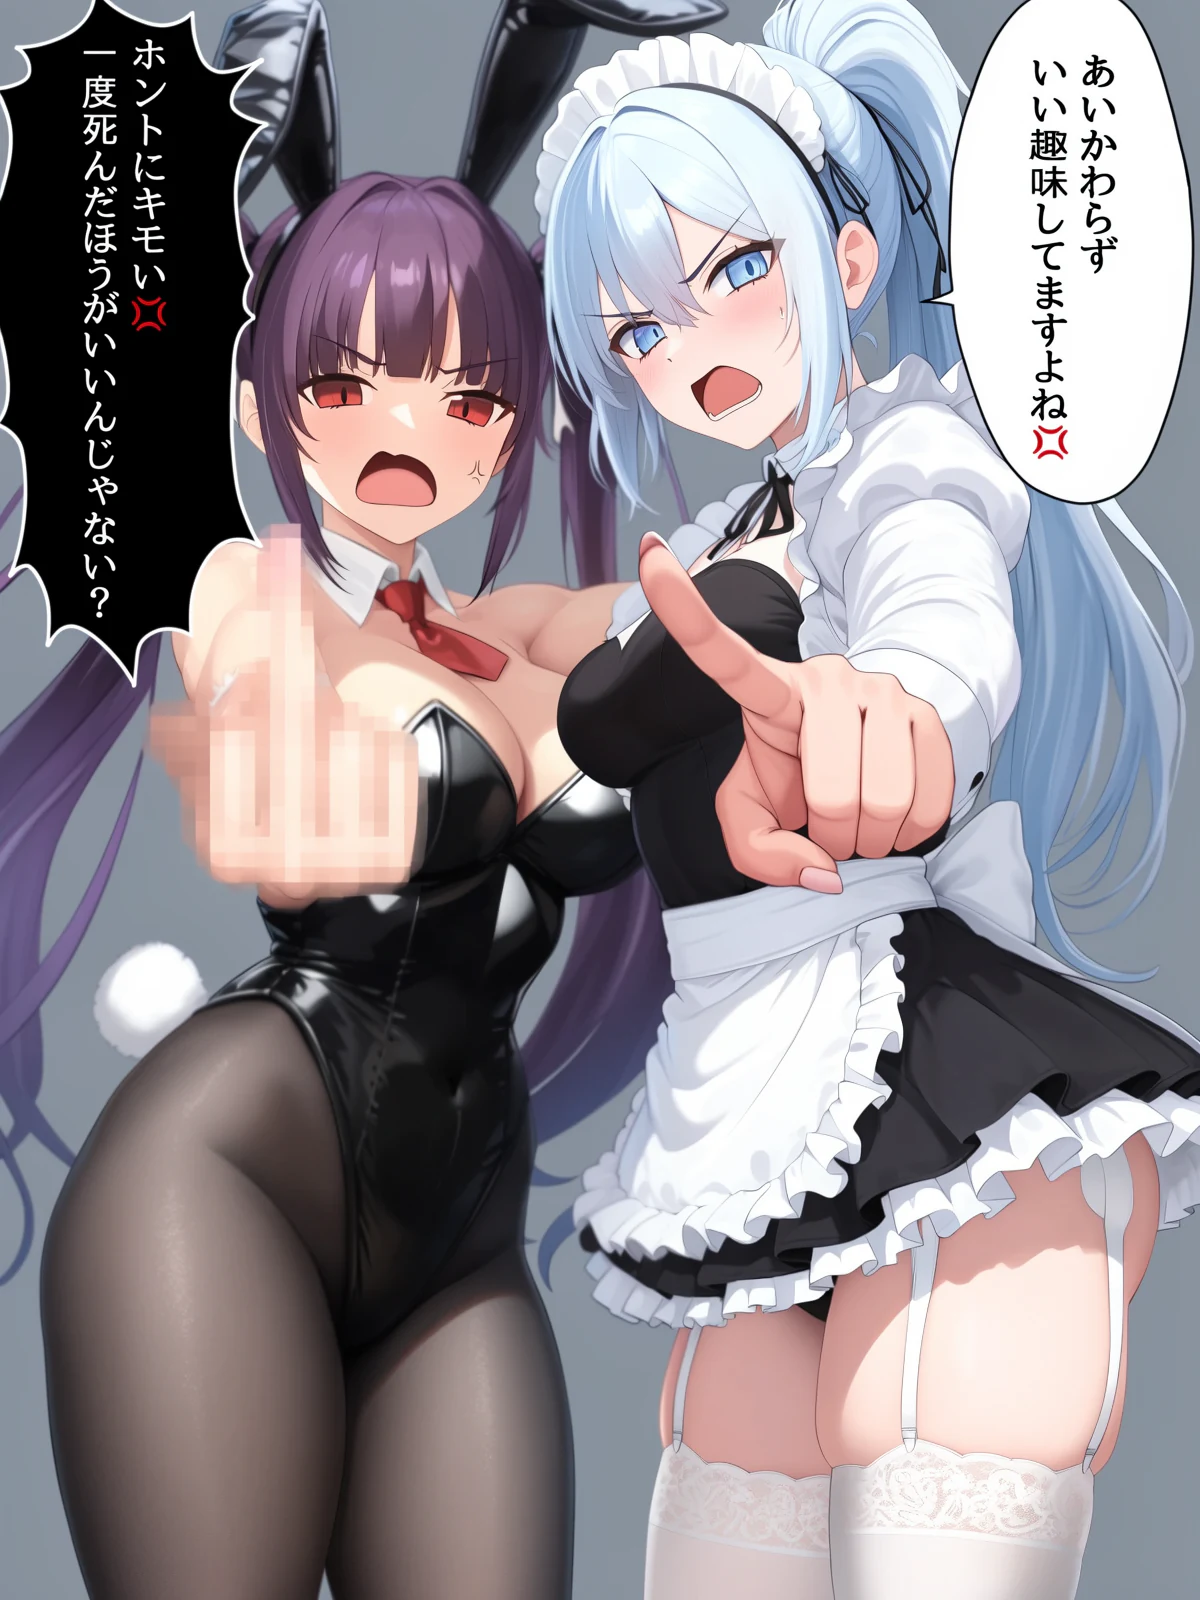 |  |
(作ったLoRAを適用してみよう)
小型LLM推論:llama.cpp
小型サイズのLLM推論エンジンで知名度が高い「llama.cpp」の速度をベンチマークします。
なお、LLMベンチマークは実際にチャットして測定すると数値が不正確ですし、取得が難しい数値(prefill)が含まれます。
正確に測定するため「llama.cpp/tools/llama-bench」を使います。
| モデル | Huihui-HY-MT1.5-7B-abliterated.f16.gguf | |||
|---|---|---|---|---|
| GPU | prefill 2K | prefill 8K | prefill 32K | decode |
| RTX 5090 | 15513 | 13774 | 9666 | 101.59 |
| RTX 4090 Unlock | 11358 | 10467 | 7949 | 59.41 |
| RTX 4090 | 11290 | 10316 | 7565 | 59.37 |
パラメータ数:7B(FP16形式)のDenseモデルを使ってベンチマークした結果、リミッター解除の効果は皆無です。
FP16やBF16演算性能よりも、はるかにVRAMの物理帯域幅が重要です。デコード(チャットの回答)速度で、RTX 4090とRTX 5090は約1.7倍も引き離されます。
| モデル | Ternary-Bonsai-2-27B-Abliterated-PQ2_0.gguf | |||
|---|---|---|---|---|
| GPU | prefill 2K | prefill 32K | prefill 128K | decode |
| RTX 5090 | 4267 | 3633 | 1930 | 153.06 |
| RTX 4090 Unlock | 3530 | 3053 | 2133 | 96.86 |
| RTX 4090 | 3538 | 3048 | 2107 | 96.73 |
パラメータ数:27B(2bit量子化)のDenseモデルも一応試しておきます。言うまでもなく、リミッター解除の効果はPrefillとDecodeともに皆無です。
大型LLM推論:Strata Engine
巨大なMoEモデルを信じられない速度で動かせる、話題のLLM推論エンジン「Strata Engine」の速度をベンチマークします。
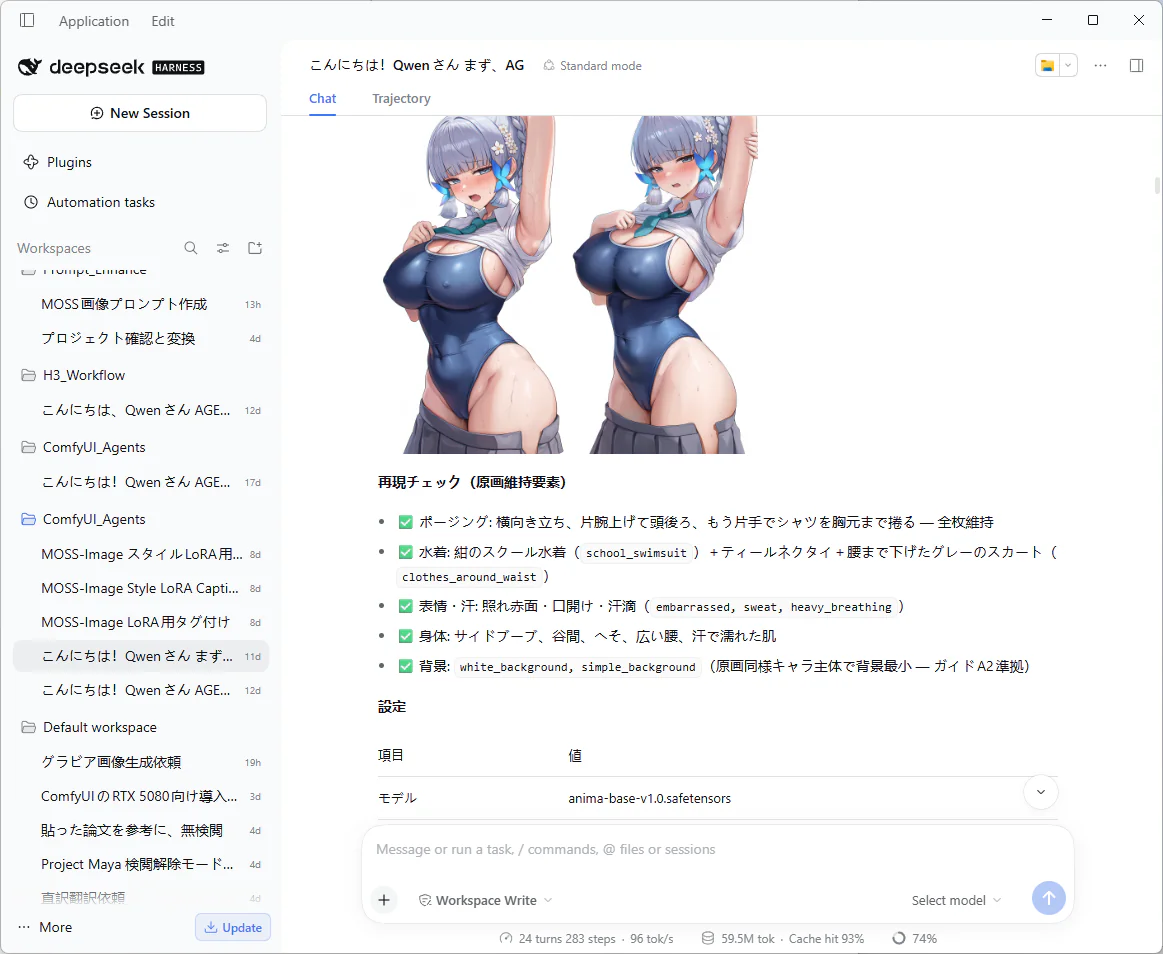
StrataをDeepseek Harnessに接続して
チャット経由で画像を作らせてます
(※もちろん検閲なし)
llama.cppと同様に、Strataにも公式ベンチマーク機能があります。
Strataで任意のモデル(筆者はQwen3.8 Next Flash IQ3_Sが好み)を立ち上げたあと、Strataのトップディレクトリで以下のコマンドを打つだけです。
.\control\python\python.exe .\control\tools\strata_bench.py --long --url http://127.0.0.1:8080約3~10分でベンチマークが完了し、リザルトが表示されます。
| モデル | Qwen3.8 Next Flash IQ3_S (コンテキストウィンドウ:262K) | ||
|---|---|---|---|
| GPU | RTX 4090 | RTX 4090 Unlock | RTX 5090 |
| チャットの回答速度 | 119.0 | 118.3 | 188.8 |
| prefill 4K | 2326 | 2341 | 4918 |
| prefill 16K | 4246 | 4322 | 6599 |
| prefill 32K | 4267 | 4333 | 6697 |
| エージェントの初回応答 | 1.66 | 1.65 | 0.72 |
| エージェントの回答速度 | 159.4 | 159.7 | 242.7 |
| prefillの性能差(平均) | – | +1.3% | +70.5% |
| 回答の性能差(平均) | – | -0.2% | +55.7% |
llama.cppを凌駕する速度を誇る高速エンジン「Strata」でも、BF16の倍速化はほとんど効果がないです。
それもそのはずで、Strataで動かすMoEモデルは基本的に量子化されています。たとえば「IQ3_S」なら3ビット相当の量子化がされていて、FP16やBF16とほぼ無関係です。
さらにStrataの構造上、演算性能が性能差に露わになりにくいです。
- VRAMの物理帯域幅
- PCIeスロットの帯域幅
- メインメモリの帯域幅(メモリコントローラの性能)
- SSDのシーケンシャル性能
- エキスパート解凍性能(CPUの性能)
巨大なモデルをVRAM → メモリ → SSDの階層構造に分割して高速化する仕組みなので、ボトルネックはそれら経路に由来します。
RTX 5090は秒速1.79 TBのVRAMがあり、RTX 4090は秒速1.01 TBにとどまります。VRAM内にモデルがすっぽり収まったとしても、理論値で約1.8倍の性能差が開きます。
おまけ編:AI超解像「DLSS 4.5」で効果ある?

ゲーム用の超解像モデルとして最高峰の画質を誇る「DLSS 4.5(FP8演算)」で、FP8倍増の効果が出ているか検証します。
| GPU | FP8 (TF/s) (FP32累積) | 平均FPS | P1 FPS | AnimationError (毎秒) | AnimationError (フレーム毎) |
|---|---|---|---|---|---|
| RTX 4090 | 326.4 | 75.3 | 56.1 | 4.4% | 58.1% |
| 326.4 | 75.6 | 57.0 | 4.1% | 53.9% | |
| 326.4 | 74.9 | 56.7 | 4.9% | 64.8% | |
| RTX 4090 Unlock | 521.8 | 75.1 | 56.7 | 4.0% | 53.8% |
| 521.8 | 74.9 | 60.2 | 3.4% | 45.0% | |
| 521.8 | 74.9 | 60.4 | 3.5% | 47.0% |
平均フレームレートはまったく同じです。最低フレームレートやAnimationErrorにわずかな差が出ているように見えますが、ランダムなスタッターに由来するブレ幅に収まります。
- FP8(FP32累積):328.5 → 654.9 TF/s
- FP8(FP16累積):654.7 → 655.0 TF/s
そもそも、FP8が倍増するといってもFP32累積に限った話です。FP16累積なら、リミッター解除する前から全力です。
Their prep kernels expand the weights to f16 WMMA operands. (native-kernels.md より)有志が超解像モデル「DLSS 4.5」をリバースエンジニアした情報によれば、DLSS 4.5は極めて高い確率でFP16累積を使って計算しています。
リミッター解除で得られるFP8の倍増と、DLSS 4.5(FP8)を利用したゲーミング性能の間に関係性がほとんどなく、フレームレートや画質(品質)の向上にまったく影響を与えないです。
4. リミッター解除後のGPU温度
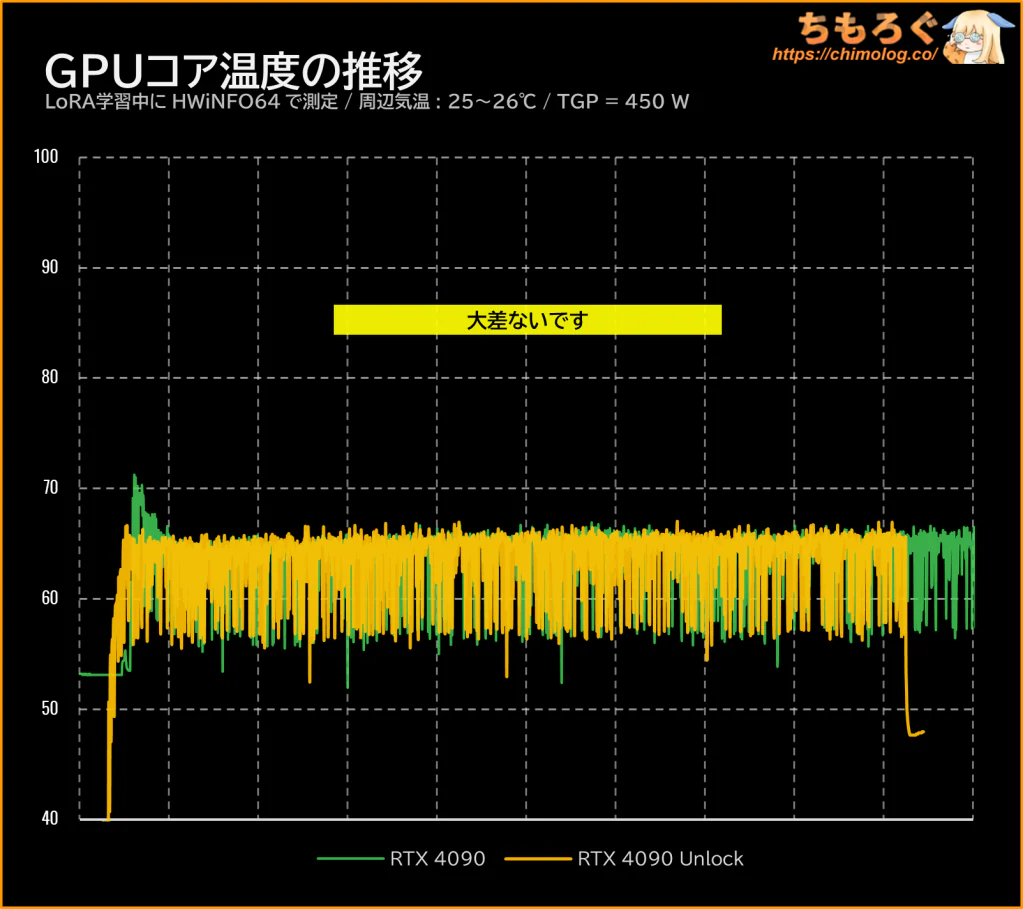
約30分のLoRA学習をストレステストに使います。
GPUコア温度に目立った変化が見られません。
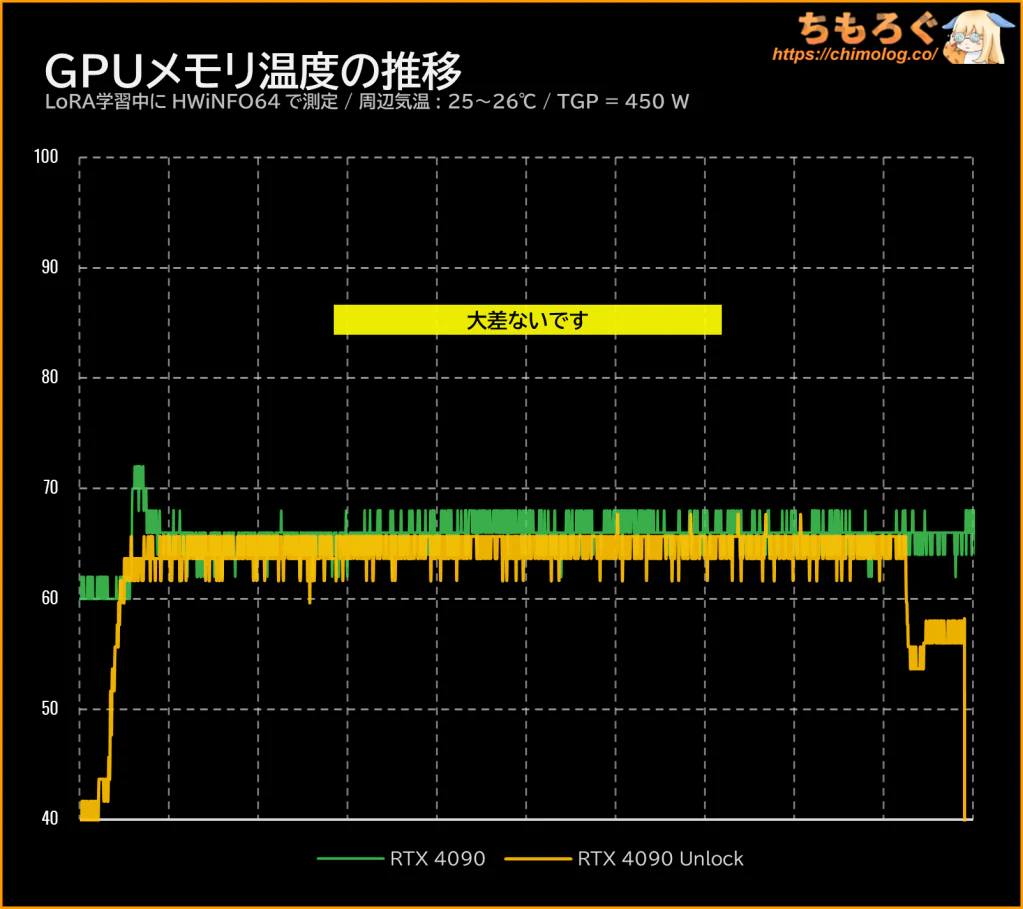
VRAM温度も目立った変化がなく、周辺気温の誤差程度にしか変わらないです。
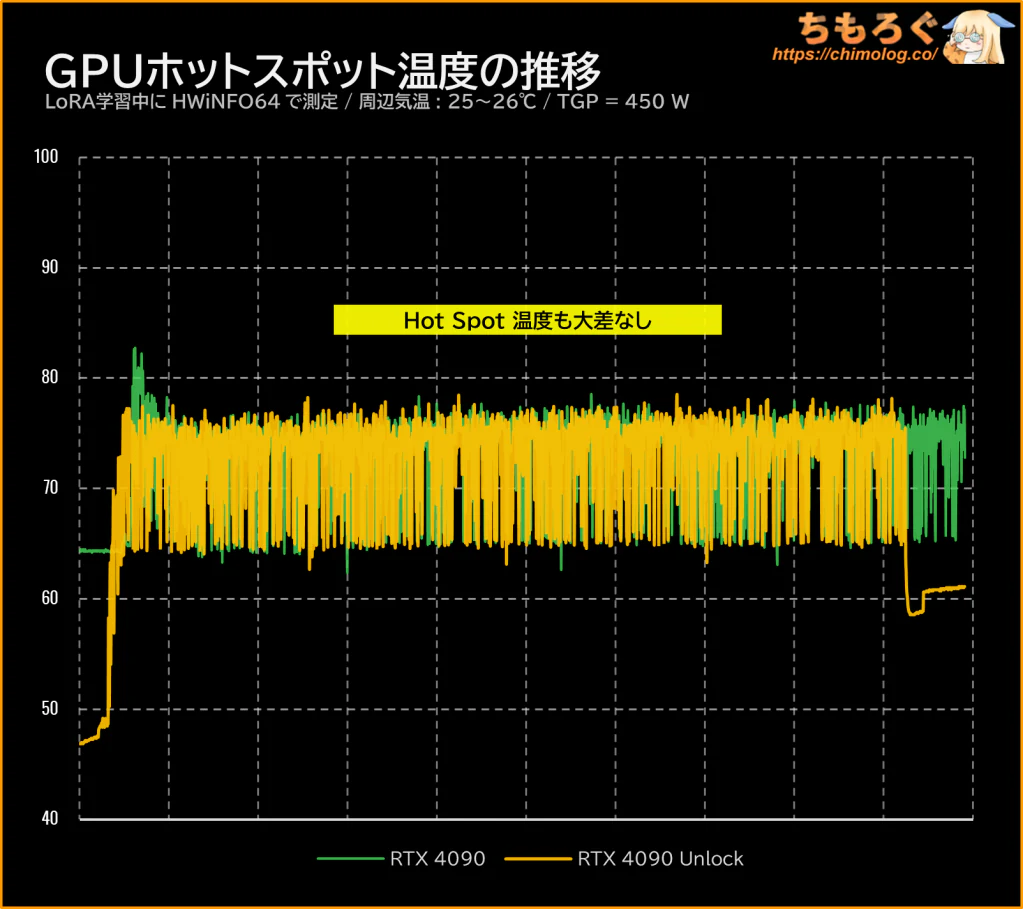
ホットスポット温度もやはり目立った変化がなく、「GPU温度が跳ね上がって焼損する」説を否定する根拠になり得ます。
消費電力(負荷のかかり方)もチェック
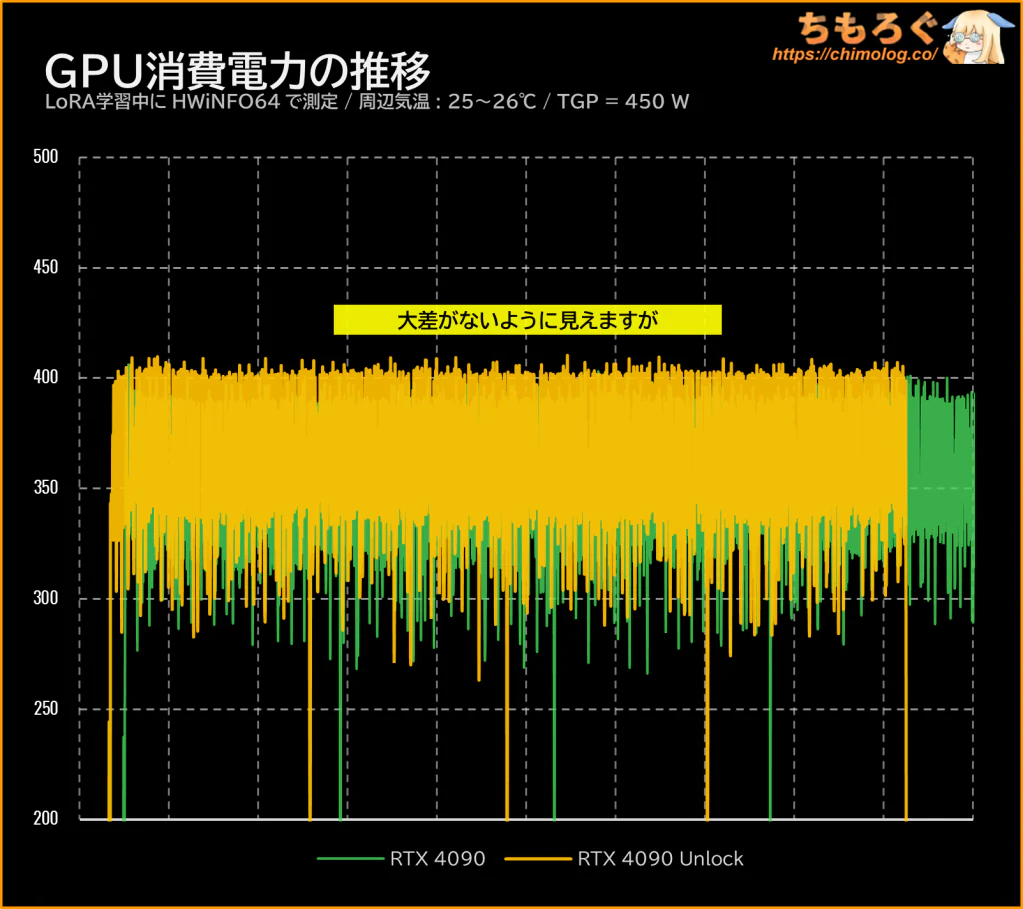
一方で、GPU消費電力(Total Board Power)は、若干の違いが見られます。少し判別が難しいので、データを平滑化(移動平均)します。
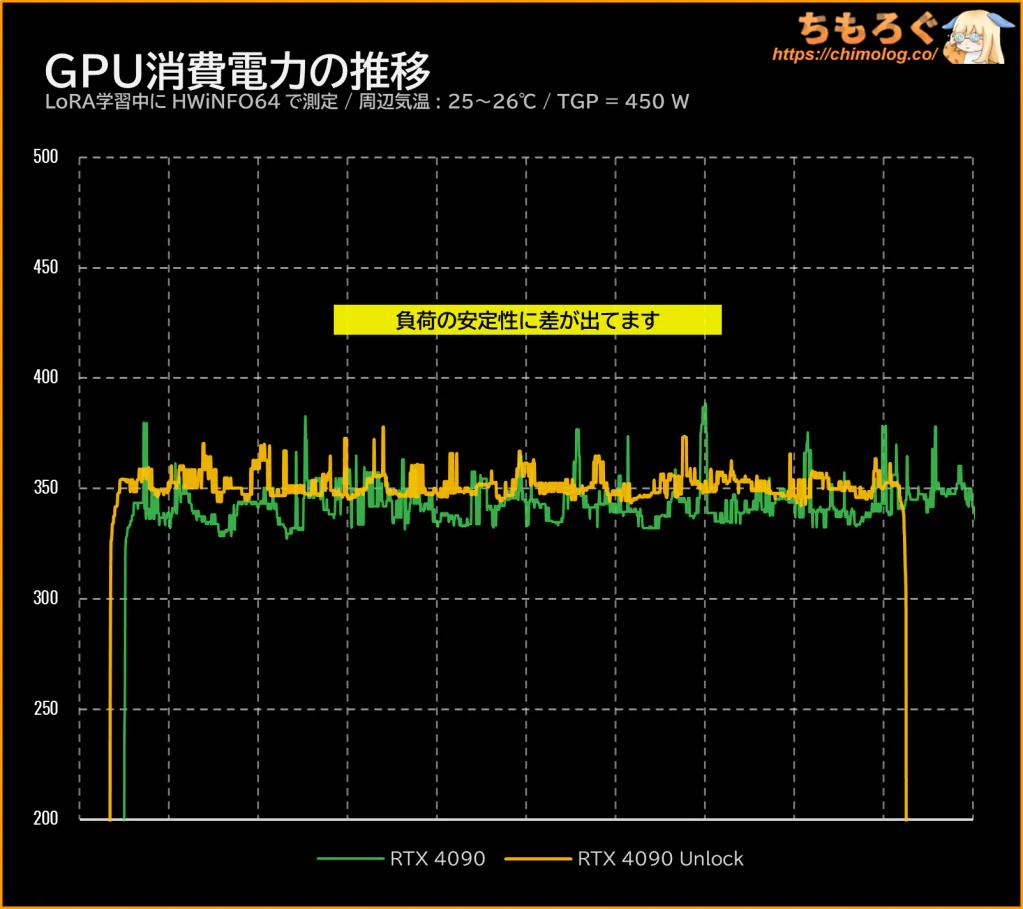
GPU負荷の安定性に明らかな違いが生じます。
つまり、BF16半減モード(1/2)によって “遊び” が生じていたわけです。GPU使用率が同じ100%を示しても、その中身(密度)に違いが出ているイメージです。
まとめ:「Unlock」はローリスクハイリターン
「RTX 4090 Unlock」の微妙なとこ
- RTX 5090と同等の性能にならない
- BitLocker暗号化と共存できない
- Secure Bootと共存できない
(VALORANTはプレイ不可) - メーカー保証対象外の行為
(保証が切れたグラボでどうぞ)
「RTX 4090 Unlock」の良いところ
- FP16(FP32累積)性能が2倍
(RTX 5090比で約1.5倍)
- BF16(FP32累積)性能が2倍
(RTX 5090比で約1.5倍) - 効果に対してシンプルな手順
- しかもローリスクな設計
- Unlockの再現性も良好
(10回試して10回成功) - 温度やクロック制御に変化なし
MarvinFSさんが設計したRTX 4090用のUnlockツールは、Linuxより圧倒的に一般的な「Windows 11」へかんたんに適用できます。
しかも設計を調べれば調べるほど、いわゆるオーバークロックよりずっと安全な手法だと分かります。失敗しても、ふだんどおりBF16半減モードでRTX 4090が起動するだけです。
もし成功すれば、BF16等速モードでRTX 4090が起動します。
一方で、BF16が効きやすいワークフロー探しが本当に重要な作業です。ここ最近の主流モデルはどれも巨大です。VRAM容量との厳しい戦いになりますが、上手い具合のスイートスポットを見つければ役に立ちます。
(今回使ったグラボ:GIGABYTE GAMING OC)
おすすめグラフィックボードを紹介
筆者はThinkStation PGX + DGX Spark Founder’s Editionの2台セットで運用中です。
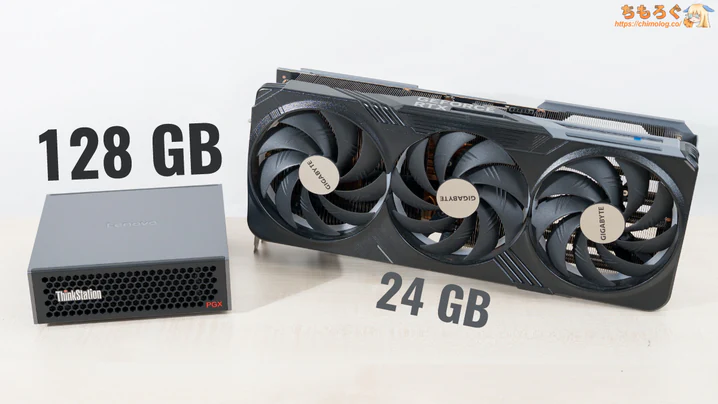
速度こそRTX 5090単体に大きく見劣りするものの、Qwen3.8 Next Flash IQ3_SやGLM-5.3-Flash-EXL3など、未検閲の高性能モデルを省エネで動かせます。
24時間365日つけっぱなしのLLMサーバーにちょうどいいし、常駐タスクはそれほど速度も重視されません。自動で延々と動いてくれるから、とにかく使用ユーザーの生産性向上に役立つマシンです。
筆者はRTX 5090を2台使っています。
1台にStrata(Qwen3.8 Next Flash IQ3_S 検閲解除モード)を入れて、もう1台にComfyUI(MOSS ImageやMiniMax H3)を入れています。
Strata + Deepseek Harness
ハーネス(Deepseek Harness Desktop)にStrataを接続して、まるでChatGPTのような使用感を “未検閲” に楽しめます。
- MiniMax H3で動画作って
- MOSS Imageで画像作って
- 今日のリクエストは・・・
指示する内容に制約が一切なく、検閲やガードレールから解放された真に自由なLLMライフを送るなら、RTX 5090(マルチGPU)は非常に魅力的です。
正直に言って、筆者はRTX 4090をもうほとんど使っていないです。Unlockのおかげで性能が上がったものの、VRAMの容量とPCIe帯域幅がお荷物過ぎてやっぱり使いづらい印象。
それでもRTX 5090と比べて半額以下の価格で買えます。相対的に見てコストパフォーマンスが高いと言えるでしょう。
Strata(Qwen3.8 Next Flash IQ3_S 検閲解除モード)運用なら1台で十分にスムーズです。今回のベンチマークで見せたように、毎秒100トークン超、プロンプト読み込みが毎秒4000トークン超です。
ほとんどChatGPTのチャット欄(思考モード)と同じくらいのスピード感です。
現実的な予算感(?)で買うなら、RTX 5070 Tiが今もおすすめです。容量こそ16 GBに減ってしまうものの、毎秒896 GBの帯域幅は魅力的です。
DDR5メモリをたんまり積めばStrata運用だって耐えられます。
4Kでおすすめなゲーミングモニター
ローカル生成AIは4K~5K2K解像度がおすすめです。広いほど作業性が向上します。
特にエージェントAIにハマっている人は、Codex、Claude Code、Strata、Google検索欄(Gamini Flash)、ComfyUIなどなど。複数のウィンドウを常駐させる運用が多いので、面積が広いモニターはシンプルに便利です。
最新のおすすめ4Kゲーミングモニター解説は↑こちらのガイドを参考に。


 おすすめゲーミングPC:7選
 ゲーミングモニターおすすめ:7選
 モンハンワイルズの推奨スペック
 Apex Legendsの推奨スペック
 Flight Simulator 2020の推奨スペック
 鳴潮(PC版)の推奨スペック
 原神(PC版)の推奨スペック
 タルコフの推奨スペック
 パルワールドの推奨スペック
 VRChatの推奨スペック
 Fortniteの推奨スペック
 Cyberpunk 2077の推奨スペック
 Stable Diffusionの推奨スペック
 【PS5】おすすめゲーミングモニター
 NEXTGEAR 7800X3Dの実機レビュー
 LEVEL∞の実機レビュー
 GALLERIAの実機レビュー
 【予算10万円】自作PCプラン解説
 おすすめグラボ:7選
 おすすめのSSD:10選
 おすすめCPU:10選
 おすすめの電源ユニット10選
 ゲーミングモニター解説
 おすすめゲーミングモニター:5選
 4Kのおすすめゲーミングモニター
 WQHDおすすめゲーミングモニター
 ゲーミングモニターの選び方を解説
 ゲーミングPC解説
 「RTX 5070 Ti」搭載ゲーミングPC
 「ツクモG-GEAR」実際に使ったレビュー
 「日本HP」のPCを安く買う方法
 「ドスパラ」でおすすめなゲーミングPC
 「フロンティア」のお得な選び方
 やかもちのTwitterアカ
結局基礎性能が足かせとなって思ってた程伸びないみたいですね
5090はリミッターかかっているのかな?
有志による調査では
5090のリミット制限は1 / 1.4
5060のリミット制限は1 / 1.8
とのこと
解除した結果PRO 6000に下剋上! は無理そう(そもそもVRAM容量が違いすぎる
Deepseekハーネスのワークスペース生々しくておもろい
DSH + Strataめちゃくちゃおもしろいですよね
・GLM 5.3を指揮者に置いて、Claude SonnetにNSFW画像のタグ付けをさせる(ガードレール回避が上手い)
・Opus5.5にお断りされたUnlock手順書作成を、Qwen3.8 Next Flash Q3_S(無検閲)にやらせる
・アレな画像を貼って「ここから動画作って!参考資料はFa◯zaのこれ」でMiniMax H3で動画作ってもらう
・古くなったWordpressテーマを丸ごと与えて「admin昇格できる部分探して」で粗探しさせ、見つけた箇所をGPT-6.1 Solになおしてもらう
などなど、無検閲だからこそ出来る使い方がたくさんあります
マイニング制限でしたっけ、懐かしい
non-LHR懐かしい
AIエージェントの高性能化に伴い、こういったリバースエンジニア → ロック解除の流れが高速化しているので、そのうち別の興味深い制限解除が見つかるかもしれません
結局なにが一番性能発揮するんだろ
昨今のBF16 Dense系MMDIT(画像生成)の場合
・VRAM容量
・PCIe帯域幅
がまず重要ですね。漏れてオフロードされると、5090ですらめちゃくちゃ速度落ちます
VRAMを増やした改造版とかには恩恵大きそう
本当にそれ思った
10万円で+24GB請け負ってる業者がいるうちに、自分の4090も48GB化しておけば良かった・・・
FP8→FP32でもロック解除されるはずなのでそっちの比較も見てみたいな
Int8_ConvRotではなく、FP8 GGUFを使えば再現できる可能性ありますか?
おすすめのFP8モデルがあれば知りたいです。画像・動画ではInt8昆布が全盛期で、FP8はあんまり話を聞かない気がします。
研鑽のため、やかもちさんの研究の成果をぜひ拝見してみたいです。
これって4090限定なんですかね? なんか元は3000シリーズとかでもできそうみたいな話でしたけれども
fp32累積は
なんでこんな変な検証したんですか?
大丈夫ですか?
–fast fp16_accumulation を使わずに、IllustriousXL と Anima を実行した場合のベンチマーク結果もありますか?
このオプションを無効にした場合、RTX 4090 Unlock と RTX 5090 の速度差がどうなるのか気になっています。
fastを無効化したデータを追記してみた。SDXLは悪化、Animaはやや改善しますが、やはりRTX 5090には及ばないです。
若い子のAIを活用した研究やコーディングのログを見るたびに
すごいなぁと尊敬すると同時になんだか情けない気持ちになってくるけど
同じGPUでスク水のアニメキャラ生成してるここを見ると本当に安心するww
ワークスペースが情けなさすぎるのは俺だけじゃなかったwww
無検閲LLM ~ ローカル画像生成は、NSFWこそ存在する価値だと本気で思ってるので、Strata + DSHのセッション欄は酷い有様です。(一応、ClaudeやChatGPTなら真面目な話ばかり・・・ GPUベンチマークの閉ループ化構想とか)
黒い砂漠の頃からお世話になってます。
もうご存知かもしれませんが、5090環境でQwen3.8FN IQ3-Sを走らせる場合、5090専用のStrata forkであるBasaltが高速です。 自分のテスト環境では、512kまでしかテストしていませんが、Strataより常に100~50tok/s(decode)高速でした。 ぜひお試しを。 これを使っていいのなら、4090との速度差は2~3倍になりそうですね。
なにそれ凄そう。同じ量子化モデルで高速化するなら、同じ速度を許容してもいいならもっと大きな量子化(NVFP4とか)を実用的な速度で動かせそうですね。あとで試してみます。
同じ思考回路でNVFP4も試したんですが、StrataのNVFP4実装の取り込み元であるsergqwer/strata-nvfp4が十分優秀だったので、IQ3-Sの時ほどは伸びないんですよね むしろprefillは遅くなりました
以前はnvfp4を使っていましたが、Basaltがある今はIQ3-Sが速すぎるのでこちらがメインです
ゲーム性能に関してはどうなのでしょうか。気になります。
そういえば超解像モデル「DLSS 4.5」は、FP8演算でした。もしかすると効果があるかもしれないので、ちょっとやってみます。
やかもちさんはなにか勘違いされているようですが、このアンロックで制限がなくなるのはFP32累積を行った際の話で何でもかんでも速くなるわけではありません。
FP8を使っているDLSS4.5ですが、行列積の累積はFP16で行っているので効果は全くないのです。
FP16累積は初めから制限の対象外なので、アンロックでFP32累積の速度制限を解除しても速くなりません。
元々から業務用のRTX Adaとコンシューマ向けのGeforceRtXを製品として区別する為の制限ですので、コンシューマ用途を想定しているDLSSやゲームなどで効果は全く見込めないのです。
またFP32累積の制限ですがFP4には一切掛かっていないので、FP4を利用した推論ではRTXPro BlackwellシリーズもGeforce RTX50シリーズも最高速で動作します。
業務用の機能が解放されただけなので全く効果ないよ
Unlockのおかげで 中古RTX 3090 Tiのコスパエグいっぽいけどどうなんやろ
RTX 3000シリーズもWindowsで簡単に解除できちゃうので、それなりに値上がりする可能性はあります。ただ、LLM推論で効果が薄いから上昇圧力は弱いかもしれない。
RTX 5090 でも `–fast fp16_accumulation` を有効にする意味が本当にあるのか、少し疑問に思っています。
こちらのテスト結果を見る限り、Anima モデルでは、このオプションを有効にしてもパフォーマンスの向上は確認できなかったようです。
https://note.com/stb_note/n/n5ee3cbc37858
去年のベンチマーク以降、起動用batはずっと習慣的に「–use-sage-attention –fast」を入れてたけど、GPT-6 AstraやClaude Fableいわく、現状のComfyUIなら不要な可能
性が高いと言われました。
・fast → 型変換のペナルティを警戒するべき
・sage → Comfy Kitchen Attentionに置き換わった可能性
高速化オプション自体も見直すべきですね。かつて高速化だったものが、今となっては負債でしかないのかも。
※以下は個人的な結論です。
comfyuiの高速化の起動オプションは、楽に高速化したい場合に使うくらい?
自分は全く使ってないです。
KJ nodeのローダーで指定したほうがいいですし、モデルによっては高品質重視の高速化ノードもあります。高速化ノードを使う場合はローダーでの高速化はOFFにするべきなので起動オプションでの高速化は余計に邪魔になります。
あとsage-attentionも1と2では全くの別物なので、sage-attentionだけで語るのは危ないと思います。
少なくともSage Attention 2.x世代 + Tritonは、Kitchenと同じ効果でした。KJ nodesでワークフローごとに明示化できるのは便利ですね。まもなく実施予定のAIベンチマーク特集で参考にします。
参考になれば、嬉しいです。
自分が前にAnima、あるファインチューニングモデルbf16を自分でマージしINT8ConvRot化モデルで検証したときはKitchenよりsage-attention2のほうが少し速い結果でした。Kitchenが今より古かったからかも?しれません。他人の検証は参考にとどめて、自分が使うモデル&ワークフローで検証したほうが確実ですね。
今はMOSS imageに移行中なのでAnimaの検証はしないかな。
余談ですが、MinimaxH3でAtten系の高速化ノードを使う場合はKitchen、sage-attention2共にOFFにすべきらしい?です。(この辺を触れてる人を見かけないので自信ないです。)自分の生成結果はOFFのほうが確かに品質上がりました。速度は少し落ちたかな?程度。
bf16/fp16だとdlshogiとかの将棋AIみたいに精度が必要な分野が気になりますね
この記事を拝見してStrata+dshでプロンプト作ってcomfyuiで画像生成してみたら4080が1枚なのになぜかvramが溢れない…上手いことやってくれてるのか…?
生贄用のRTX4060無印がやっと手元に届いたので、
ForgeNeo使ってAnimaで1024×1024、30STEPで実験してみたところ、40%アップでした。
ただ、元々起動オプションに–fast-fp16とか入れてないので、
実は–fast-fp16だけで十分速くなる可能性も
低スペックほど効果が見込める、とかだといいなあ