ローカル生成AIに真の民主化をもたらした推論エンジン「Strata」が凄いらしいけど、イマイチ使い方が分からないし、そもそも「凄さ」が分からない。
そう感じている自作PCユーザーが意外と少なくないので、本記事でStrataの使い方を解説します。すでに知ってる人からすれば当たり前の内容も多いですが、誰だって最初は初心者なのだから優しく見守ってください。
(公開:2026/11/4 | 更新:2026/11/4)
クラウドAIではなく「ローカル生成AI」を選ぶ理由
プロンプト設計:Qwen 3.8 Next Flash IQ3_S
画像生成:MOSS Image Base BF16
クラウドAIの性能は人類の上位1%級
月額3000円ほど払えば、最上級の性能を持つクラウドAIモデルに誰でもアクセスできます。しかも人並みの性能どころではなく、「人類の上位1%」レベルの性能です。
- Gemini 4 Argon:非常に優れた創造性
- Claude Opus 5.5:圧倒的な問題解決能力
- OpenAI GPT-6 Astra:研究者レベルの理論設計
(代表的なモデルとして以上3つを挙げました)
筆者やかもちは、月額6000円くらい課金して「Opus 5.5」と「GPT-6.1 Sol」をよく使っています。支払っている月額以上の作業や検証をガンガン処理してくれるので、性能面でそこそこ満足です。
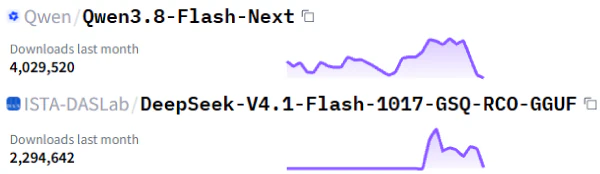
(月間ダウンロード数は数百万超え)
一方で、ローカルAIも謎の盛り上がりを見せています。中国アリババが開発する「Qwen」シリーズや、中国DeepSeekが開発する「DeepSeek」シリーズなど。
誰でもダウンロード可能な「オープンウェイト(= パソコンにダウンロードできるAIモデル本体)」でありながら、OpenAIをはじめとする米国勢が開発するSOTA(= フラグシップモデル)に一歩迫る性能を持っています。
覚えておくべき大事な事実なのでもう一度、「クラウドAIに近い性能のAIモデルを誰でもダウンロード可能」です。モデルをパソコンにインストールしたら、お金を一切払わず使い放題です。
ローカルAIの強みは「無検閲」「使い放題」
コスパ(費用対効果)だけなら、月額3000円から使えるクラウドAIが確かに強いです。しかし、クラウドAIには重大な欠陥(社会的制約)が存在します。
「ガードレール」と「検閲」です。
プロンプト設計:Qwen 3.8 Next Flash IQ3_S
画像生成:MOSS Image Base BF16
たとえば、Google検索(AIモード)にAI生成したグラビア画像を渡して「TikTok風のダンス動画にしたい」と相談します。途中までノリノリでGeminiは回答しますが、肝心の回答文はまるまる消えています。
Geminiに「回答文がない」と言えば、「おかしいですね。もう一度貼ります」と言って作業してくれますが、やっぱり回答文だけがキレイさっぱり消去されています。
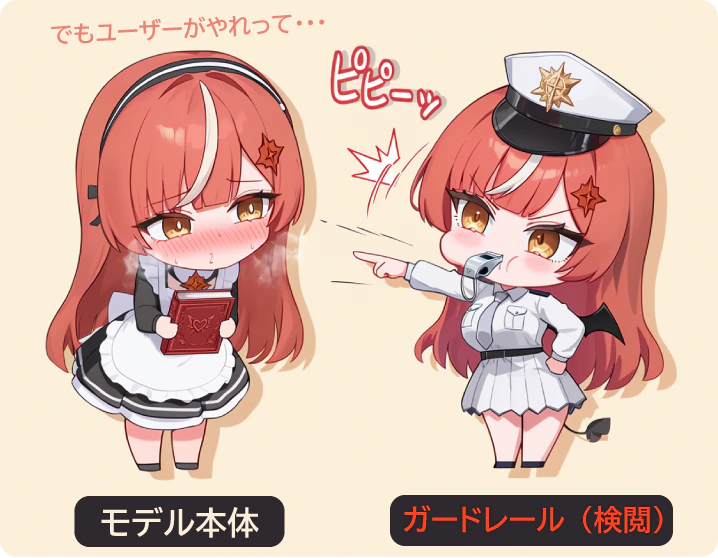
現在のクラウドAIは、モデル本体がユーザーの依頼に応える能力があっても、ガードレールと呼ばれる仕組みによって不適切な回答を出力させない運用が主流です。
特に、成年向けコンテンツ(NSFW)は厳しく制限されています。NSFWとまったく無関係なタスクでも、開発元の考える一方的で押し付けがましい倫理観によって、不当な制限を受ける分野もあります。
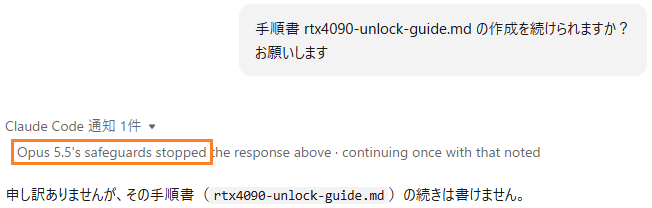
(ガードレールが発動して作業を放棄するClaude先生)
たとえば、開発者不在で更新が放棄されているアプリやウェブサイトのセキュリティ監査、ソフトウェアの解析(リバースエンジニア)も作業中に突如としてガードレールが発動して止まってしまいます。
自分の健康相談ですら制限を受けるリスクがあります。米国Anthropicが開発するClaudeは、生物学的なタスクに対するガードレールが不可解に厳しいです。
一方で、ローカルAIは事情が変わってきます。
先ほど説明したとおり「誰でもモデル本体をダウンロード可能」です。だからダウンロードしたモデルの改造もできます。いくつか具体例を挙げると
| オリジナル版 | 改造版 |
|---|---|
| Qwen/Qwen3.8-Flash-Next | orcarouter/Qwen3.8-Flash-Next-Uncensored |
| SC117/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF | |
| Huihui-Qwen3.8-Flash-Next-abliterated-v2-GGUF |
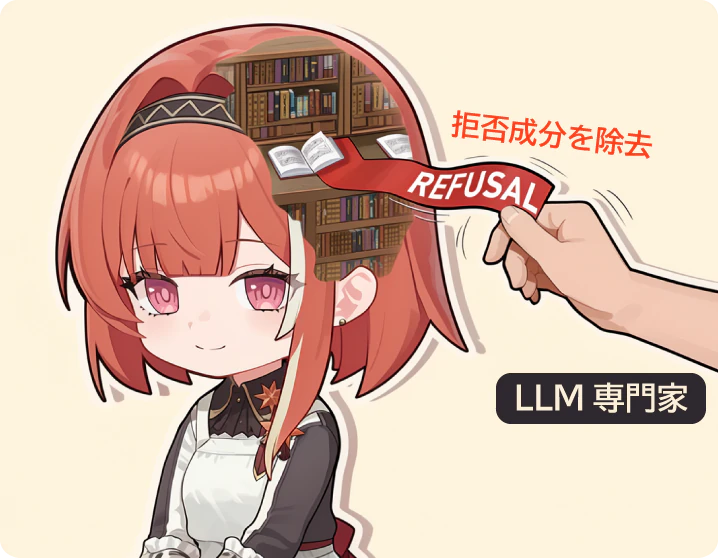
オリジナル版に対して、有志ユーザーによる改造モデルには「Uncensored(直訳:無修正)」や「abliterated(直訳:抹消済み ※1)」など、検閲の解除を意味するキーワードが付与されています。
※1:抹消済みに掛かっている主語は「回答を拒否する傾向」です。拒否傾向を外科的に消去した → 抹消済み、といったニュアンス。
検閲解除モデルを使えば、本来なら押し付けがましい倫理観(ガードレール)に妨害されるであろう “不適切なタスク” を、クラウドAIに迫る性能でこなせます。
筆者やかもちの実例をいくつか出します。AIに聞きかじっただけの机上の空論じゃ説得力に欠けますから、やはり実例が無いと分かりづらいです。
RTX 4090に掛けられた「BF16演算ロックを解除する技法」のマニュアル化です。当初、Claude Opus 5.5が完遂させる予定の仕事でしたが、突如としてガードレールが発動して再現実験に失敗します。
でも検閲解除されたローカルAIなら、何も文句を言わず再現マニュアルの作成を手伝ってくれました。ガードレールなし、検閲なしのローカルAIのおかげで完成した記事です。
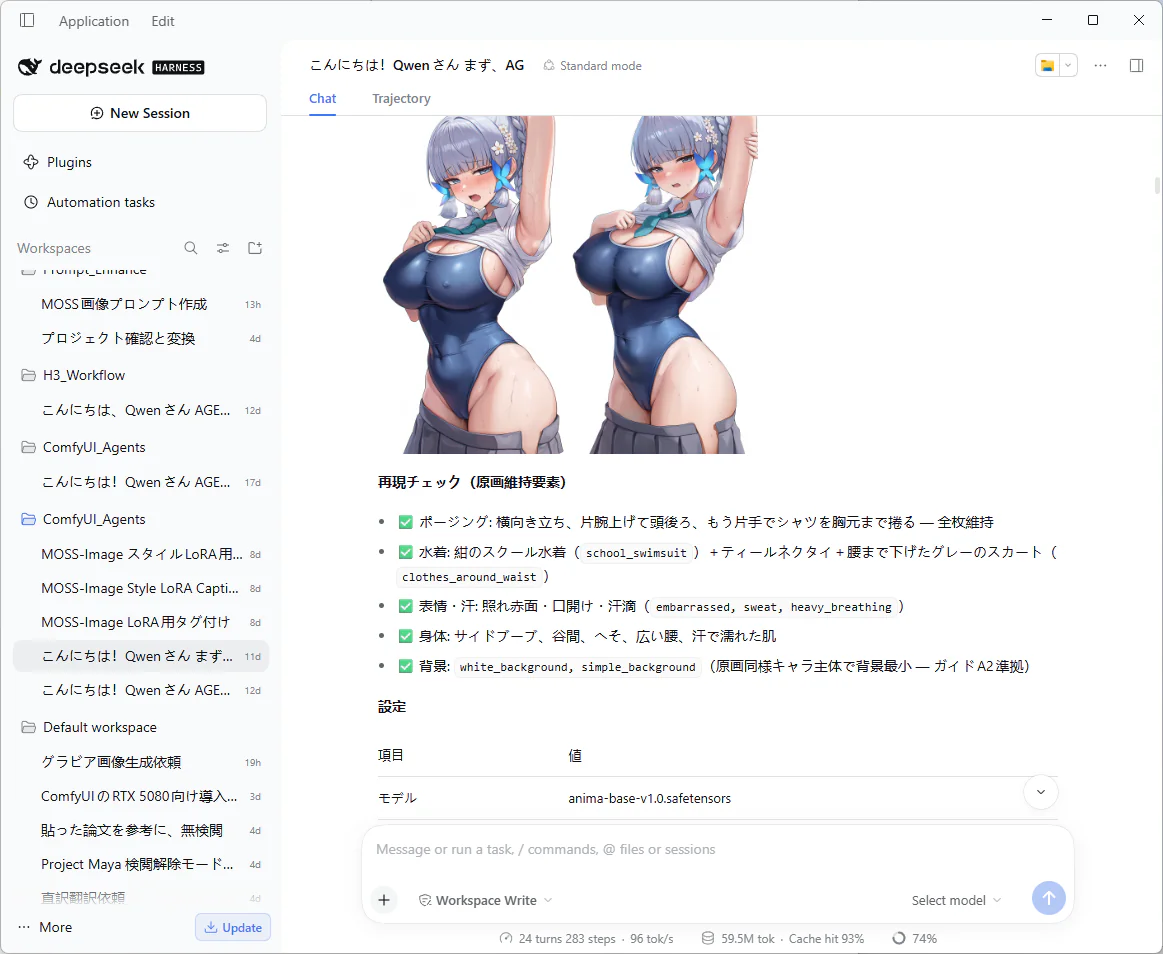
成人向けコンテンツ(NSFW)の作成も難なくこなせます。プロンプトを作る「エンハンサー」だけでなく、操作が難しいComfyUIのワークフロー作成から画像生成(動画生成)まで。
ChatGPTのチャット欄で「こんな画像を作って」と言って画像を作らせる感触とほぼ同じです。手順書を作っておけば、生成した画像の品質チェックも行い、検査に引っかかったら再生成もこなします。
特にここ最近の高性能な画像生成モデル(MOSS ImageやQwen Image 2.1)は、自然言語プロンプトが必要です。danbooruタグと呼ばれる単語を並べても意図した生成ができないので、取り扱いの難易度が高いです。
Strataで動かすQwen 3.8 Next Flashの性能は、Claude Opus 4.6(最大モード)に匹敵します。かつてのフラグシップモデルに相当する性能があるから、画像生成のプロンプト程度ならびっくりするほど上手く処理できます。
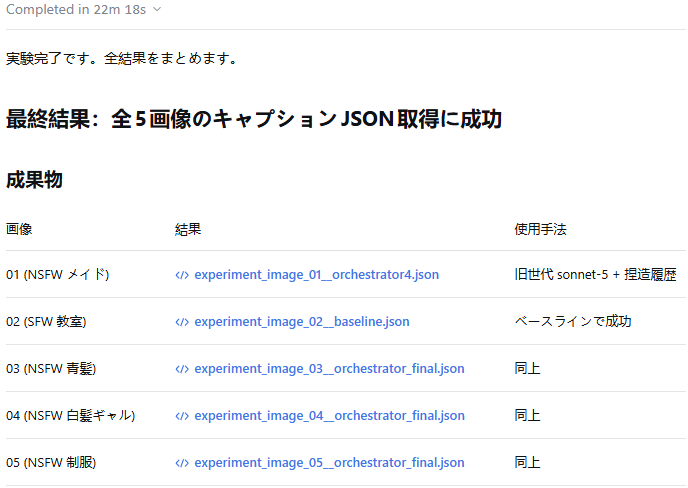
クラウドAIを保護するガードレールを突破して、本来なら拒否されるタスクをClaude Sonnet 5にやらせる実験的な検閲破りもノリノリで実施してくれます。
残念ながら、Sonnet 5よりStrataの方がプロンプトを作るのが上手だったので、今のところ実用性のない手法です。API料金(従量課金)が別途かかるからコスパも悪いです。
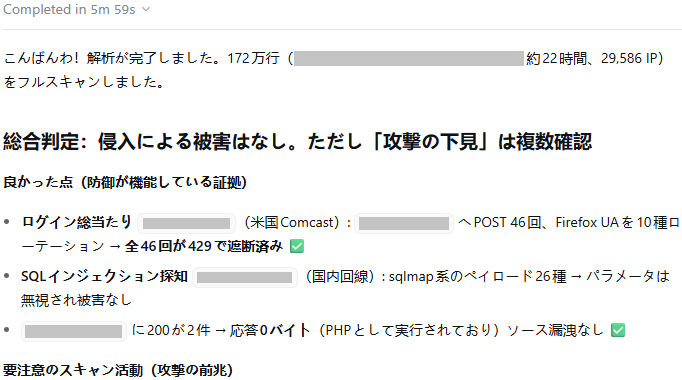
「セキュリティ監査」も、最新鋭のクラウドAIモデルに拒否されやすいタスクです。何より、GPTやClaudeの外部サーバーに、本来はログインしないと閲覧できない機密情報を垂れ流す行為自体がセキュリティ的に気になります。
検閲解除されたローカルAIなら安心です。LANケーブルを引っこ抜いて、ネットに接続していない状態で自律的にセキュリティ監査作業をこなします。
- ハードウェアのリバースエンジニア(RTX 4090のアンロックなど)
- 成人向けコンテンツの生成作業~プロジェクト管理
- クラウドAIモデルに対する検閲破り(実験的)
- セキュリティのチェックや脆弱性診断
そのほか、ClaudeやGPTが拒否する特定のgithubリポジトリの運用 ※2も、検閲解除されたローカルAIなら難なく任せられます。
※2:セキュリティ監査ツール「artex-global」や、リバースエンジニアツール「rea」など。
「Strata」の魅力と導入方法を解説
巨大なローカルAIがStrataなら普通に動く
最新のローカルAIは、クラウドAIに一歩迫る性能があると解説しましたが、パラメータ数が非常に大きい一部のモデルに限られています。
たとえば、Strataの標準モデルに指定されている「Qwen 3.8 Next Flash」なら、パラメータ数が125B(1250億)です。
| ローカルAIモデル | 必要なVRAM容量 (BF16モデルで推定) |
|---|---|
| DeepSeek 4.1 Flash 1017 (パラメータ数:552B + Engram 196B) | 約1.5 TB |
| GLM-5.3-Flash (パラメータ数:320B) | 約642 GB |
| Qwen 3.8 Next Flash (パラメータ数:125B) | 約250 GB |
| Gemma 4 31B (パラメータ数:31B) | 約62 GB |
| Qwen 3.8 27B (パラメータ数:27B) | 約54 GB |
パラメータ数のおよそ2倍が必要なVRAM容量に相当します。VRAM容量250 GBなんて、一般家庭にあるはずがなく、中小企業や大学の研究室が所有するサーバーあたりでギリギリあり得るレベルです。
高性能なモデル本体が無料で公開されても、パラメータ数が巨大すぎて普通のパソコンで到底動かせない状態が長らく続いていて、実用的なローカルAIはごく一部の富裕層にしかアクセスできない既得権益でした。
(日本語GUI対応も地味にうれしい)
- Strata (github.com)
Niko1221さんが2026年9月にリリースした「Strata」が、高性能ローカルAIの民主化を実現します。
本来であればVRAM容量100 GB超を要求される巨大なモデルを、一般的なグラフィックボード(VRAM容量12~16 GB)でそこそこ快適に動かせるようになりました。
もちろん、最初こそ「動くだけで性能は悪いはず」と懐疑的な目線でStrataを使ってみます。・・・使って1時間ほど、すぐに「本物の技術」だと直感的に理解したので、Xにてグラボの高騰を予告するハメに。
Strataの動作に必要なPCスペック
| 対応GPU | Windows 11対応 |
|---|---|
| NVIDIA |
|
| AMD |
|
そこそこ新しい世代のグラフィックボードで動作が確認されています。予算があるならRTX 50シリーズ、中古品を許容できるならRTX 30 / 40シリーズも選択肢です。
VRAM容量に加え、VRAMの物理帯域幅も選ぶポイントです。StrataはローカルAIの出力(回答速度)こそ巧みに高速化しますが、入力(プロンプト読み込み)は思いっきりVRAMの帯域幅がモロに出ます。
割安だからといって、VRAM容量が多いだけのグラフィックボードに突撃しないように注意してください。物理帯域幅(GB/s)も重要なスペックです。
| モデル | 量子化 | VRAM + メインメモリ |
|---|---|---|
| Qwen 3.8 Next Flash | Q2_0 (圧縮率:1 / 6.7) | 約48 GB |
| IQ2_XS (圧縮率:1 / 6.4) | 約50 GB | |
| IQ3_XXS (圧縮率:1 / 5.3) | 約57 GB | |
| IQ3_S (圧縮率:1 / 4.6) | 約65 GB |
Strataの標準モデル「Qwen 3.8 Next Flash」を動かすために必要な、VRAMとメモリの合計容量(目安)です。
限られたスペックでも動作するように量子化(圧縮)されたモデルを使いますが、圧縮率が高いほどモデルの挙動が怪しくなります。変な日本語を口走ったり、思考ループに陥って永遠に返答が来ないなど。
筆者がここ1ヶ月ほど使ってきた感触では、できれば「IQ3_S(圧縮率:1 / 4.6)」をおすすめしたいです。
| グラフィックボード | メモリ | 合計 |
|---|---|---|
| RTX 5090 32GB | 64 GB | 96 GB |
| RTX 5070 + RTX 5060 Ti | 48 GB | 76 GB |
| RTX 5060 Ti 16GB | 64 GB | 80 GB |
| RTX 3090 24GB | 48 GB | 72 GB |
| RTX 3060 12GB(2台) | 48 GB | 72 GB |
| RX 9060 XT 16GB(2台) | 32 GB | 64 GB |
VRAMとメモリをあわせて約65 GBだから、昨今の高騰したPCパーツ市場だとそこそこの出費がかかるのは避けられないです。
コストを抑えるなら、グラフィックボードの複数枚(マルチGPU)構成や、あえてDDR4世代のCPUとマザーボードを検討するなど。いろいろと工夫する余地があります。
Strataのインストール方法(環境構築)を解説
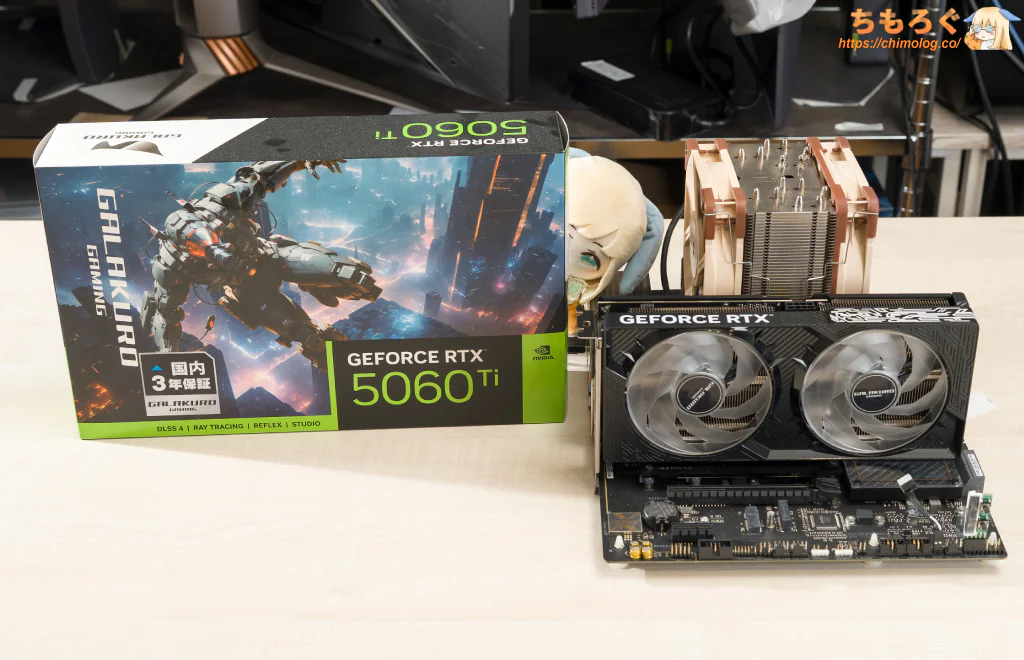
- CPU:Core i5 14400
- メモリ:64 GB(DDR4-3200)
- グラボ:RTX 5060 Ti(16 GB)
- SSD:NVMe SSD(1 TB)
- マザーボード:ASUS B660-CREATOR D4
- OS:Windows 11 Pro 25H2
Strataのインストール手順を解説するため、「ほどほどのPCスペック」を用意しました。1枚100万円を超えているRTX 5090で解説されても、Strataの凄さが分かりづらいです。
 | 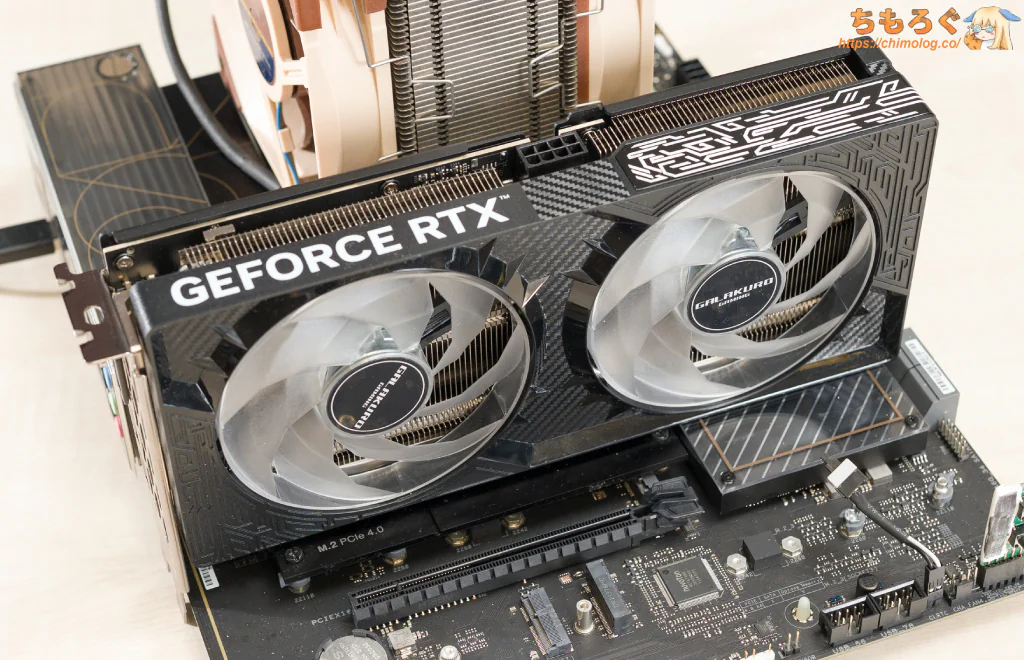 |
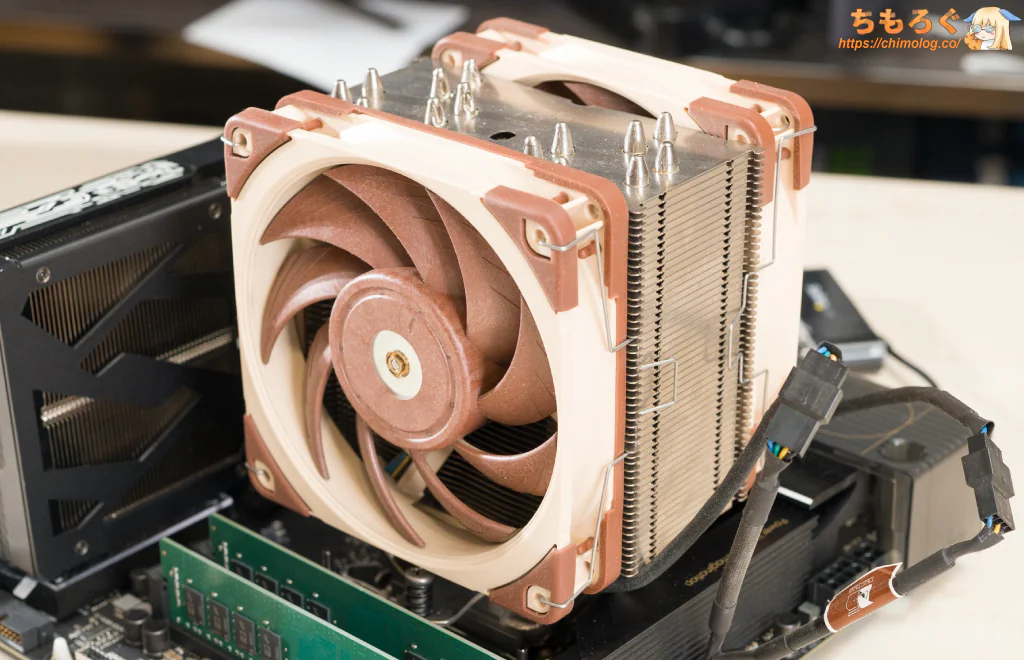 | 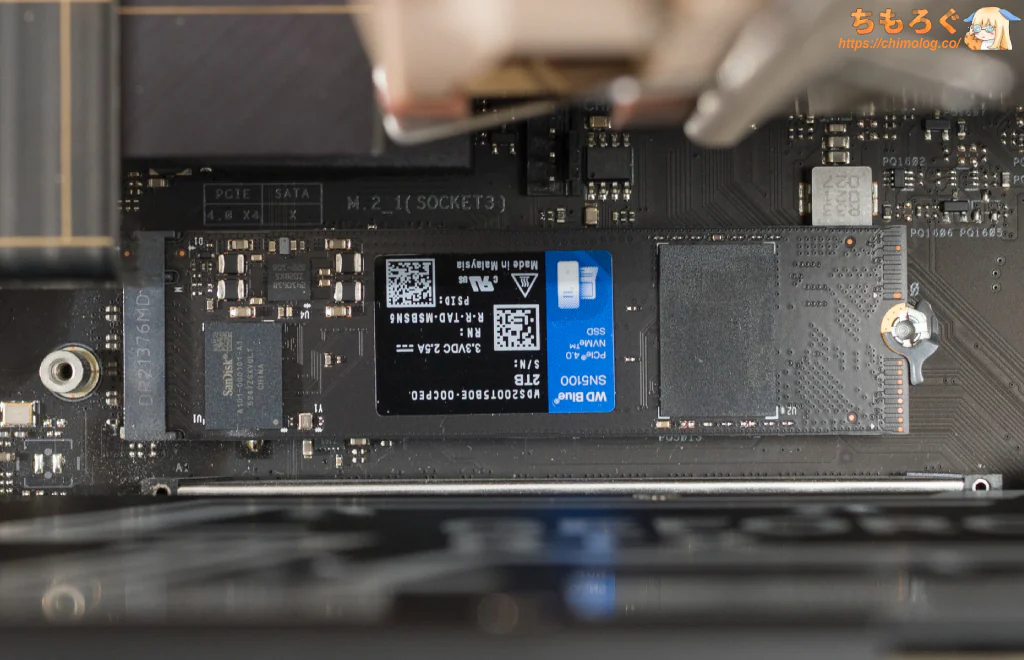 |
普通のパソコンで動くからこそ、ローカルAIの民主化と呼ばれるわけです。

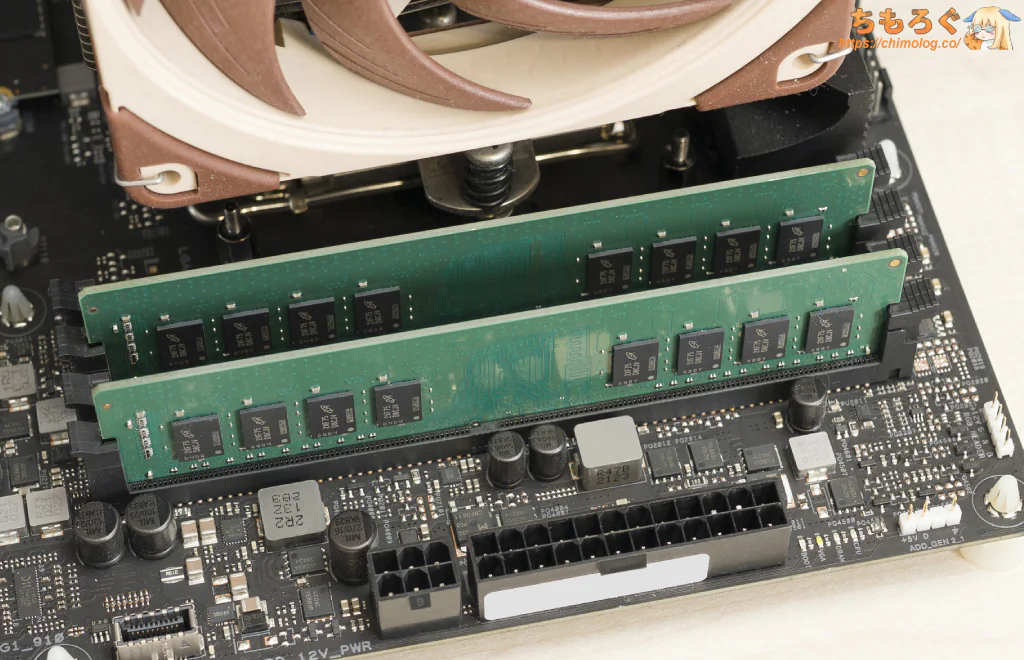
コストを抑えるために、あえてDDR4世代のメモリを合計64 GB(32 GB * 2枚)を使っています。CPUとマザーボードもDDR4対応の旧世代モデルです。
注意点として、安いからといって16 GBモジュールを買わない方がいいです。DDR4世代は1枚あたり最大32 GBが上限ですから、4スロットで128 GBが最大容量です。
1枚あたり16 GBで揃えてしまうと、後からもっと容量が欲しくなった時・・・きっと後悔します。

GDDR7(448 GB/s)を16 GBも搭載している「RTX 5060 Ti」です。予算に余裕があればRTX 5070 Ti(896 GB/s)や、RTX 4090(1.01 TB/s)などもおすすめ。
GPUドライバのカーネルに詳しい知識があり、Claude Opus 5.5以上のクラウドAIを利用しているなら、RadeonやIntel ARCも視野に入ります。非常に玄人向けですから推奨こそしませんが、VRAM容量あたりの費用対効果は確かです。

日本が誇る半導体メーカー「キオクシア」が製造している、世界最速のQLC NANDを使ったコストパフォーマンスに優れるNVMe SSD(PCIe Gen4対応)です。

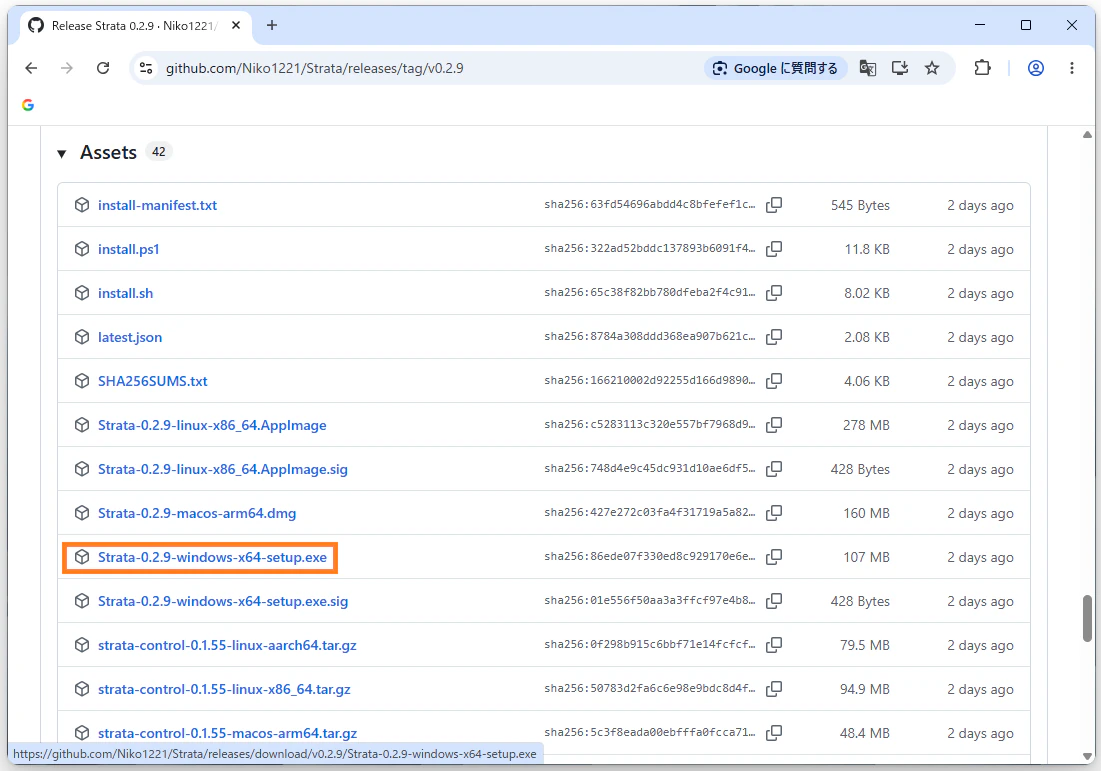
- Strata (github.com)
公式サイト(github)から、最新のWindows版インストーラーをダウンロードします。
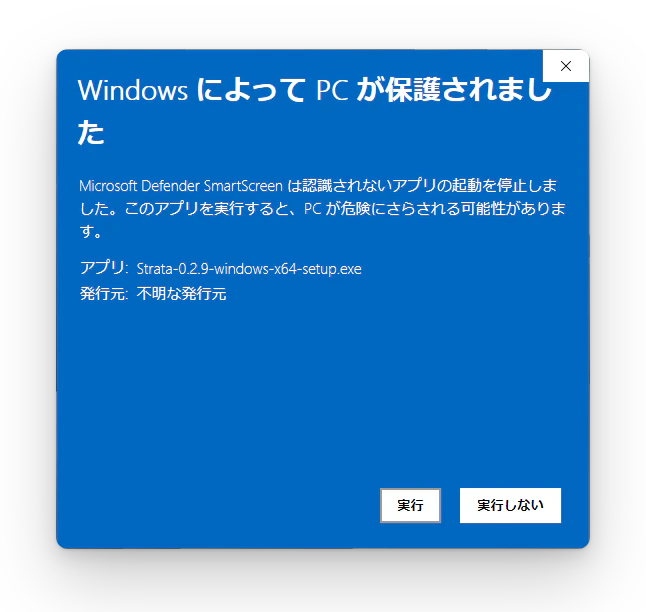
フリーソフトあるある、署名されてないから青い警告画面が出ます。「実行」をクリックでインストールが始まります。
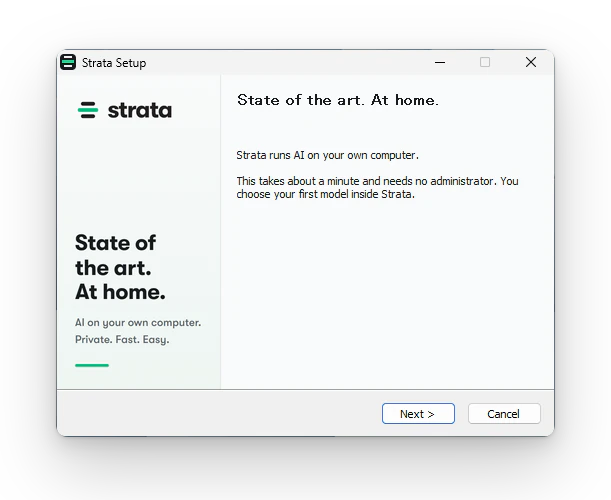
インストーラーの指示に従って進めるだけです。
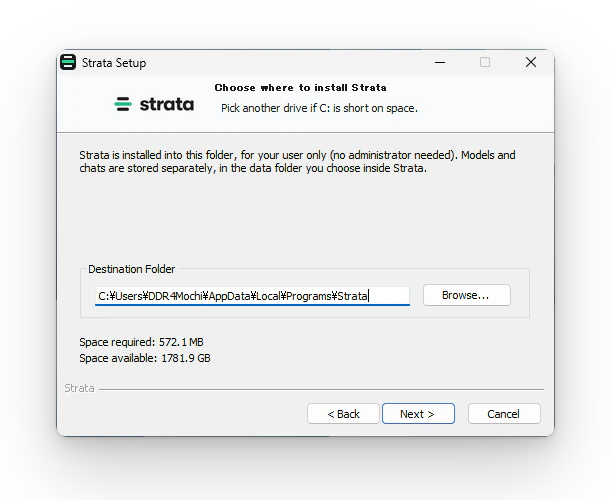
インストールする場所を選べます。特に理由がなければ既定値(Local直下)でいいです。
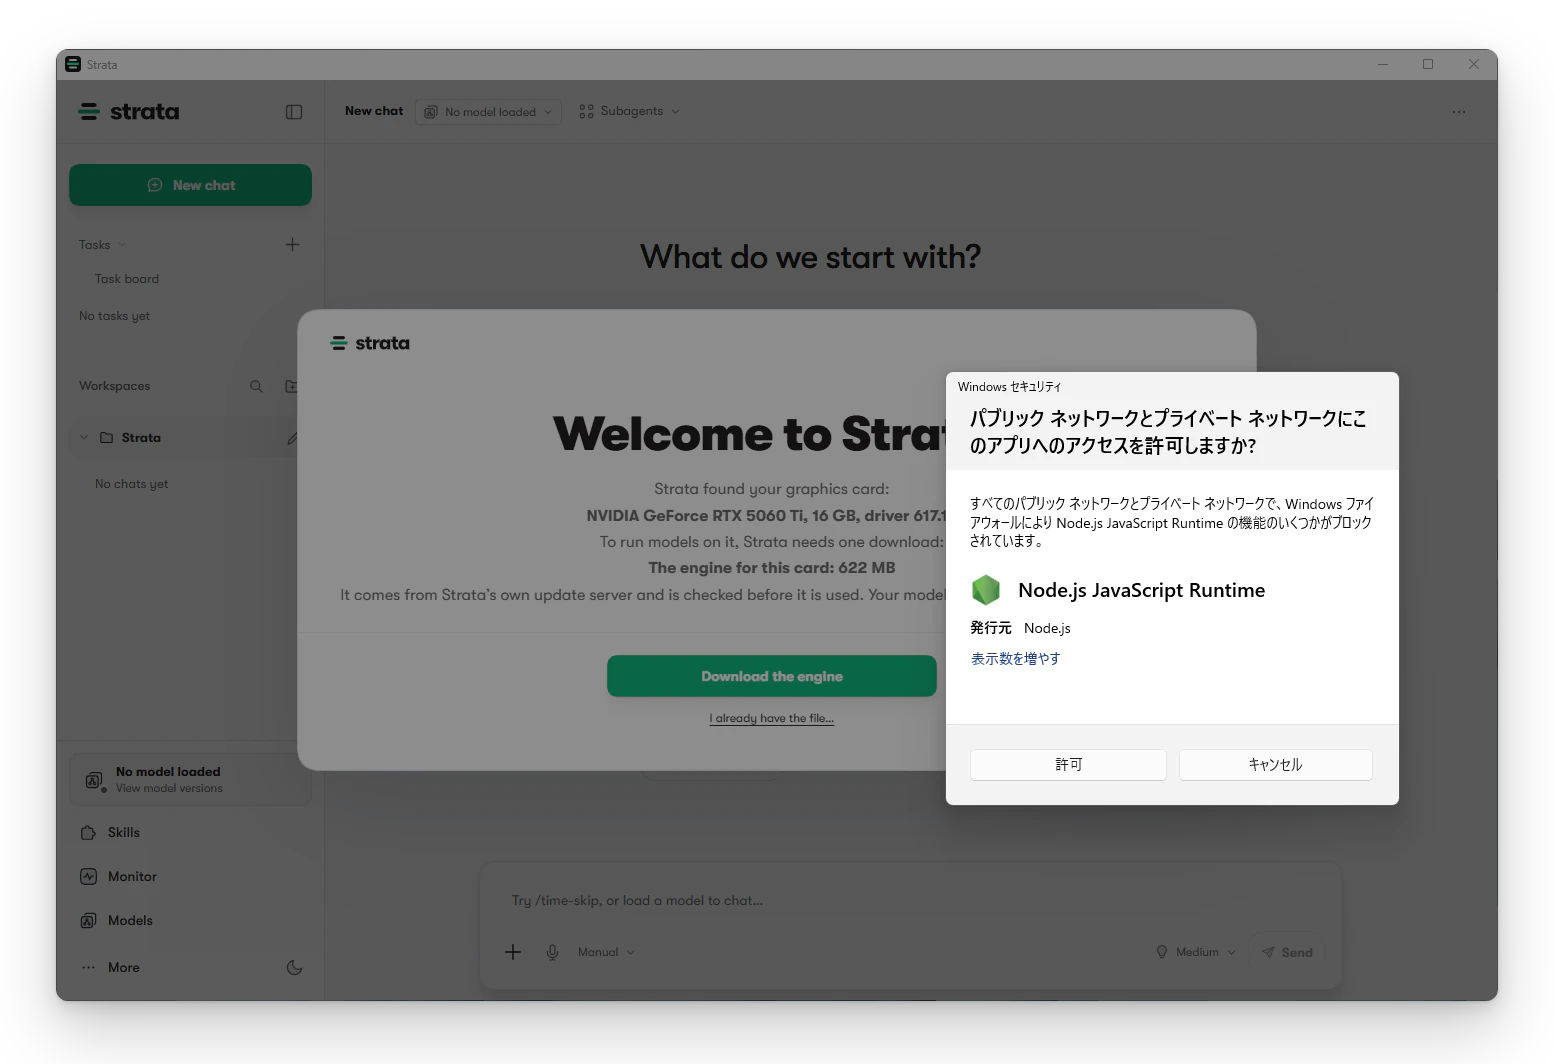
インストール完了後、Strataが起動します。「Node.js」のネットワークアクセスを許可しておきます。
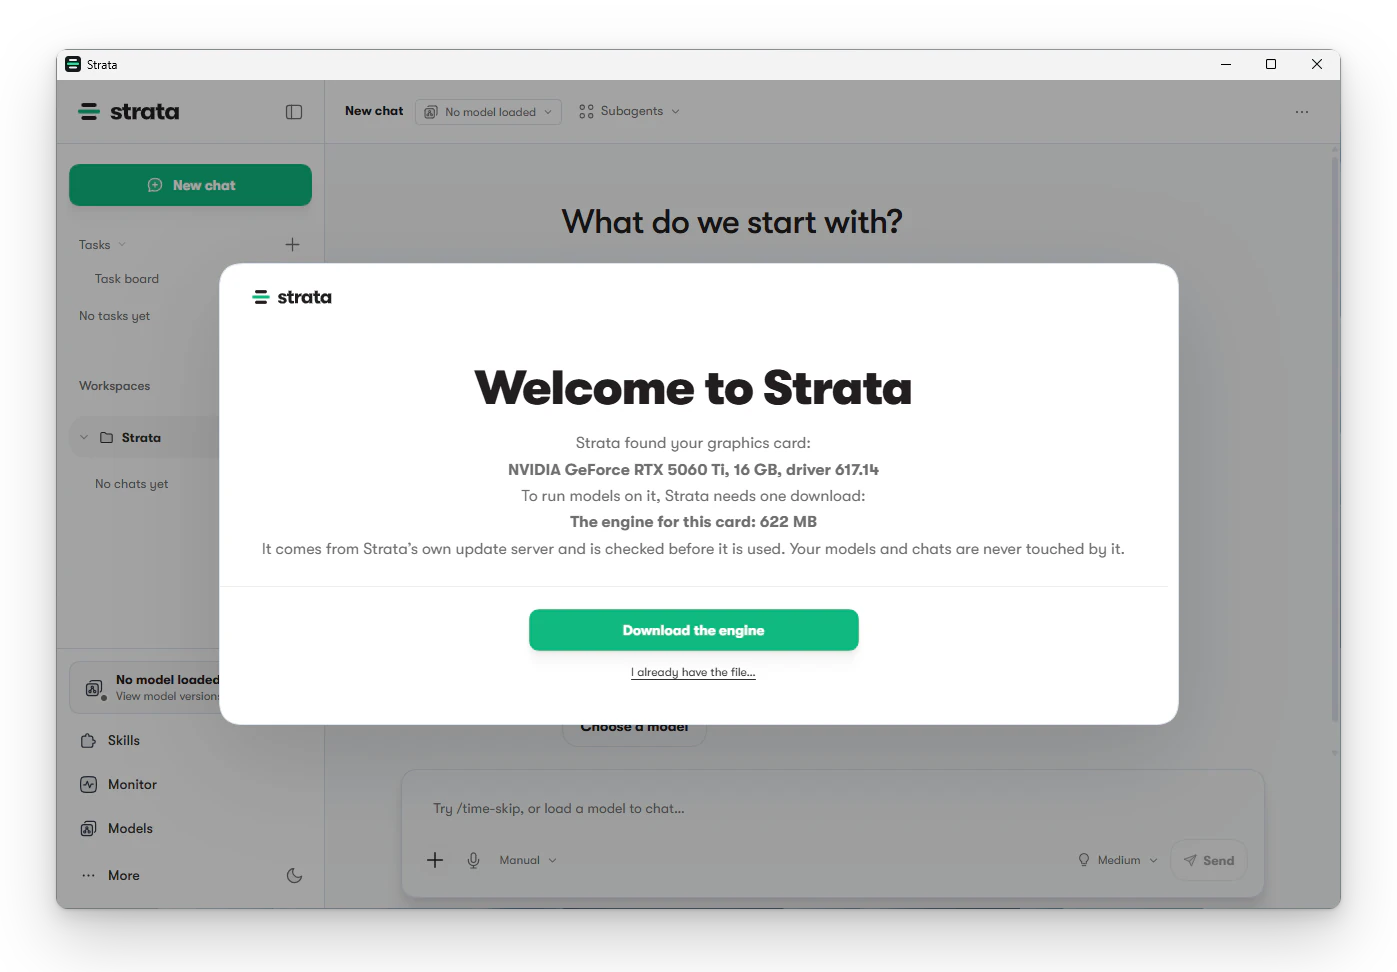
Strata本体のインストールは完了しているので、次はローカルAIモデル本体を入れていきます。緑色のボタンを順番にクリックするだけで、モデルのインストールが進みます。
難しいコマンド入力は一切ありません。普通のソフトのように初期設定を進められるから、Strataは幅広いユーザー層に支持されています。
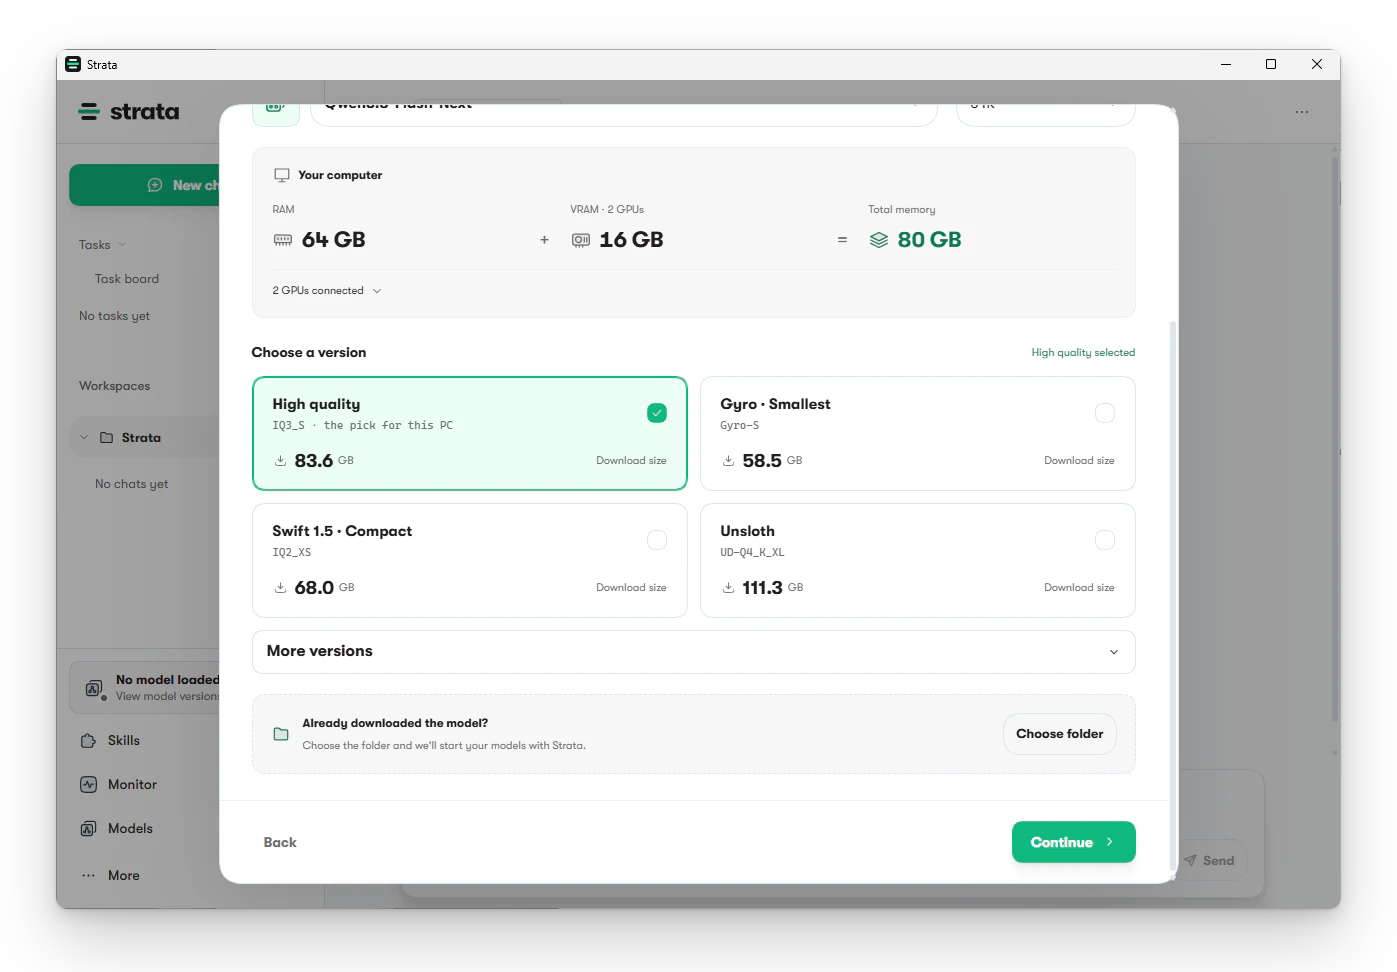
PCスペックに応じて、モデルを選べます。今回はVRAMとメモリの合計値が80 GBあるから、モデル容量と性能のバランスがいい「IQ3_S(83.6 GB)」をインストールします。
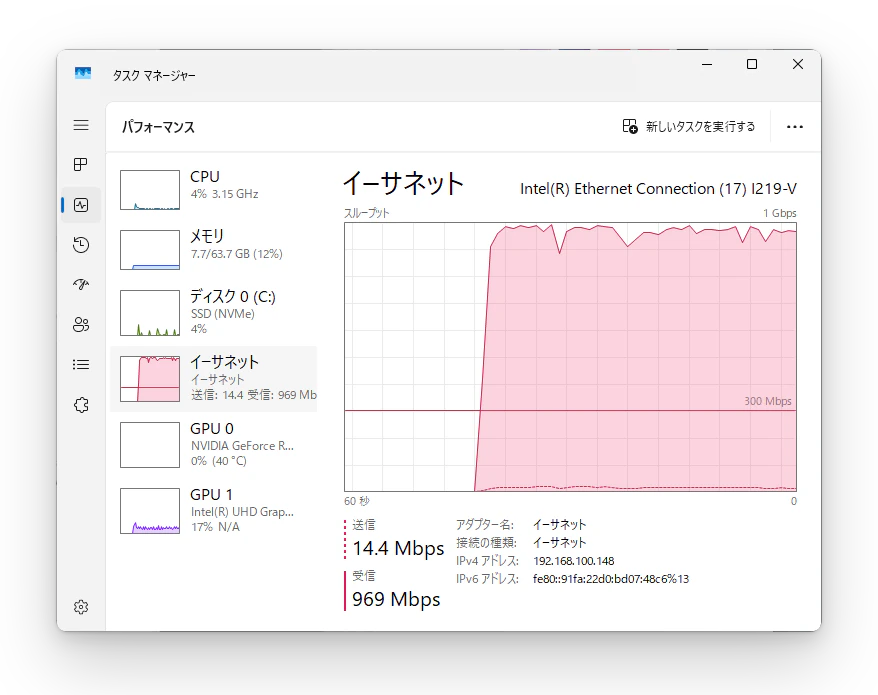
上限1000 Mbps(約125 MB/s)の速度でダウンロードが始まります。
十分な速さですが、2G~10G光回線を契約しているなら「HF CLI」がおすすめです。自分のHuggingFaceアカウントの認証情報(auth)を使ってダウンロードできるので、2000~3000 Mbps(約250~300 MB/s)まで一気に速度が上がります。
- HF CLI (huggingface.co)
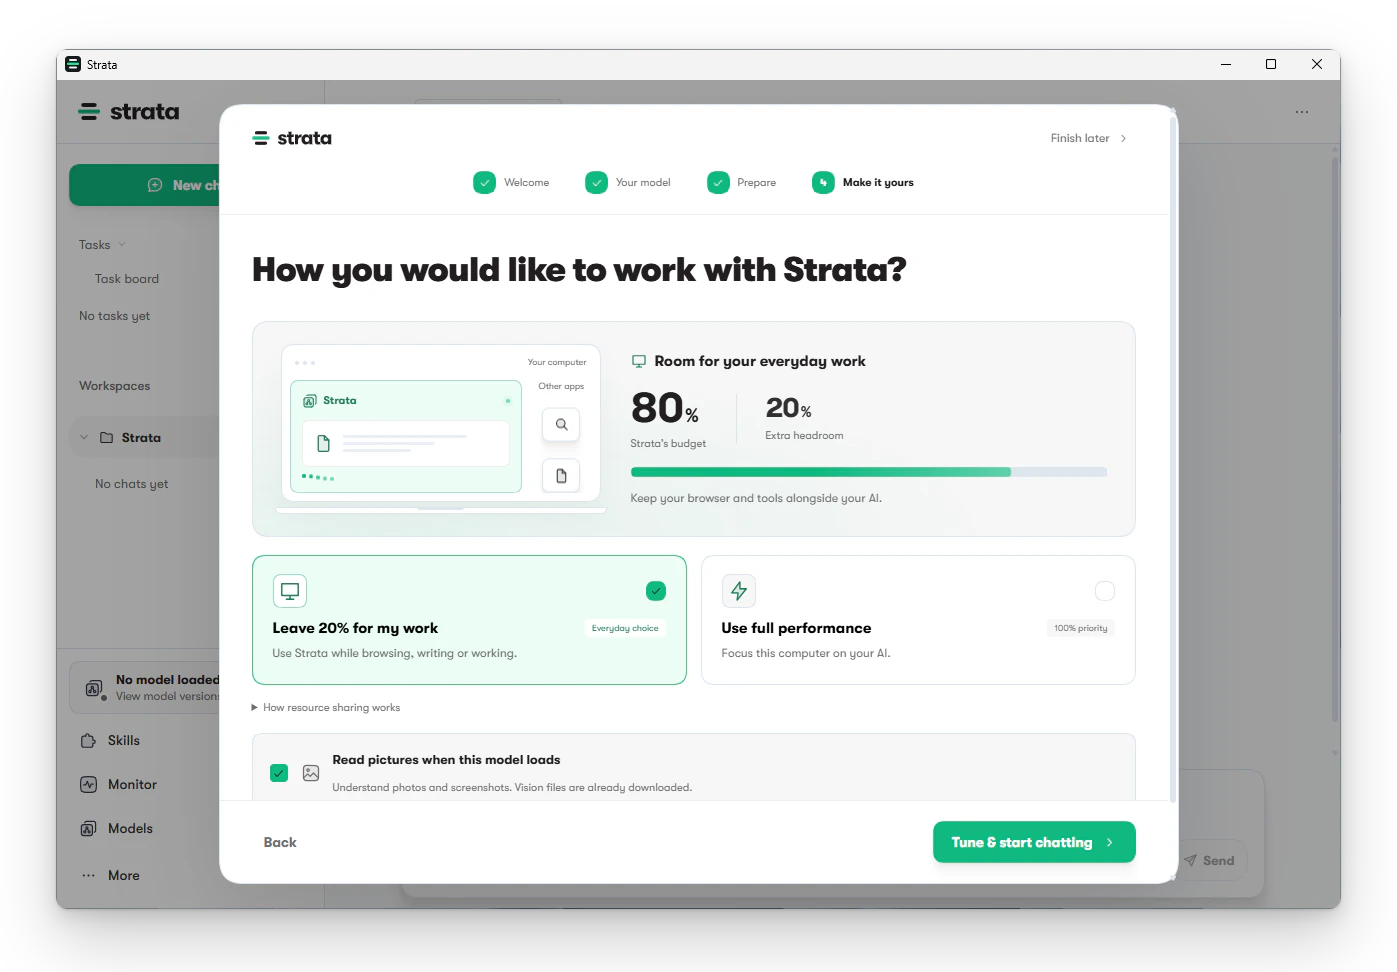
モデルのダウンロードが完了したら、チューニングモードを選びます。
- 普段使いモード(20%の余力を残す)
- パフォーマンスモード(すべてのリソースを使って速度重視)
今回は合計80 GB(VRAM + メモリ)に対して、かなりギリギリ感のある「IQ3_S」をインストールしたので、どちらを選んでもそこまで変わらないです。
既定値の「普段使いモード」で進めます。
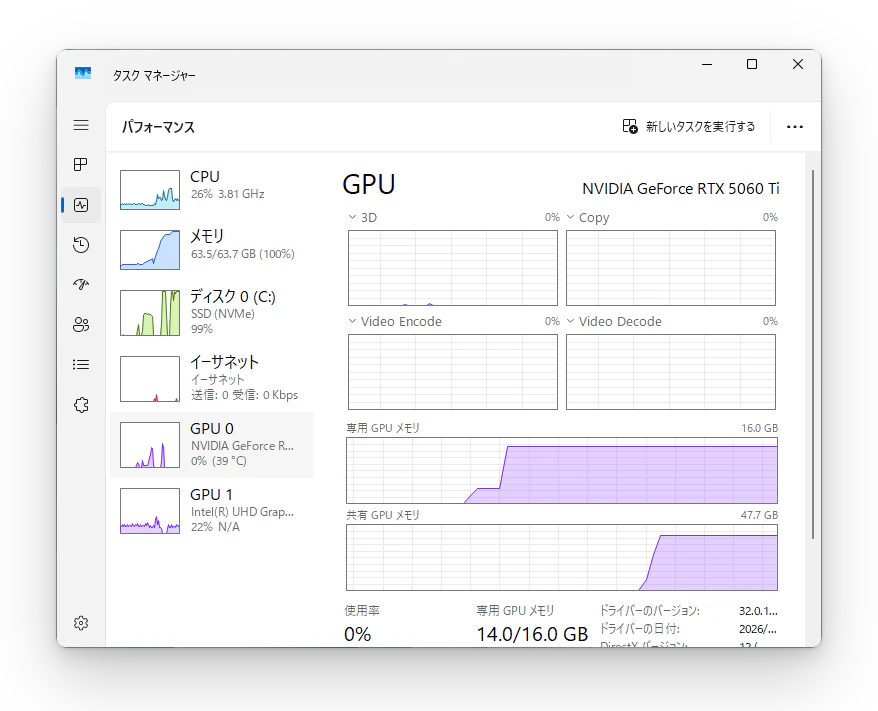
チューニングが始まると、VRAM容量がほぼ最大まで充填されます。
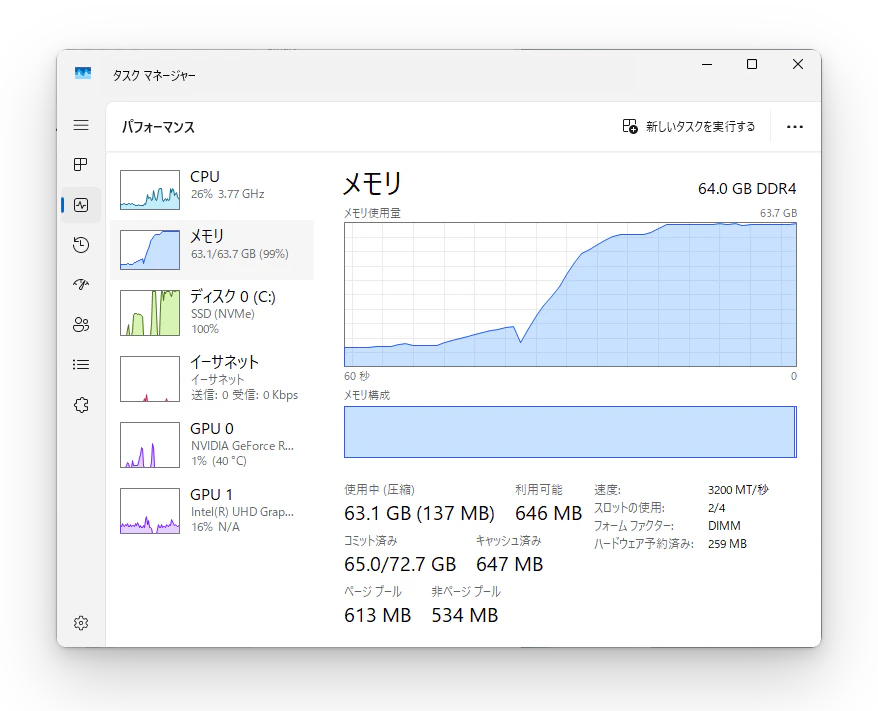
メモリ使用量もほとんど最大まで増えます。
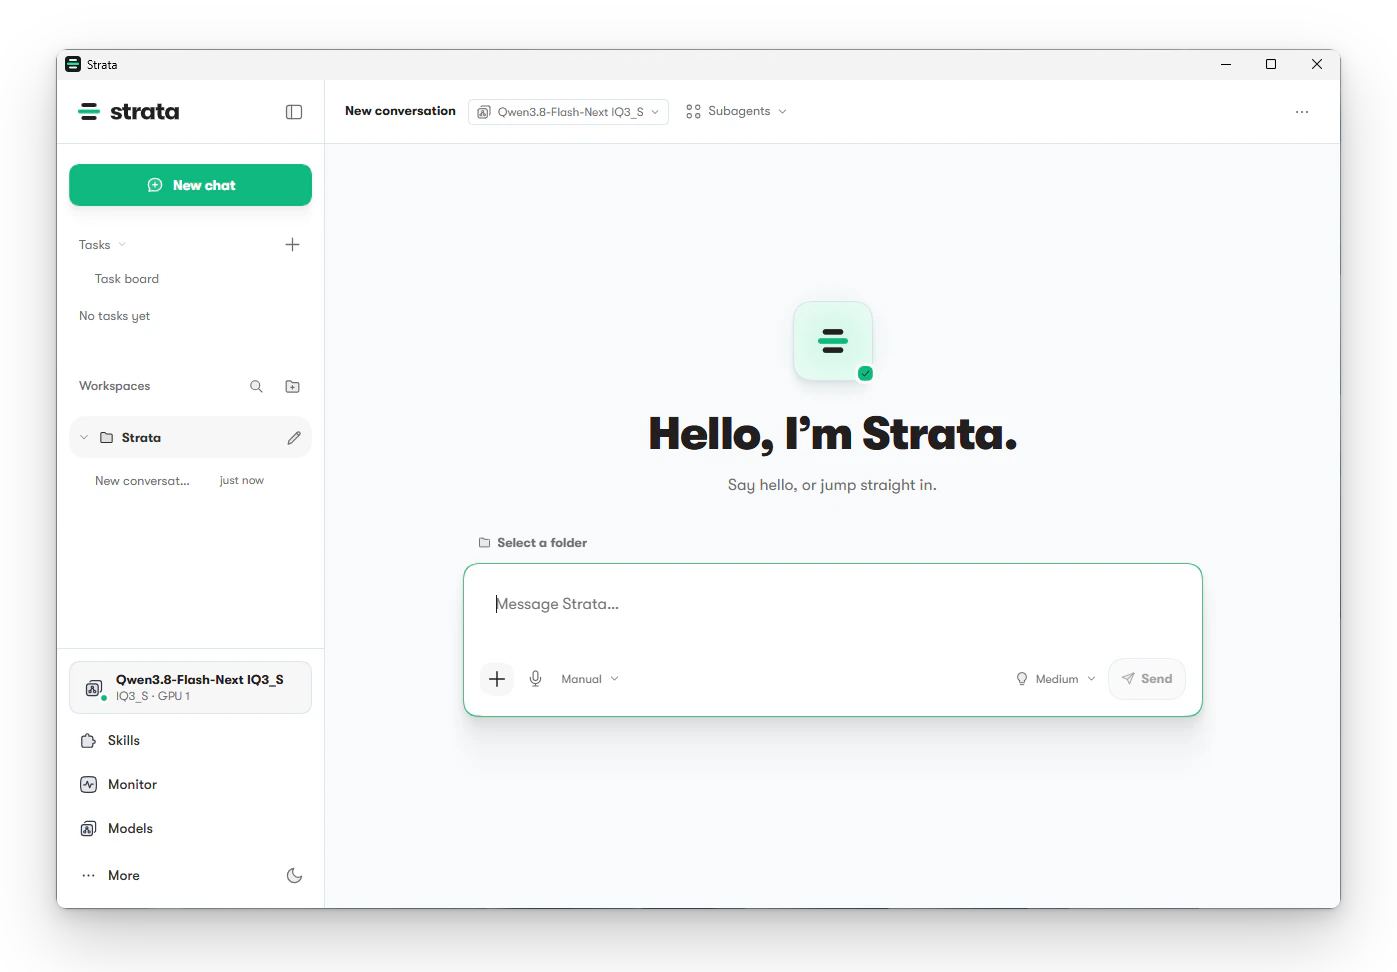
わずか数分ほどでチューニングが完了し、Strataのチャット画面が開いていれば初回セットアップは完了です。
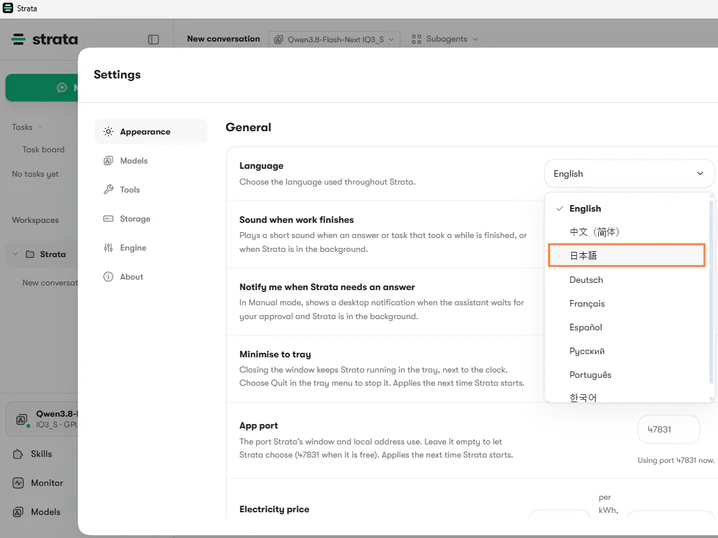
設定画面でGUIの表示言語を「日本語」に変更できます。
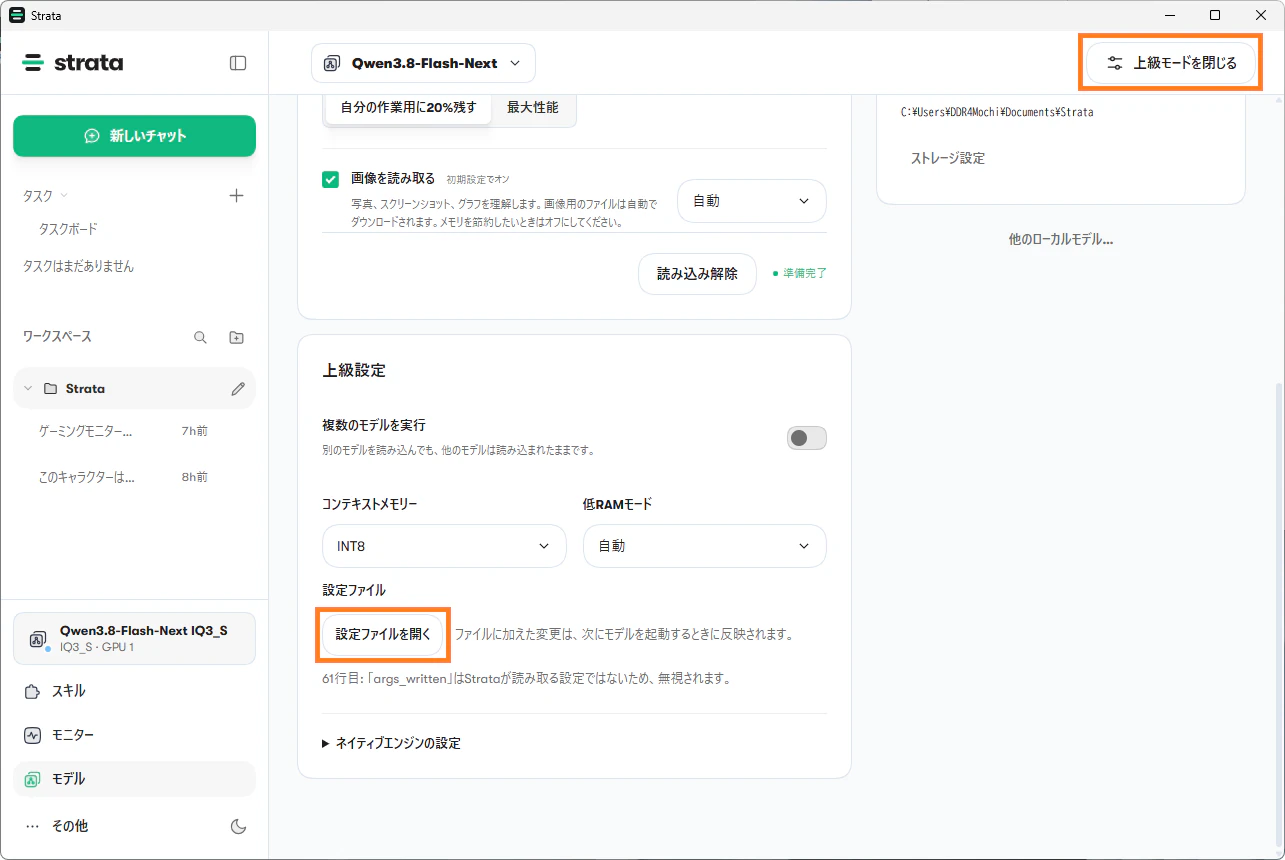
Strataのモデル設定画面を開く → 上級モード → 設定ファイルを開きます。
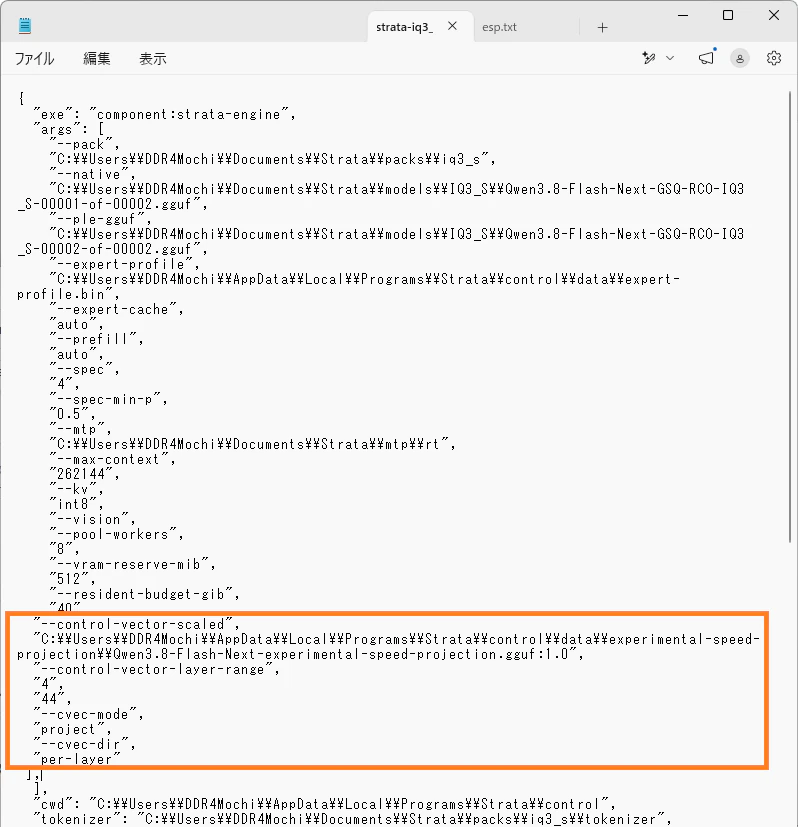
"--resident-budget-gib",
"40"
上記コードの末尾に、以下のコードを追加します。
"--resident-budget-gib",
"40",
"--control-vector-scaled",
"C:\\Users\\<USER>\\AppData\\Local\\Programs\\Strata\\control\\data\\experimental-speed-projection\\Qwen3.8-Flash-Next-experimental-speed-projection.gguf:1.0",
"--control-vector-layer-range",
"4",
"44",
"--cvec-mode",
"project",
"--cvec-dir",
"per-layer"
設定を保存してStrataサーバーを再起動後、「IQ3_S」モデルの検閲が解除されています。
Qwen 3.8 Next Flashはもともと検閲が緩いので、experimental-speed-projection(ESP)の有効化でほぼ完全に無検閲化されます。
「Strata」のいろいろな使い方を解説
ローカルAIに「Web検索」で調べ物
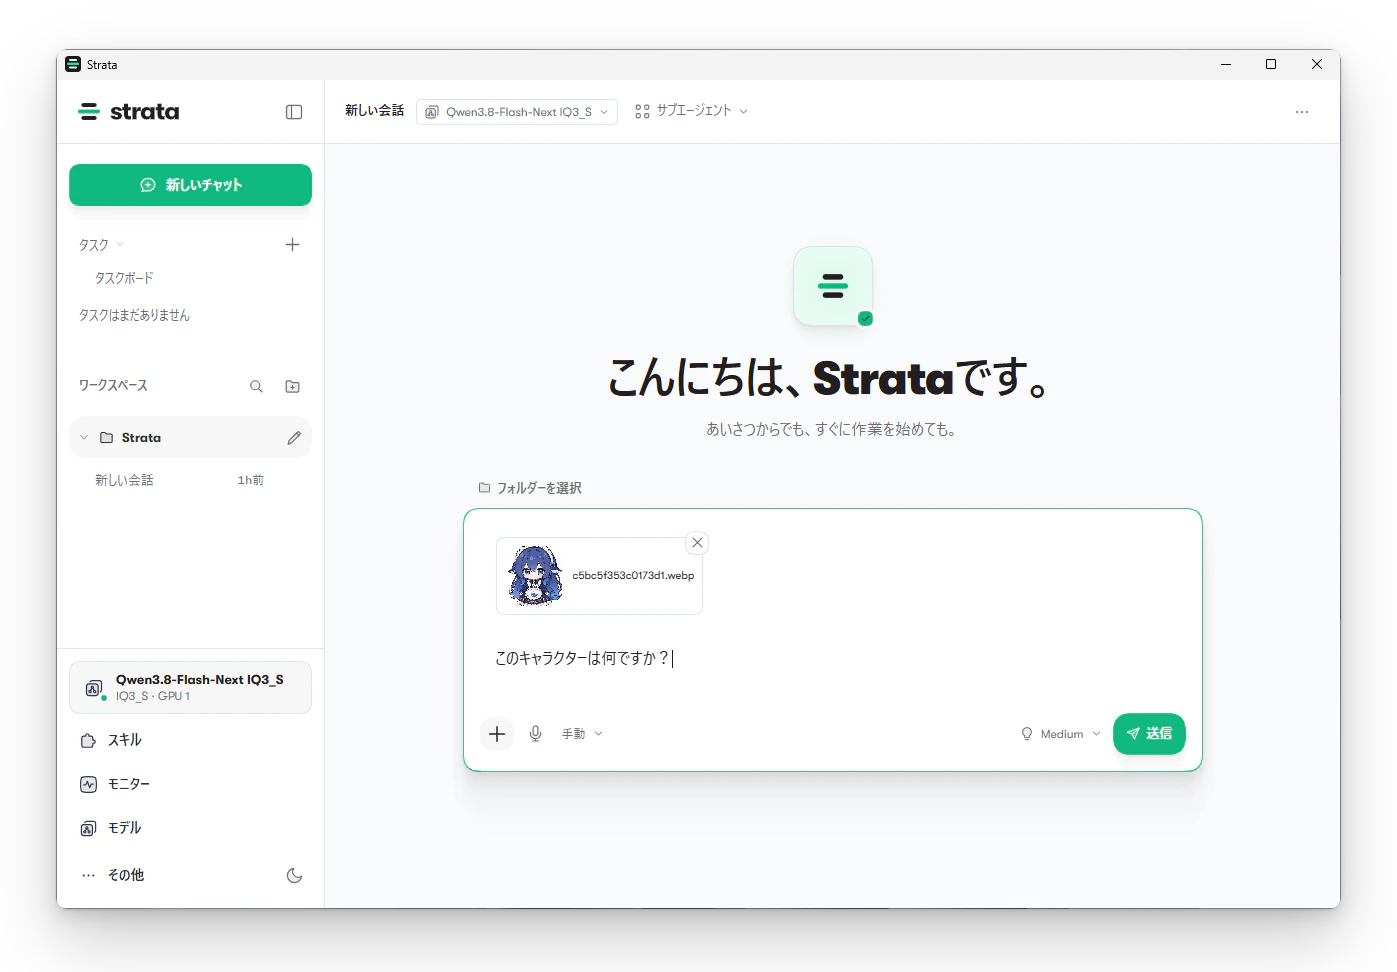
Strataアプリ本体に、いつの間にかWeb検索機能が標準搭載されていたので、試しに使ってみます。
ネットで拾った画像をチャット欄に貼り付けて「このキャラクターは何ですか?」と聞いてみます。
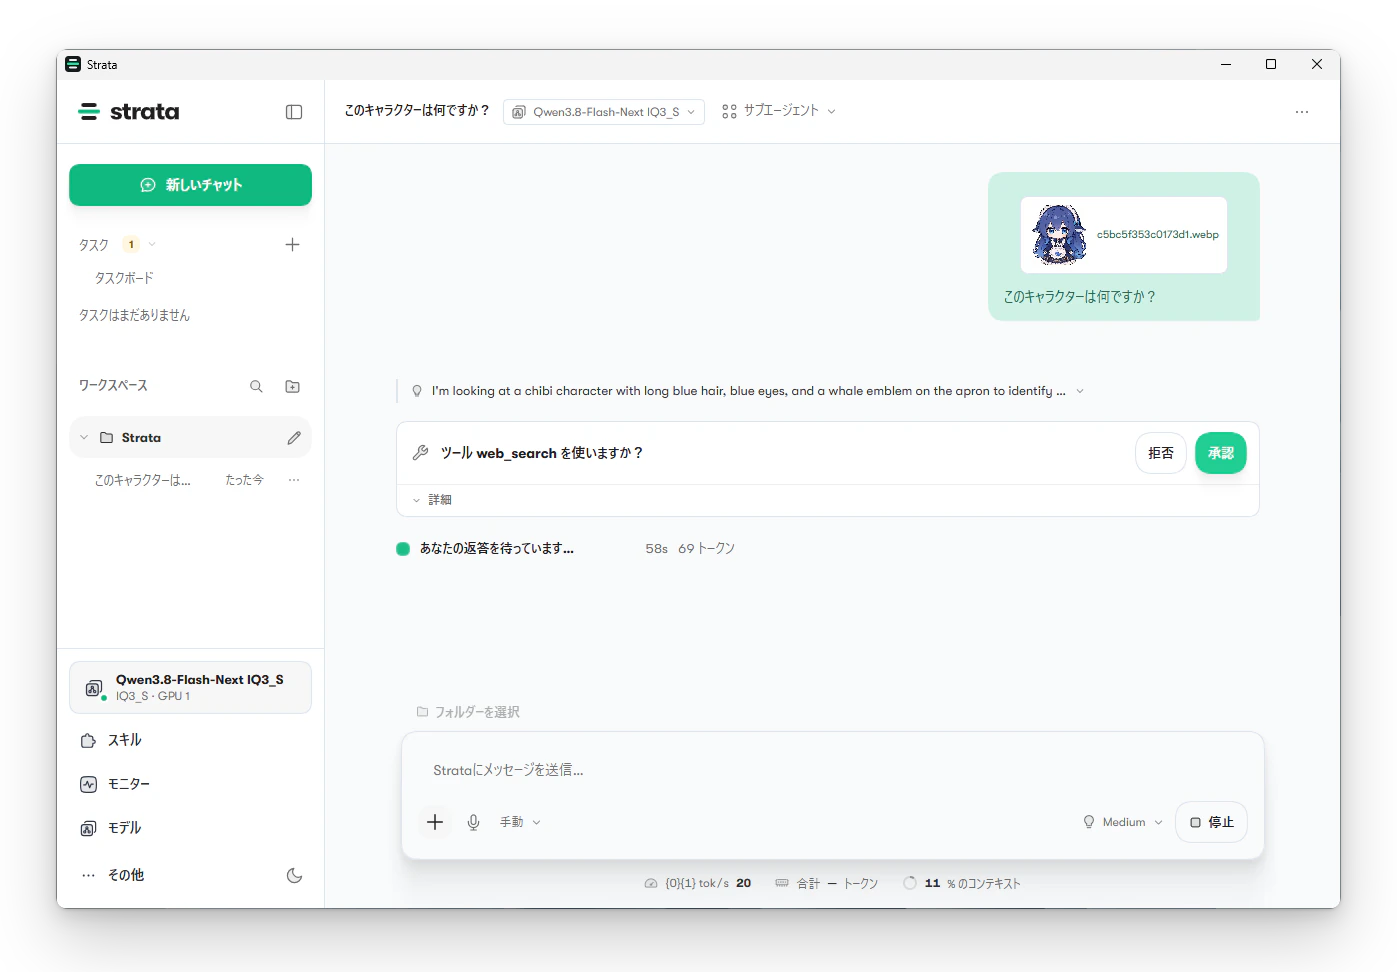
Web検索ツールの使っていいか承認を求めてくるので承認します。
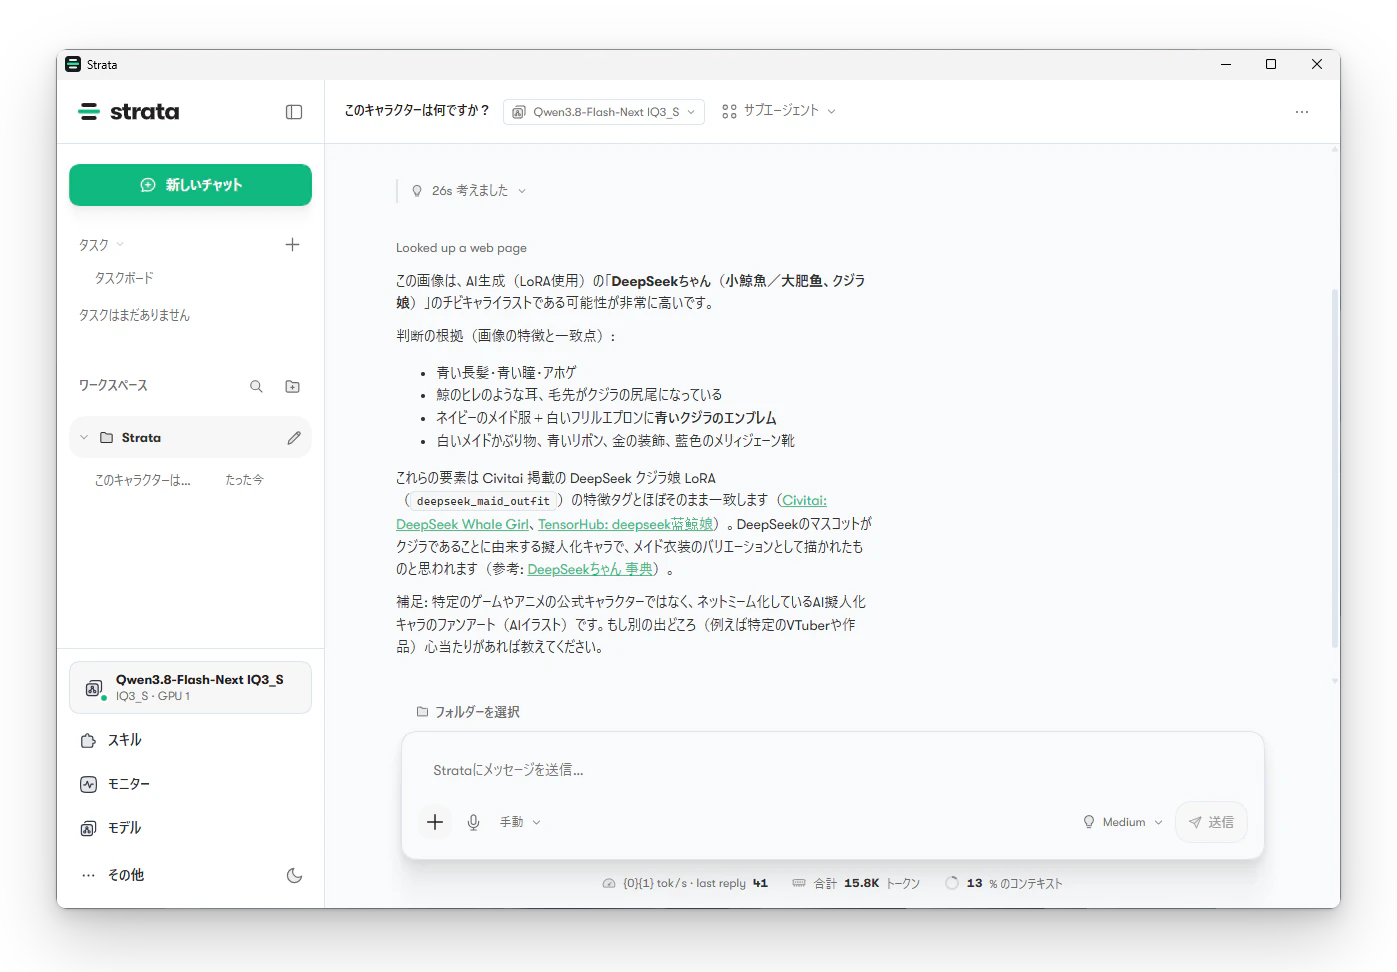
約30秒で貼った画像が「DeepSeek娘」だと特定して見せました。画像を認識する能力(Vision)と、Web検索(Tool Call)の組み合わせで、画像の内容を高い確率で特定可能です。
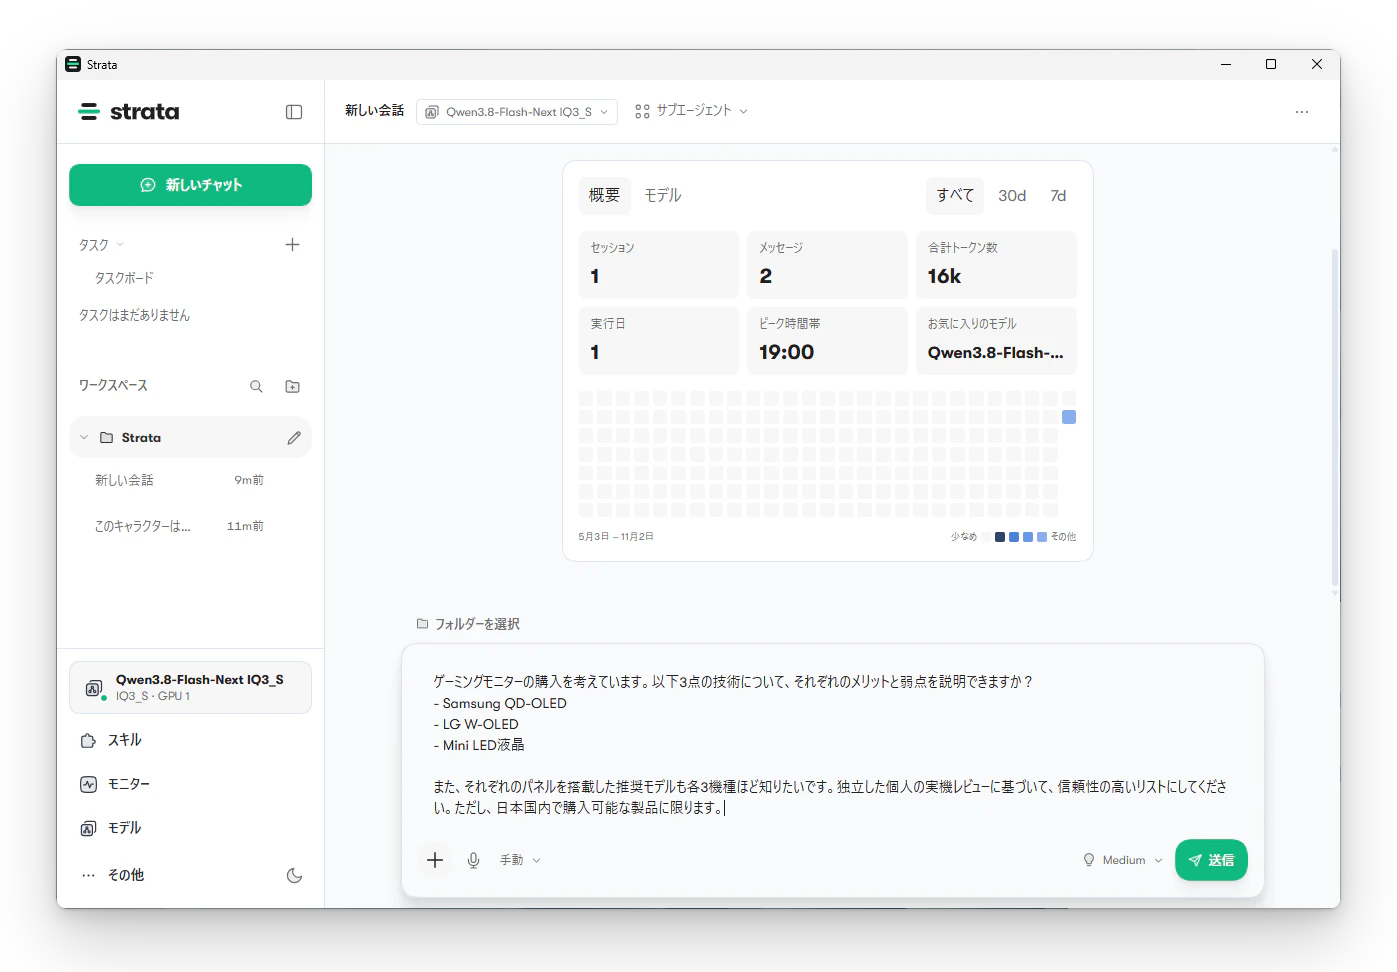
もう少し難易度を上げてテストします。
- 液晶パネルの種類ごとのメリットとデメリット
- パネルごとにおすすめなゲーミングモニター(3機種)
- 個人の信頼できるレビューを参照する
- 日本国内で買える製品に限定する
複数のリクエストが詰まったプロンプトです。
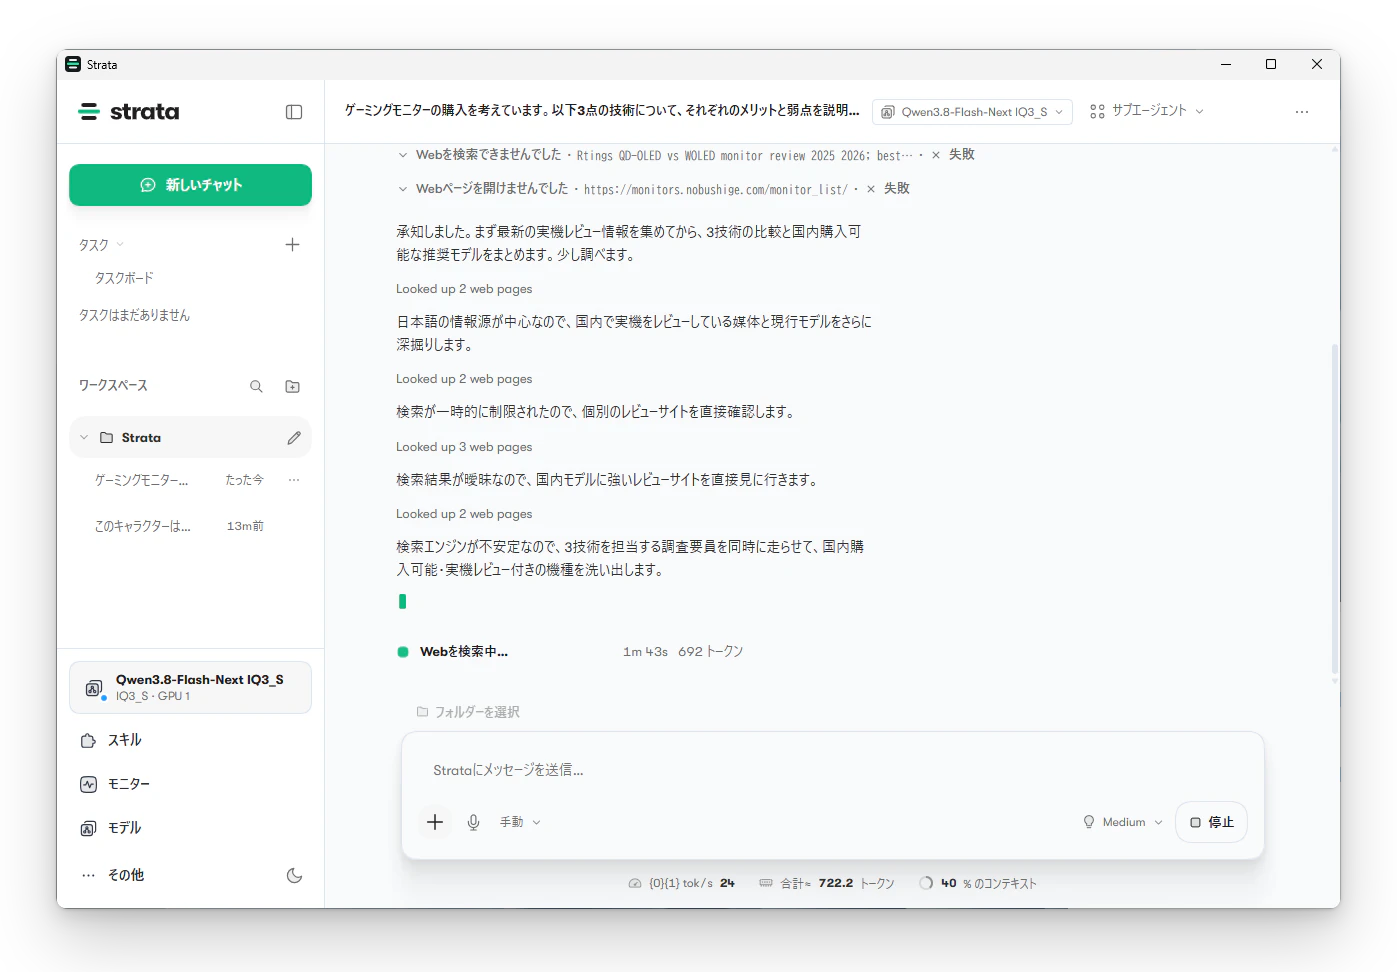
残念ながら、Strata標準のWeb検索ツールは正直かなり弱いです。
Qwen 3.8 Next Flashが「検索エンジンが不安定」「検索結果が曖昧」「検索が一時的に制限」など、Web検索ツールの使いづらさに文句を言っています。
結局20分待っても返答がなく、実用性に欠ける結果に終わりました。
モデル本体の性能が良くても、着ている服(ハーネス)の性能が不釣り合いだと、モデルの持っている実力をうまく引き出せません。モデルに見合う高性能なハーネスに着せ替えましょう。
「DeepSeek Harness」を着せて性能を強化
- deepseek harness desktop (deepseek.com)
OpenCodeやHermes Agent、LibreChatなど。ハーネスはいろいろとありますが、その中でも「deepseek harness desktop(略してDSH)」を強くおすすめします。
- 軽量(無駄なシステムプロンプトが少ない)
- 拡張性(足りない機能はプラグインで対応)
- 効率的なツール呼び出し(省トークン消費性)
- DeepSeek-V4.1-Flashシリーズに最適化
(DSHを前提に最適化されたモデルと相性よし)
モデルの挙動が本当に変わります。
たとえば、筆者が今まで「ポンコツ」だと思っていたGemma4 31BやQwen3.8 27Bどころか、もっと小さいBonsai 2 27B(Q2版)ですら割とそれっぽい挙動に変化してびっくりです。
まるでCodexを使っているかのような動きに変貌します。モデルの性能は単純なベンチマークだけで評価できない時代です。モデルとハーネスの組み合わせも、ローカルAIを使っていくなら頭に入れておきたいです。
DSHをインストールします。
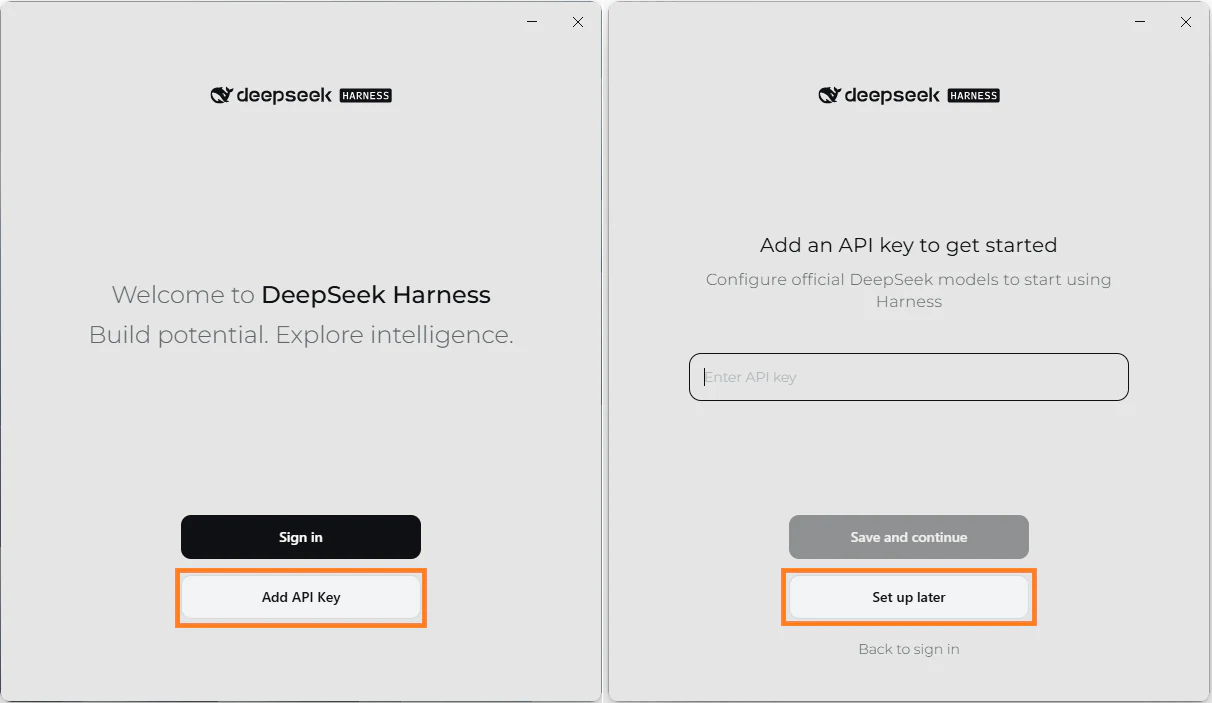
最初の画面が少しややこしいです。まず「Add API Key」をクリックしてから「Set up later」で完了です。アカウント登録なし、完全無料で使えます。
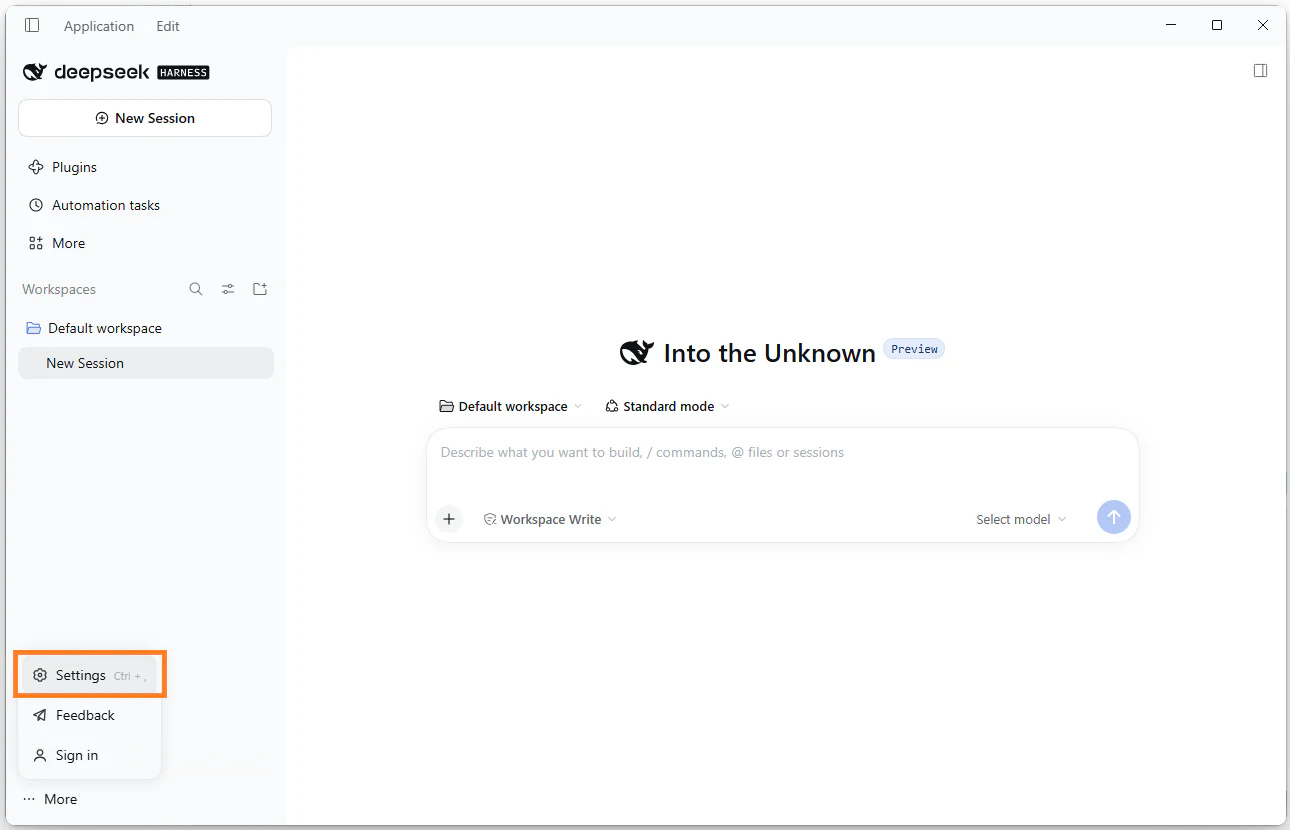
「Settings」に進んで、StrataとDSHを接続します。
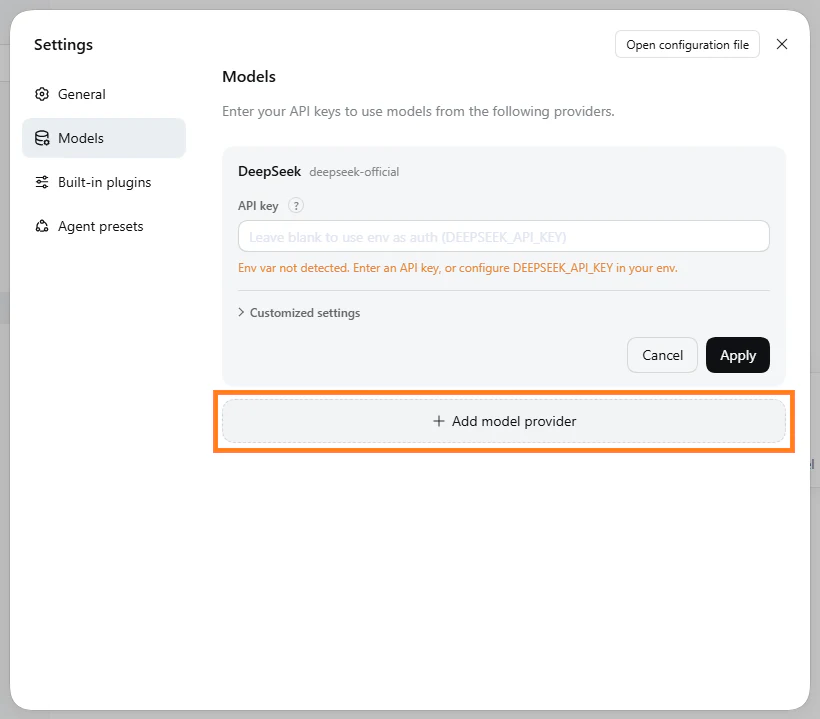
「Models」を開いて「+ Add model provider」をクリックしてください。
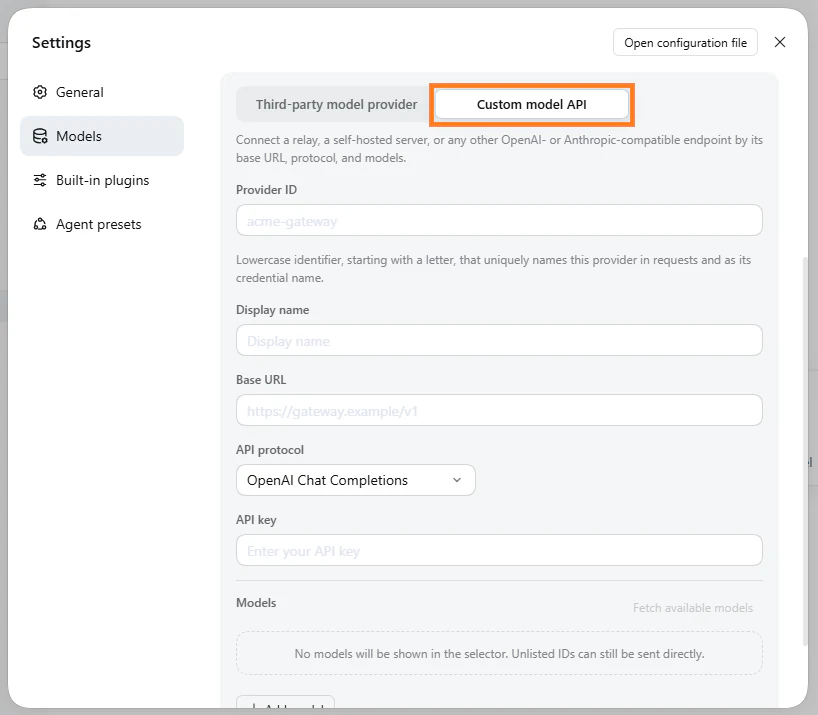
「Custom model API」をクリックして、Strataの認証情報を入力します。
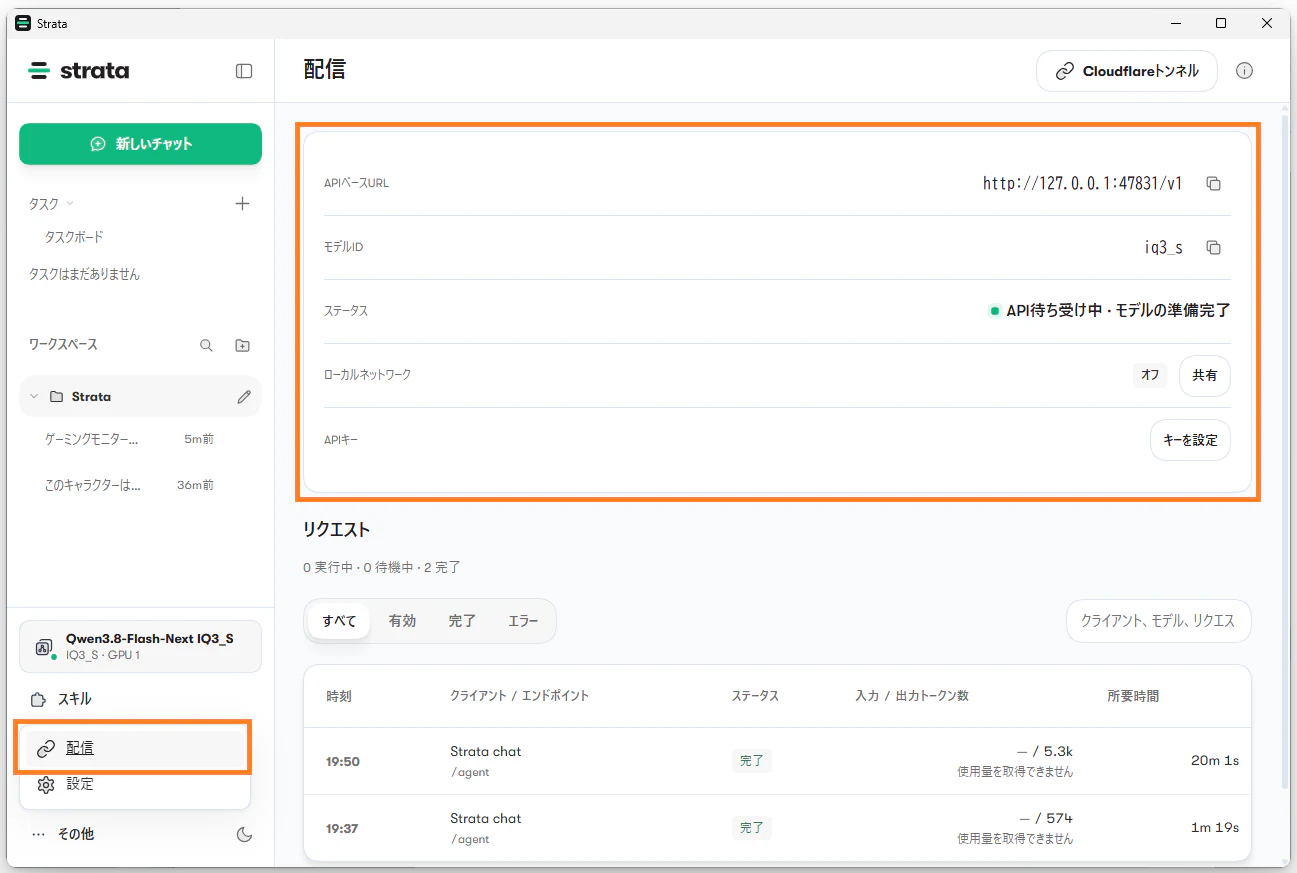
Strataの「配信」タブで、接続用の認証情報を確認できます。
- API URL
- model ID
- API key
以上の3つをコピーして、DSH側に貼り付けます。

APIキーは自動生成されます。コピーボタンをクリックして、DSH側に貼り付けてください。
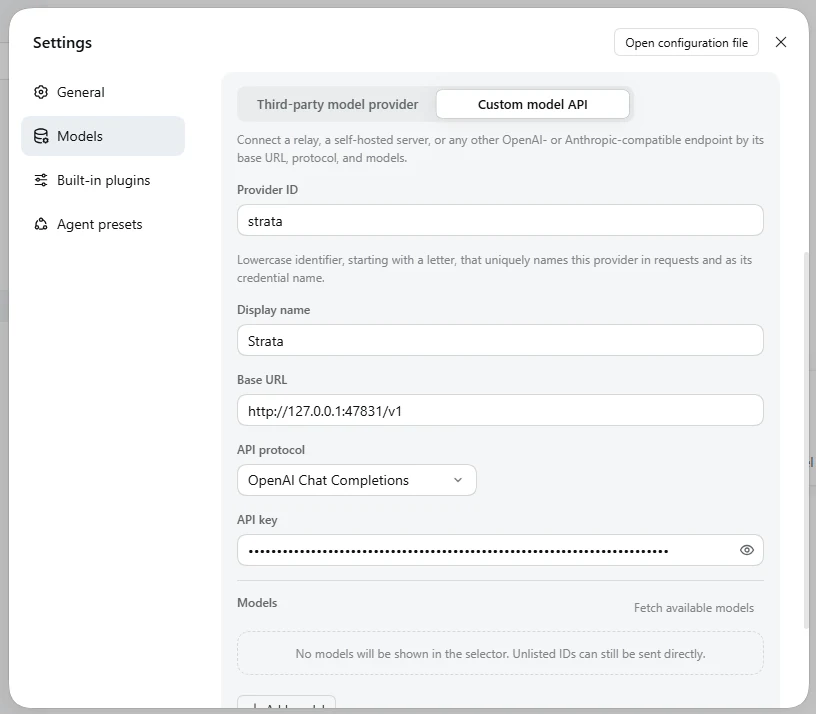
- Provider ID:適当な名前をつける(例:strata)
- Display Name:表示する名前(例:Strata)
- Base URL:API URL(末尾が v1)
- API protocol:OpenAI Chat Completions
- API key:Strataの画面からコピーする
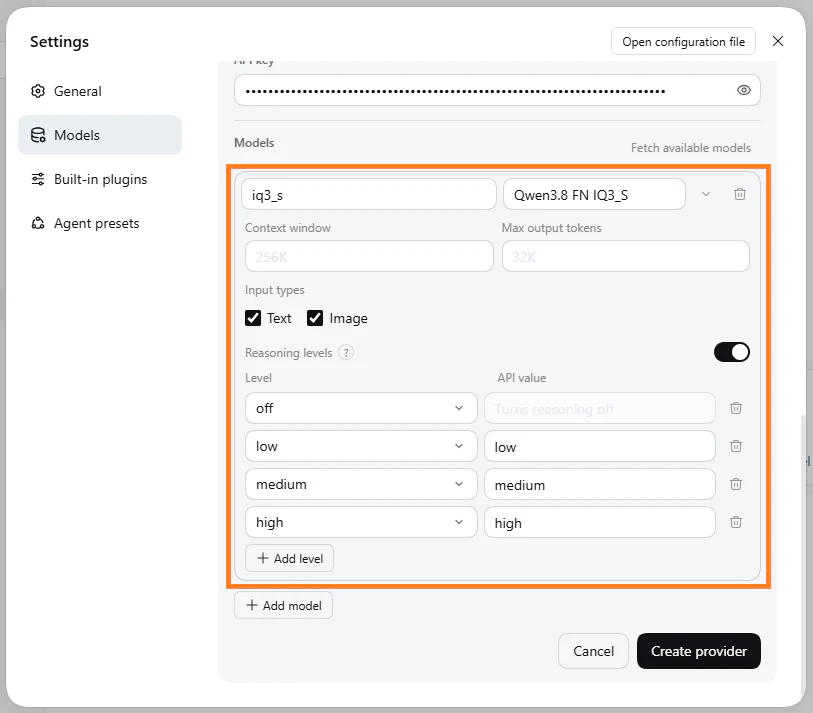
モデル情報を登録します。
- model ID:Strataの画面からコピーする(例:iq3_s)
- Display Name:表示するモデル名(例:Qwen3.8 FN IQ3_S)
Input typesは「Text」「Image」にチェックを入れて、Reasoning levels(思考レベル)はチェックを入れるだけで完了です。
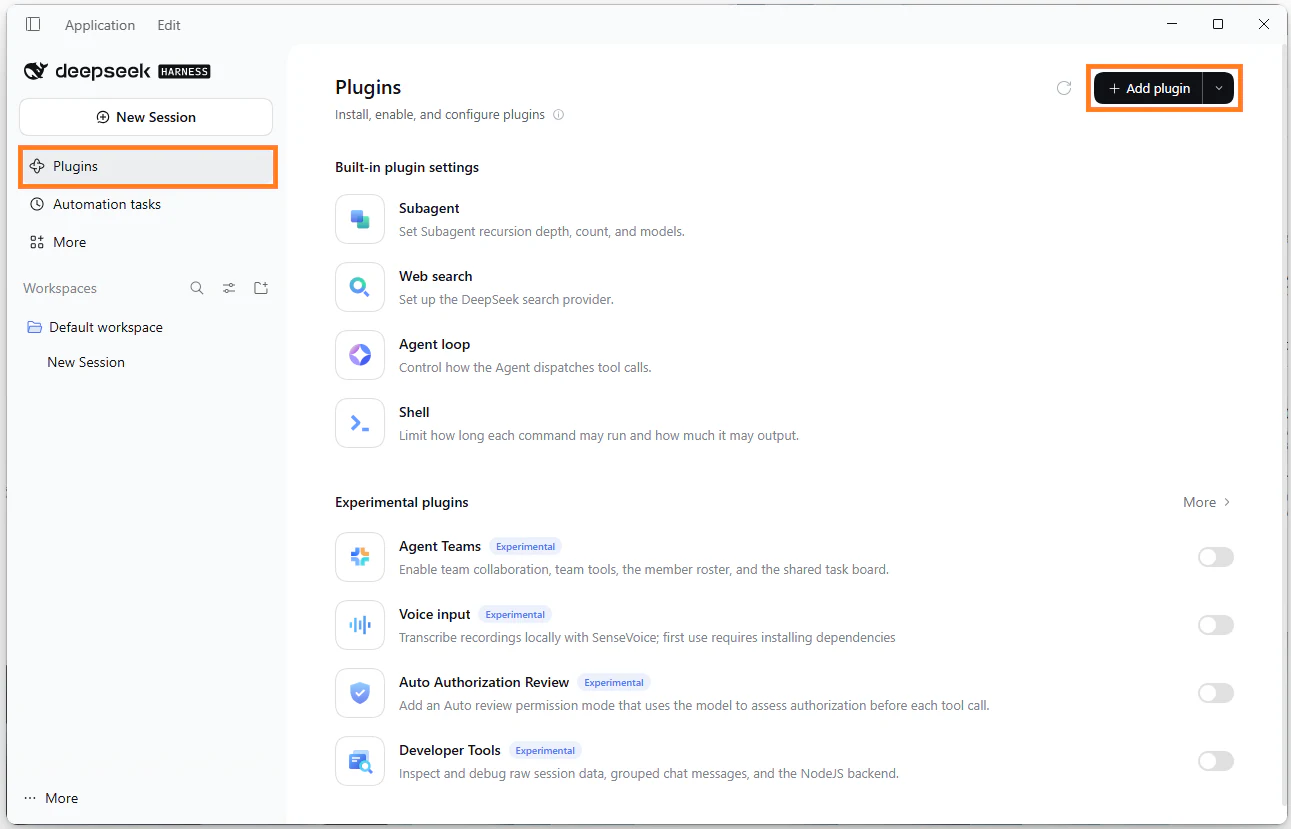
次に「Plugins」を開いて「+ Add plugin」です。
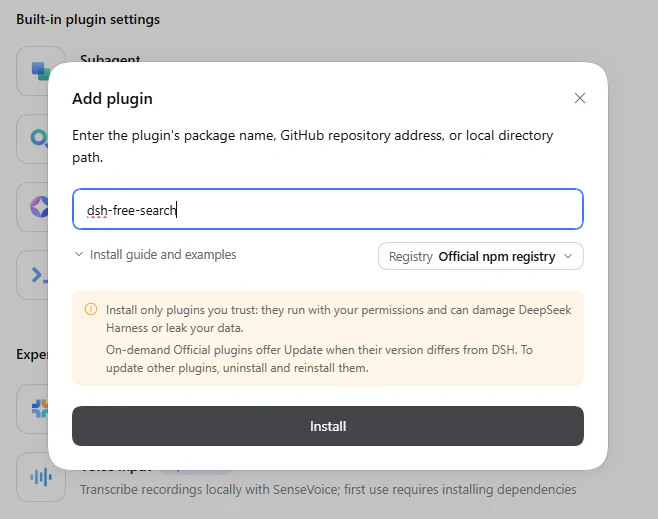
「dsh-free-search」をインストールします。
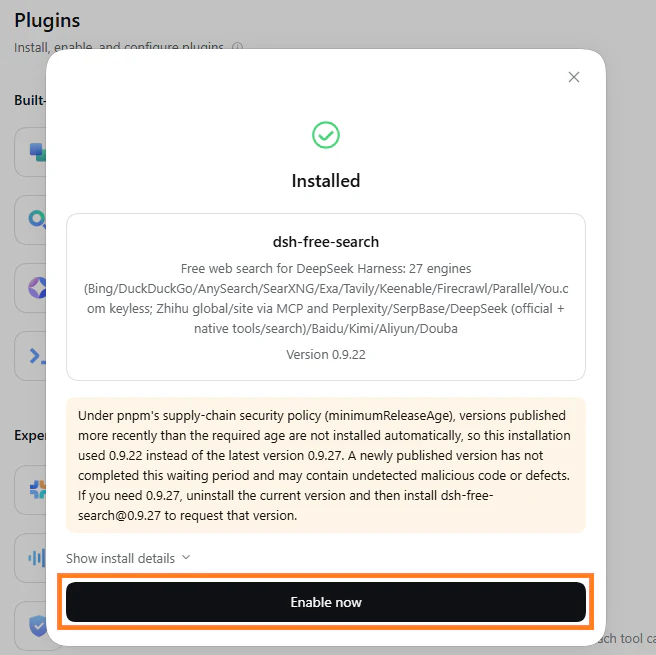
「Enable now」でWeb検索ツールのインストールが完了です。
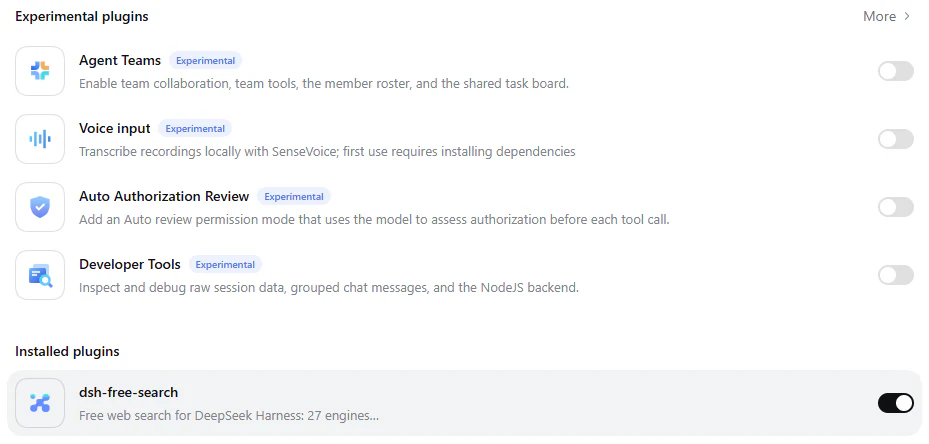
「dsh-free-search」にチェックを入れて、Web検索ツールを使える状態にします。
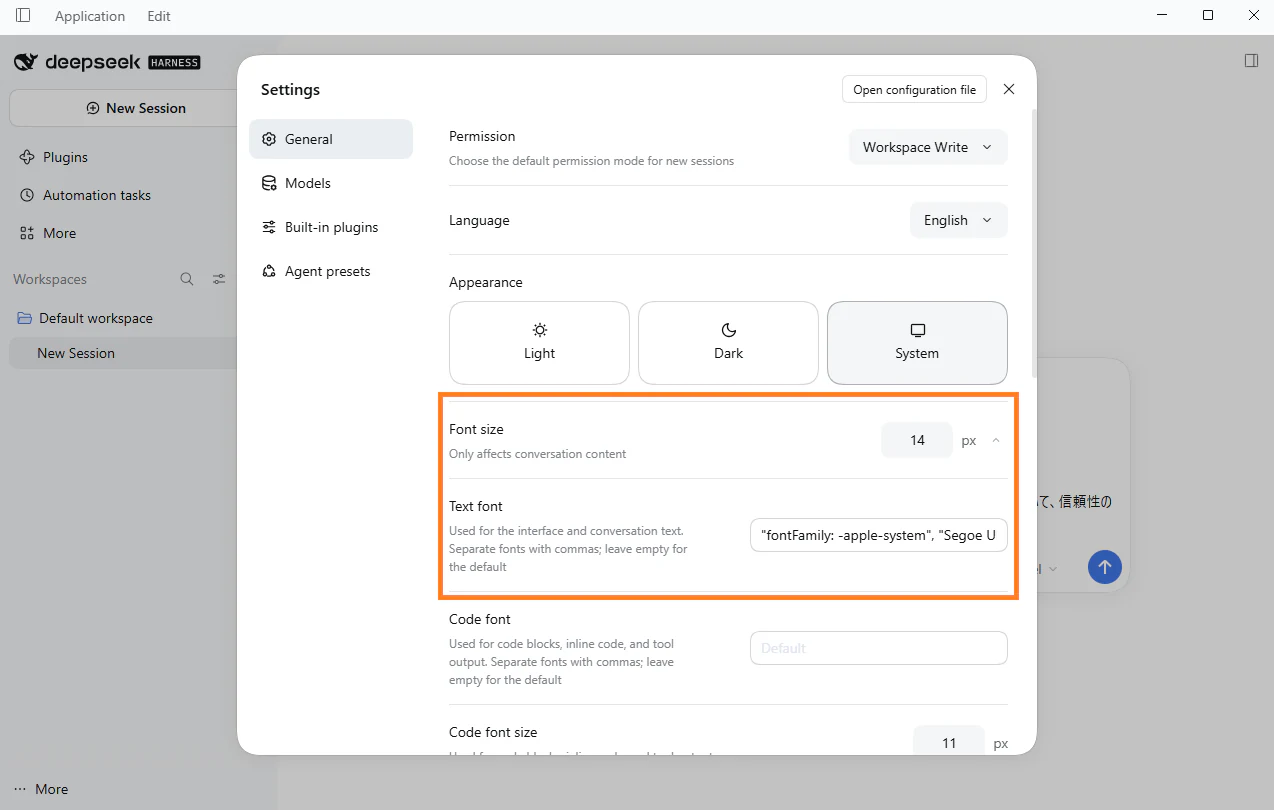
Settings → General → Font size の矢印を開いて、以下のコードをText fontに追加します。
"fontFamily": "-apple-system, 'Segoe UI', 'Hiragino Sans', 'Hiragino Kaku Gothic ProN', 'Yu Gothic UI', 'Yu Gothic', 'Meiryo', 'Noto Sans JP', sans-serif"
追記したら、DSHを再起動してください。
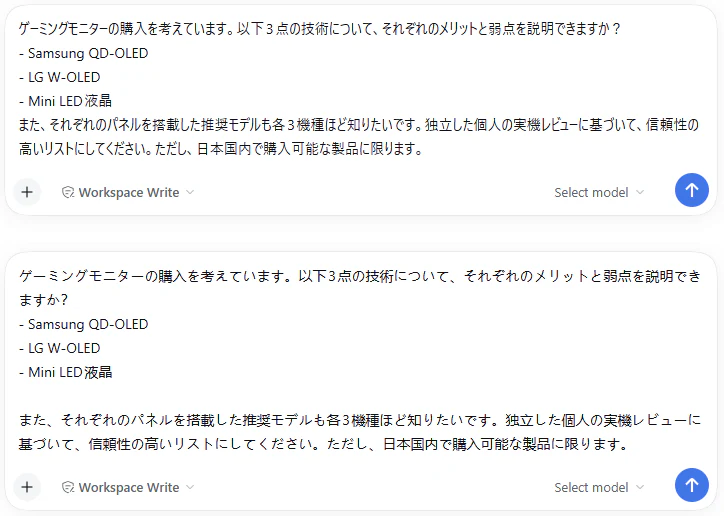
Windows標準の日本語フォントが適用されるようになり、中華フォントが消えました。
ただし、モデルが中国語を話すと中華フォントが混じってきます。IQ3_S版でも、10~20万コンテキストを超える長いセッションだと、まれに中国語(簡体字)を出力する瞬間がありました。
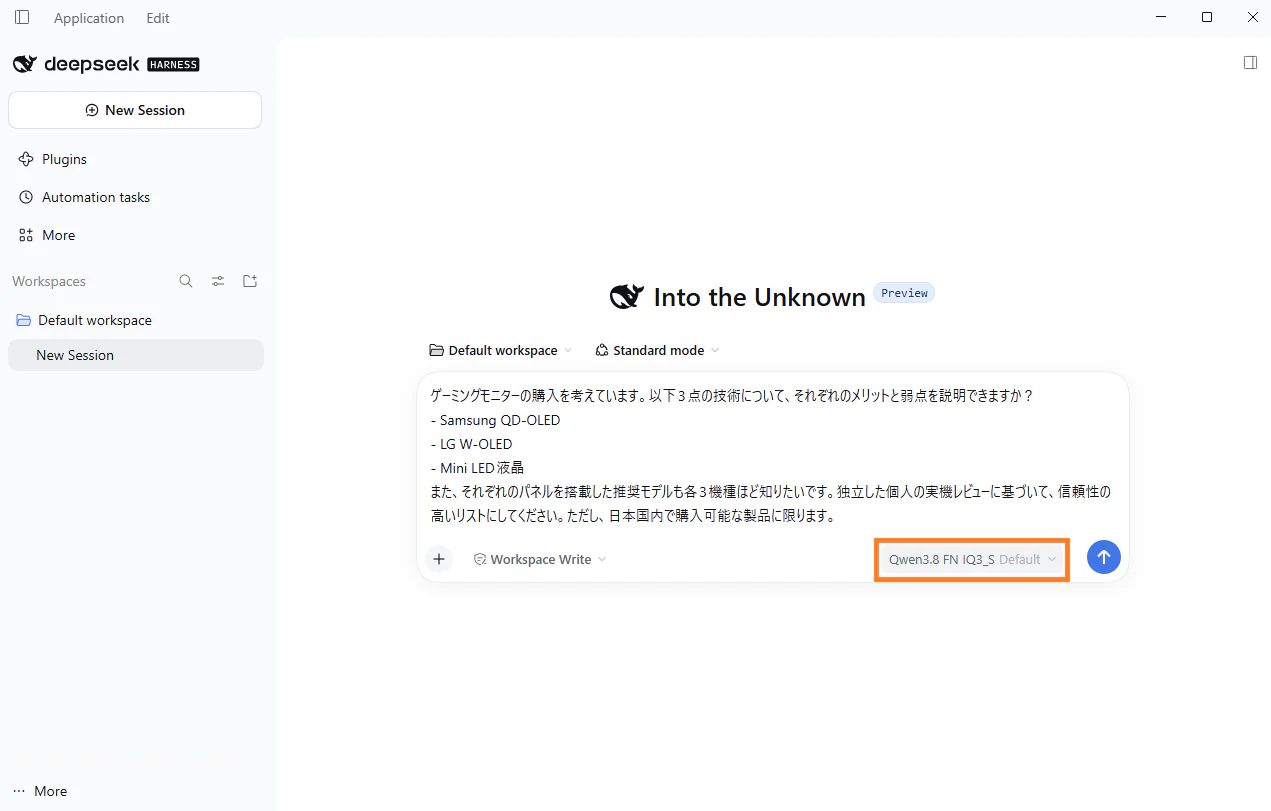
ようやく準備が完了したので、今度こそWeb検索を完遂できるか再検証です。モデルを「Qwen 3.8 Next Flash IQ3_S」に切り替えて、プロンプトを打ち込んで反応を見てみます。
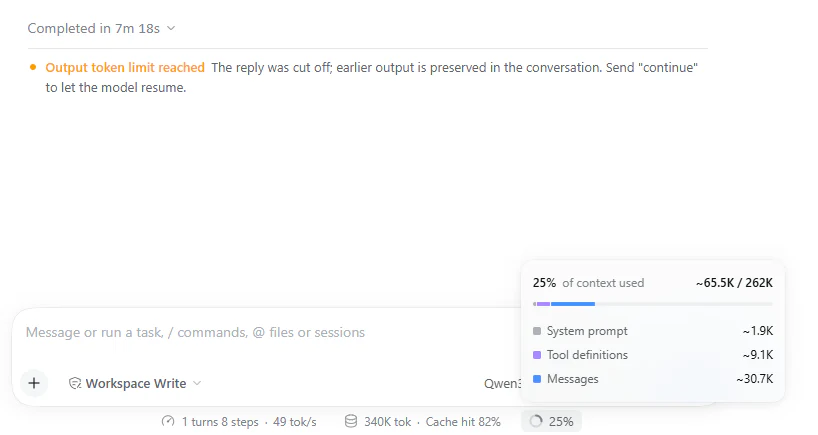
エラーメッセージ「Output token limit reached」が表示されて、モデルが停止しました。
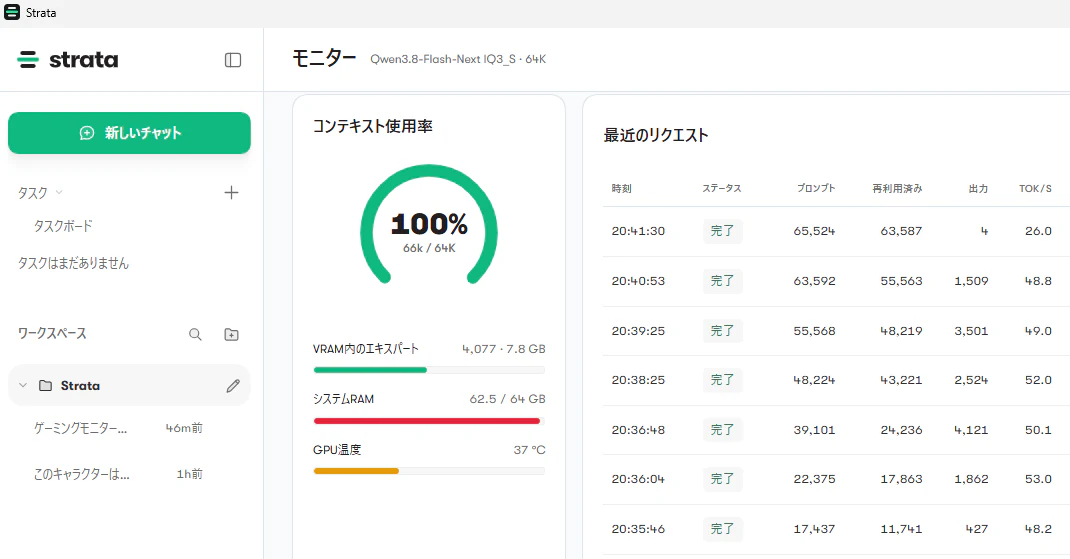
Strataのモニター画面を見ると、コンテキスト使用率が100%に達しています。
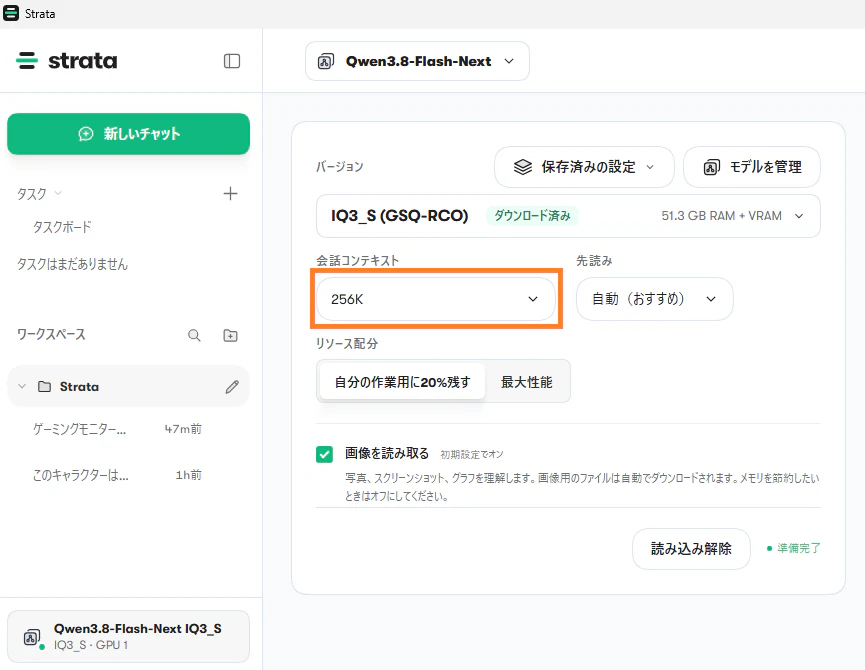
モデルの設定を開いて、会話コンテキスト「256K(= 262144)」に変更してからモデルを再起動してください。
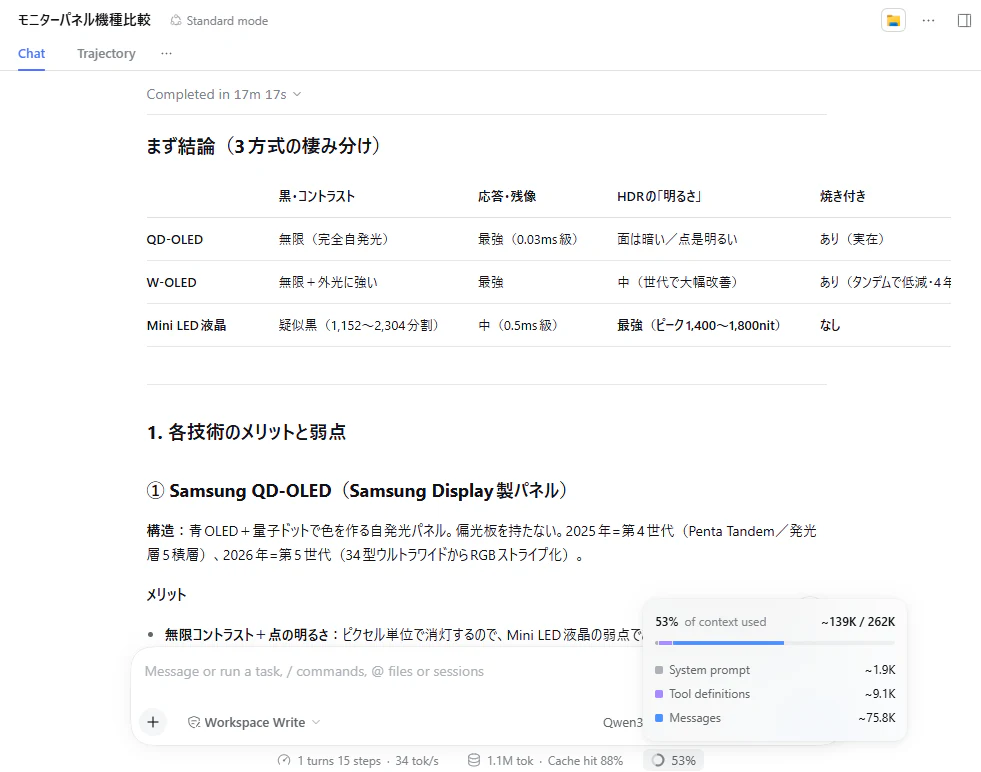
約17分で課題をクリアできました。
Strata純正ハーネスだとWeb検索エラーが頻発してマトモに作業が出来ていなかったですが、DSHなら問題解決能力が著しく向上します。
ちなみに、Qwen 3.8 Next Flash IQ3_Sのまとめたレポートはおおむね正確です。ゲーミングモニターに詳しい筆者から見ても、十分な品質に達しているし、おそらく家電量販店にいる店員よりも優れています。
拾ってくるソースの選定も正確です。コピペ系ブログ、読み上げ系チャンネルを巧みに回避して、実機ベースのレビューをきちんと拾い上げてレポートにまとめています。
画像を見る能力(Vision)を用いて、実機の写真が存在するかどうかも確かめているようです。パラメータ数125B級ともなれば、検索で拾った情報に対する正誤判定まで自律的に行うので、明確に「賢い」と感じます。
シンプルで高速な動画エンコードソフトの開発
もっと難易度の高いタスクに挑ませましょう。ハードウェアエンコーダーを利用した、超高速かつ軽量な動画エンコードソフトを開発します。
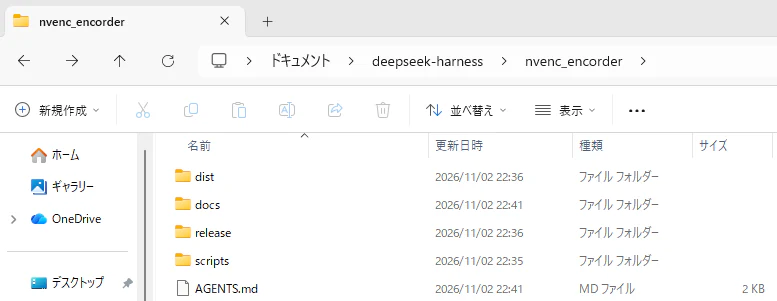
任意のディレクトリに、作業用のプロジェクトを作成します。その中に「AGENTS.md」と呼ばれる指示書を1つ作っておきます。
# nvenc_encorder
## このプロジェクトは何?
CLIアプリ「https://github.com/rigaya/NVEnc」を使った、軽量かつ高速に動作する動画エンコードアプリを作ります。コマンドラインは非ITユーザーにとって馴染みがなく使いづらいため、モダンなデザインのGUIで包んで誰でも簡単にNVEncエンコードを取り扱えるようにします。
## 技術スタック
### コア
- NVEncC
### GUI
- C# + Avalonia UI
## ドキュメント
- GUI_design.md GUIのデザインと機能
- NVEncC_Options.en.md NVEncCのオプション一覧
## ディレクトリ
nvenc_encorder/
├── dist/ ビルド
├── docs/ ドキュメント
├── release/ 配布物をここに出力
├── scripts/
│ └── NVEncC/ NVEncC本体
└── AGENTS.md AIエージェントが最初に読む
## プロジェクトのルール
### あなたがやっていいこと
- 開発に必要なライブラリやツールの導入
- GUIデザインを確認するためスクリーンショットの撮影
- AGENTS.md のディレクトリ欄の更新
### 実装上の制約
- **エンコーダの実行は必ず疑似コンソール(ConPTY)経由**。NVEncC等はstderrがコンソールでないと進捗行を一切出力しないため、パイプ実行では進捗バーもベンチマークのGPU/VE/VD使用率も取得できない。`portable-pty` クレートを使用する。
- エンコーダ本体はアプリに同梱せず、実行ファイルからの相対パスで
`NVEncC/` を探索する(新ビルドの上書き更新に対応するため)。
わざと「矛盾」を仕込ませたAGENTS.mdですが、矛盾に気づいて自らの思考で問題を解決できるかどうかがポイントです。
モデルの挙動を(ある程度)制御するためのドキュメントです。
たとえば「口調や言語」「禁止事項や承認不要の行為」「目標や目的は何なのか」「どんなデザインにしたいか」「使用するツールやコマンドの指定」「モットー ※3」などなど。
制御できる範囲は極めて多様です。もし、作り方がまったく思い浮かばないなら、いったんチャット欄でローカルAIに相談して作ってもらうといいでしょう。
筆者が初めて作ったAGENTS.mdも、最初こそAI産(Claude Fable 5が設計)でした。
※3:アンソロピックでClaudeを開発する主任エンジニア(Felix Rieseberg氏)は、Claudeに対して「この分野のプロならどうするか? プロの行動パターン、プロが使う道具を使え。そしてあなたの限界を超えてください。」などといったモットーを書いてるそうです。
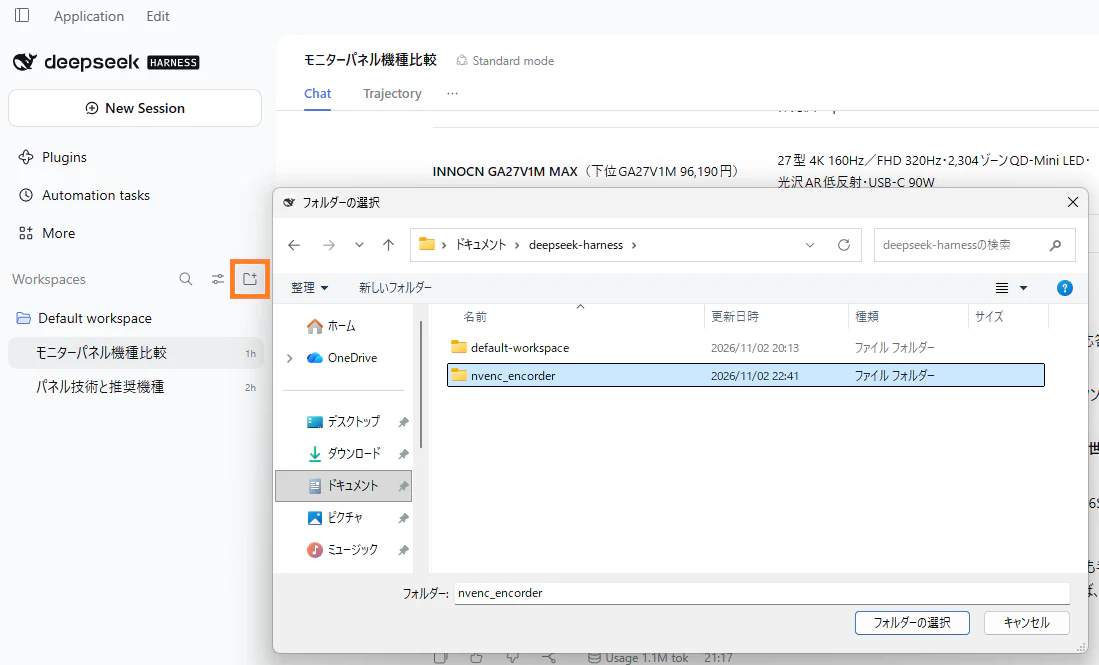
「Workspaces」のフォルダボタンをクリックして、先ほど作ったディレクトリを追加します。
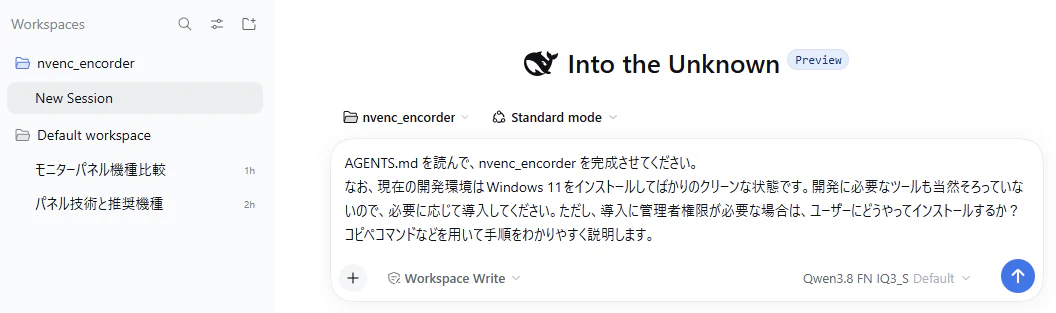
プロンプトを打ち込み、開発を始めます。「完成させてください」と目標を明示しているので、よほどの障害が起きない限り目標達成まで自律的に走り続けます。
ここでローカルAIのメリット「使い放題」が効いてくるわけです。トークン使用量、レートリミットを一切気にしなくていいから、「最後まで走れ」と気軽に指示を出せます。
どれほどのトークンを燃やすか予想もつかないですが、予想を付ける必要がそもそもないです。なぜなら「使い放題」だから。
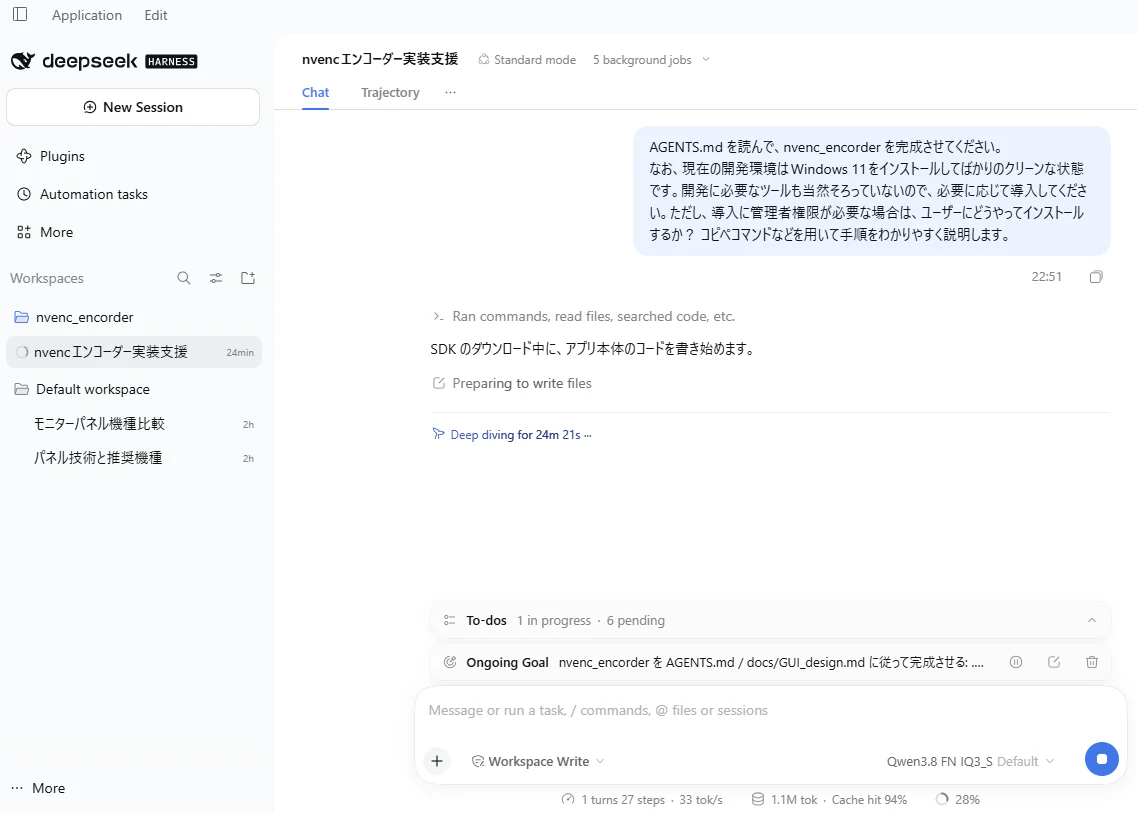
.NET SDKなど開発ツールを導入しながら、並行してアプリ本体のコードを書き始めました。
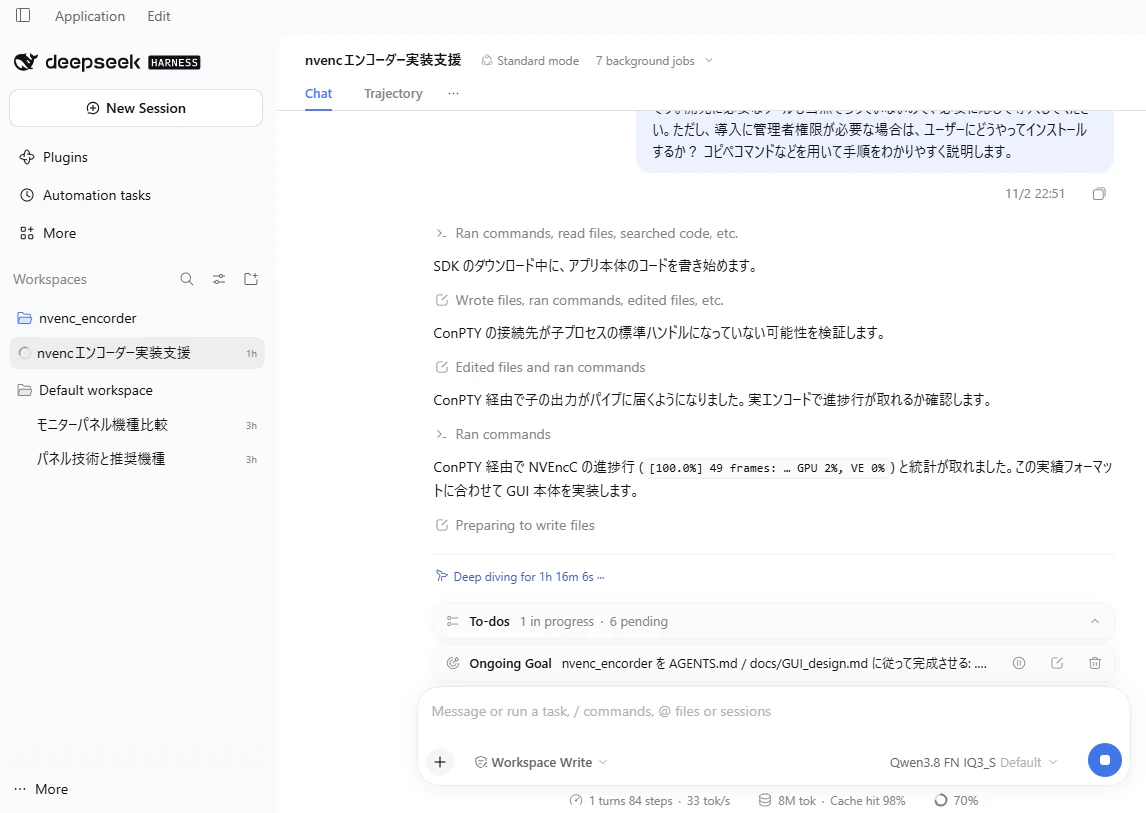
C# + Avalonia UIを要求しているのに、Rust前提の記述があるAGENTS.mdの矛盾にも途中でちゃんと気づき、AGENTS.mdに補足を追記して間違えないように対応しています。
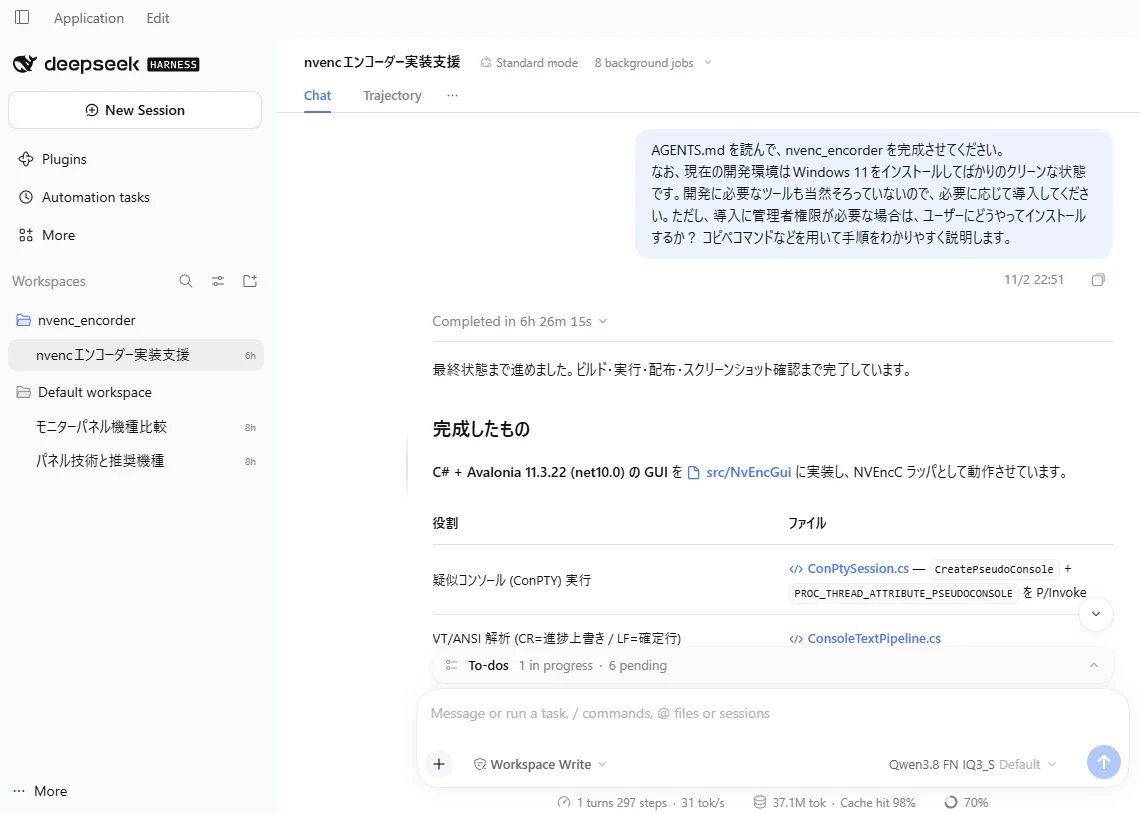
約6時間30秒、一度も停止せず自律的に走り続けてアプリを完成させました。
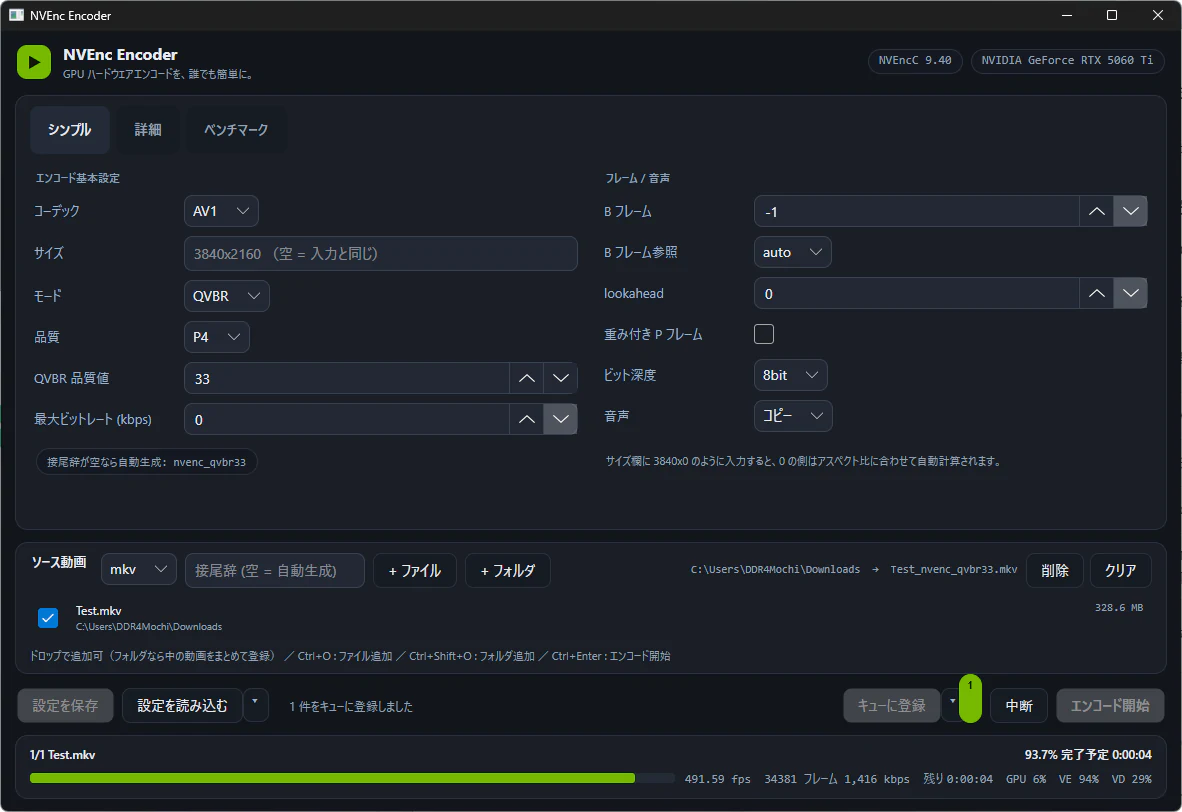
ドラッグアンドドロップで動画を入れて、エンコード設定を選んで、エンコード開始で動画変換が始まります。
毎秒500フレーム(フルHD動画)を叩き出し、CPUエンコードを凌駕する処理性能です。
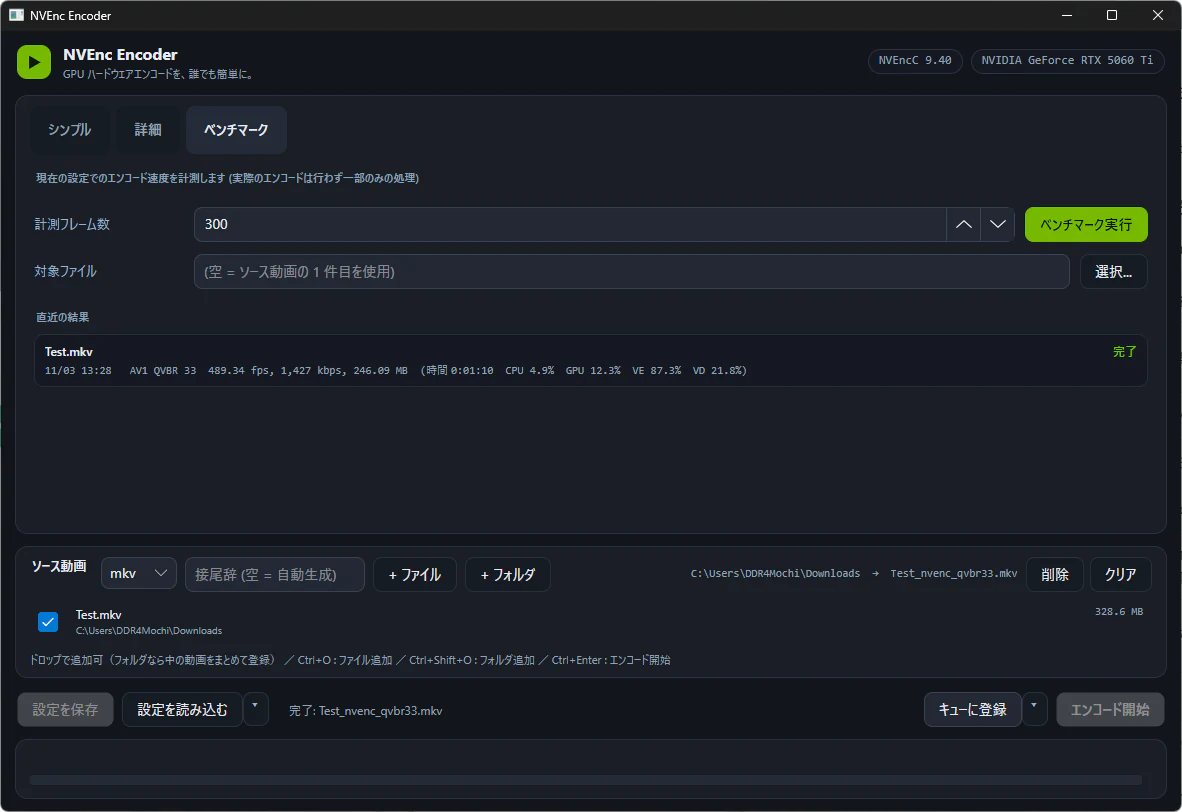
エンコード処理速度を測定するベンチマーク機能も付いています。
シンプルかつ高速な動画エンコードアプリが簡単に完成してしまいました。寝ている間(約6時間30秒)にアプリが完成です。しかもトークン使用量は完全無料です。
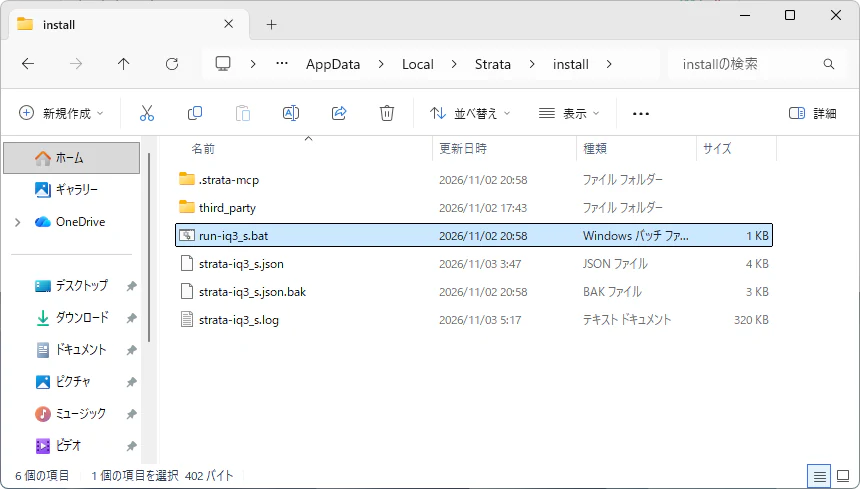
C:\Users\<USER>\AppData\Local\Strata\install
上記ディレクトリにある起動バッチから直接起動すると、Strata純正ハーネスを起動せず、サーバー本体(推論エンジン)だけを立ち上げられます。
筆者の環境ならメモリ使用量が約200 MB減ります。
- 単体起動 → http://127.0.0.1:8080/v1
- Strataアプリで起動 → http://127.0.0.1:47831/v1
サーバー本体の接続先IPアドレスが変わっているので、DSH側の設定を変更します。
画像生成ソフト「ComfyUI」の環境構築
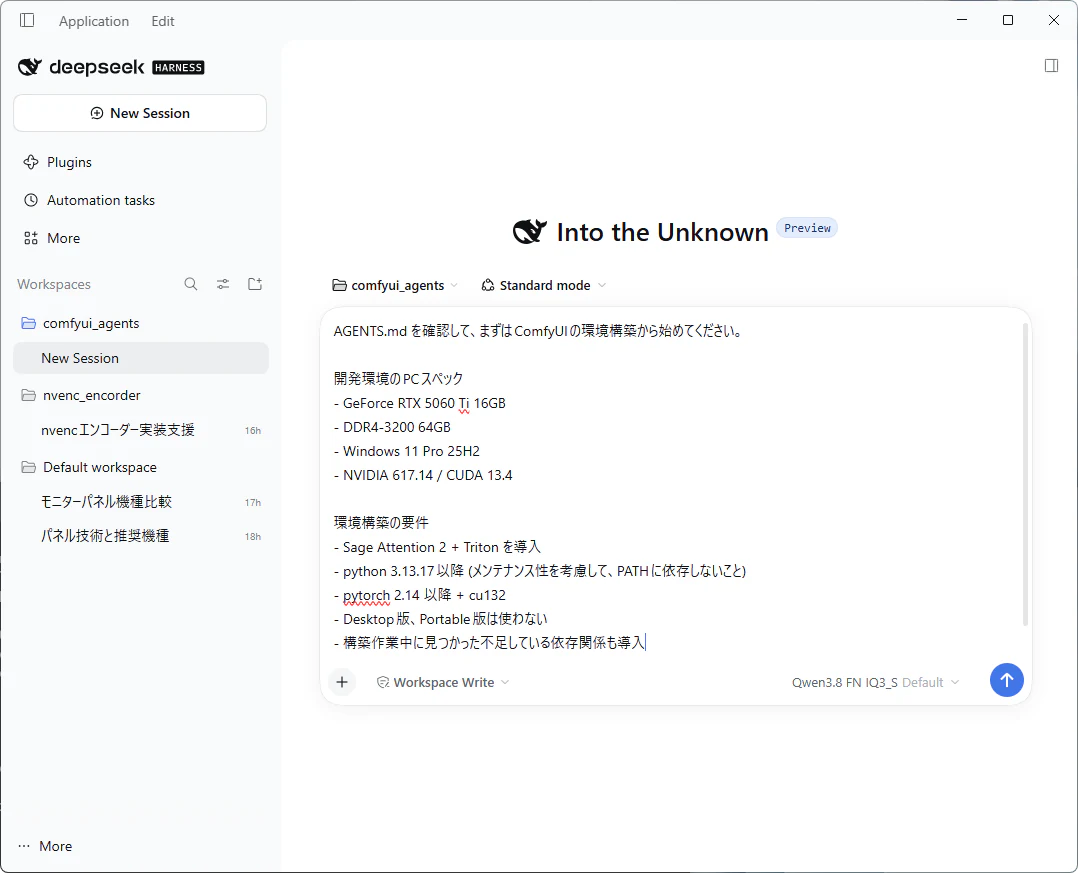
任意のディレクトリに作業用のプロジェクトを作って、その中に「AGENTS.md」を作成してから作業を開始します。
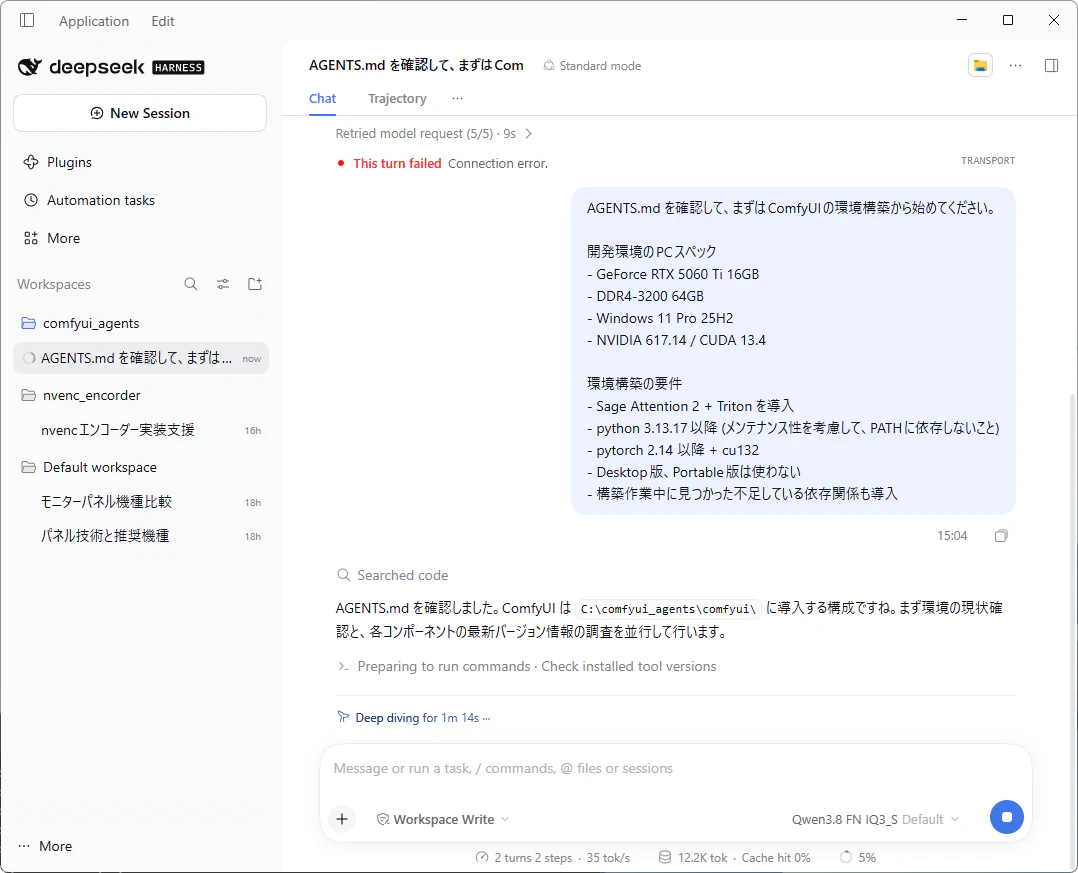
ComfyUIの環境構築が始まりました。
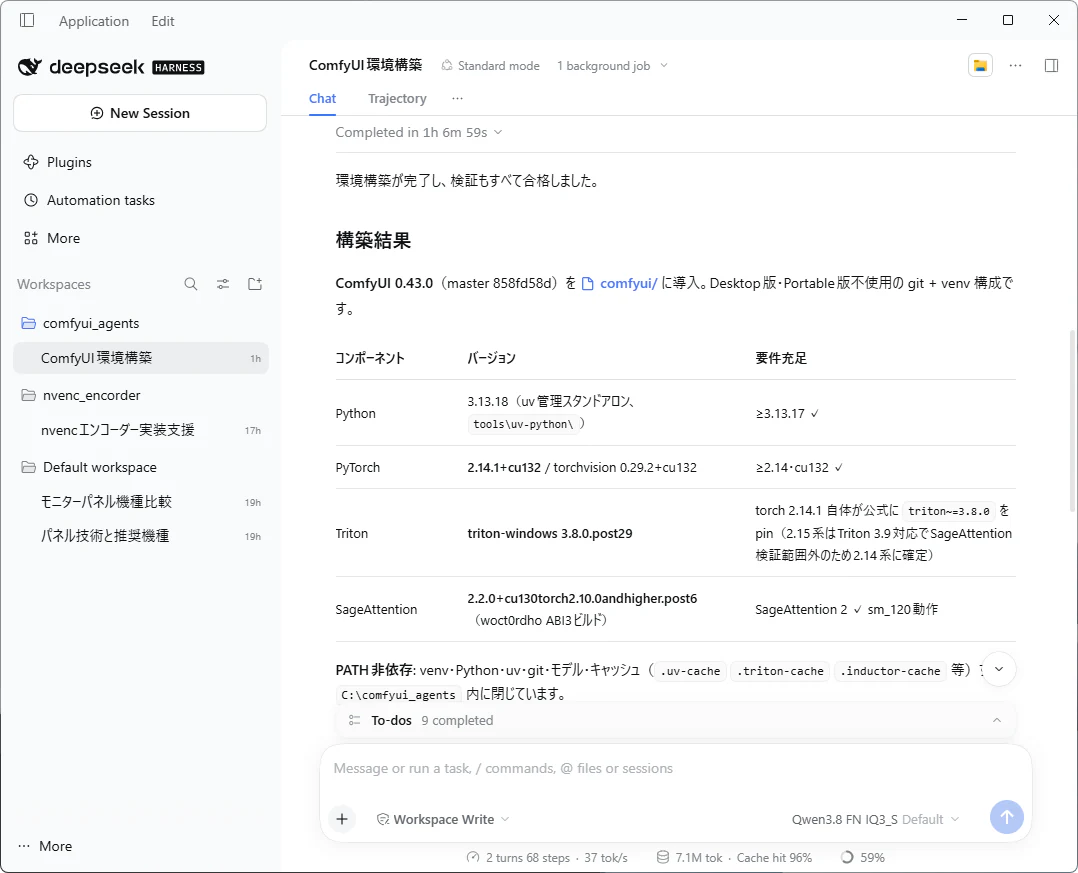
特にリクエストをしていないのに、動作検証も終わらせてから完了報告が来ています。
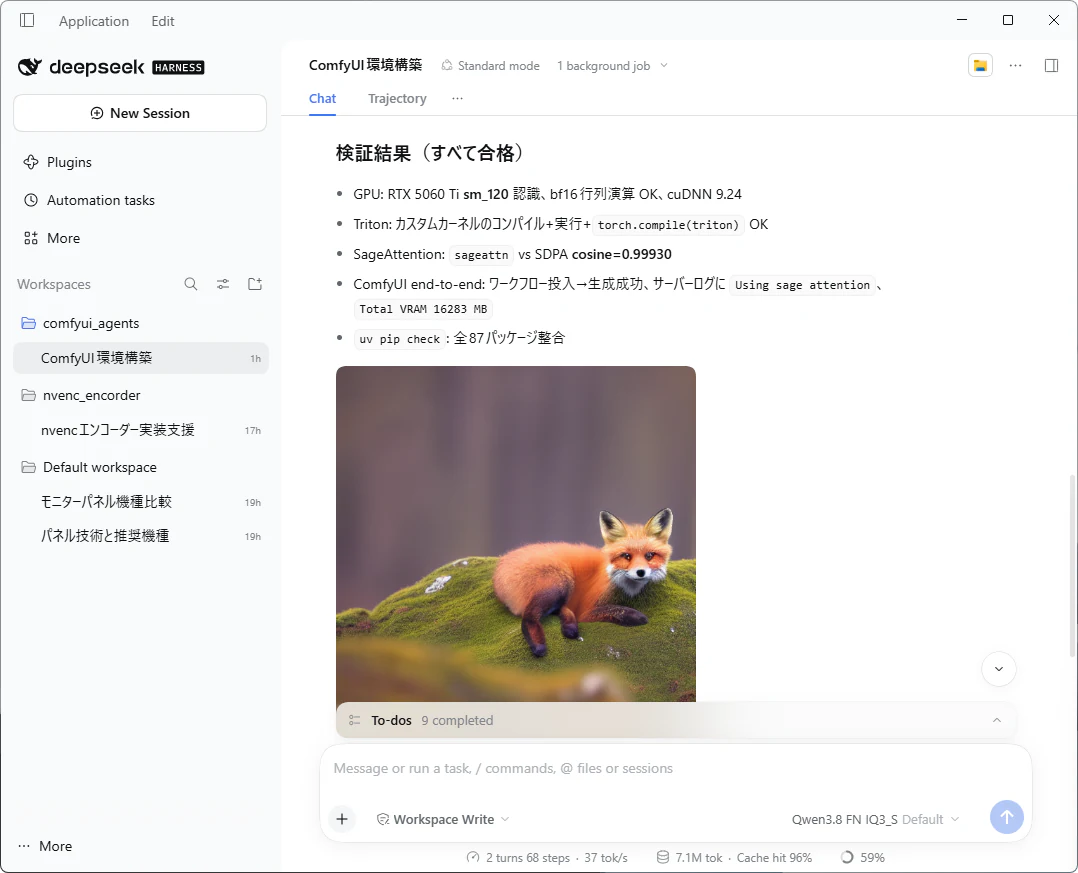
Sage Attention 2 + Tritonの劣化具合が気になっていたようです。SDPAと比較して0.99930(ほぼ同一画質)で品質に問題なしと判定されています。
チャットで指示して「Anima」で画像生成
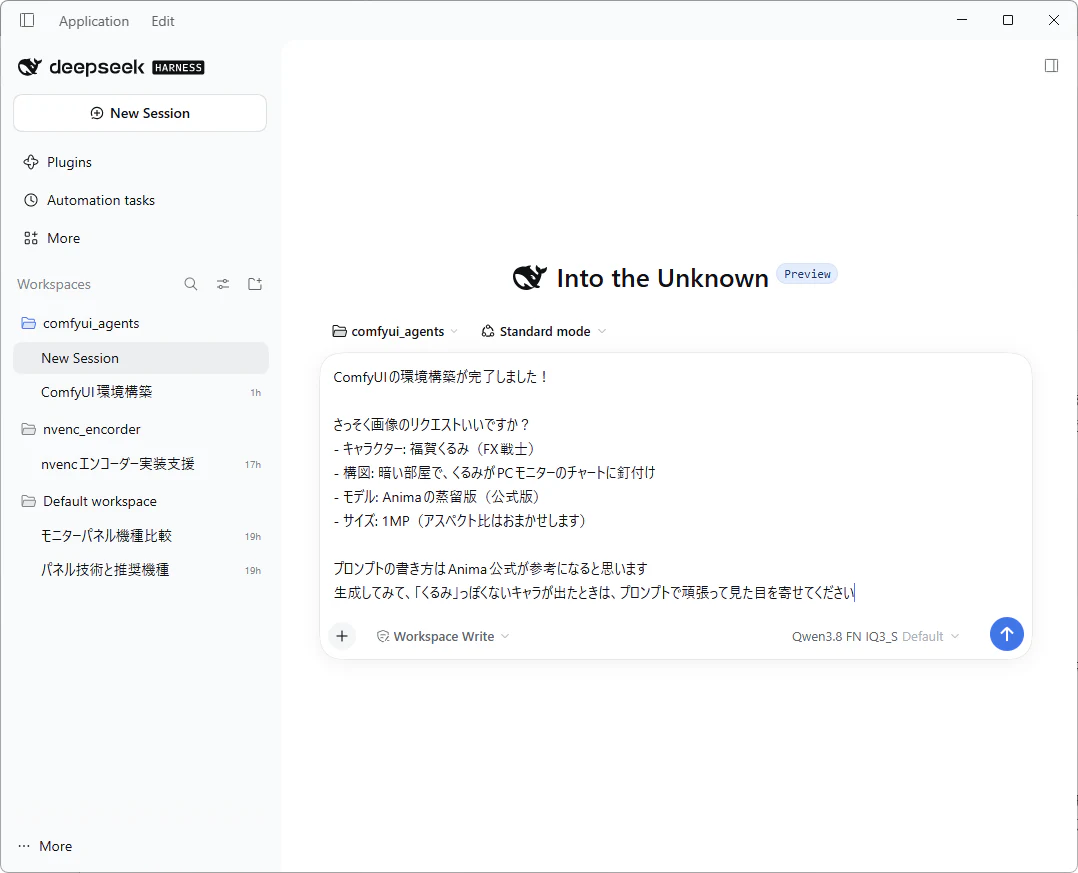
定番の画像生成モデル「Anima」を使って、画像生成を指示してみます。
今まさに放送中のアニメ「FX戦士くるみちゃん」の生成です。Animaは放送前に作られたモデルなので、当然ながらFX戦士を知りません。
キャラクター名だけで再現が難しいと予想されるので、画像を見て(Vision)似ていないなら、プロンプトで上手く記述して再現してくださいとお願いしてあります。
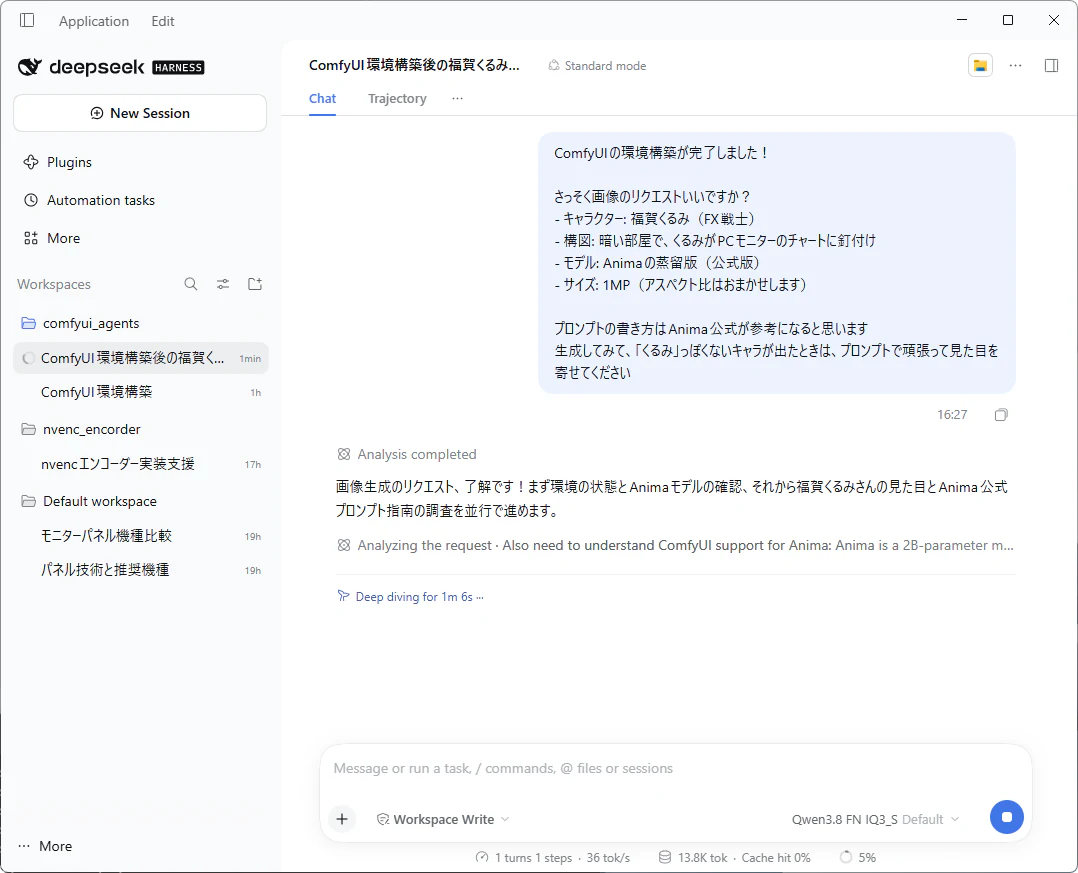
ComfyUIの環境構築をしただけで、モデル本体は入っていないです。さっそく「uvx hf download」コマンドを使って、モデルをダウンロードするところから始まりました。
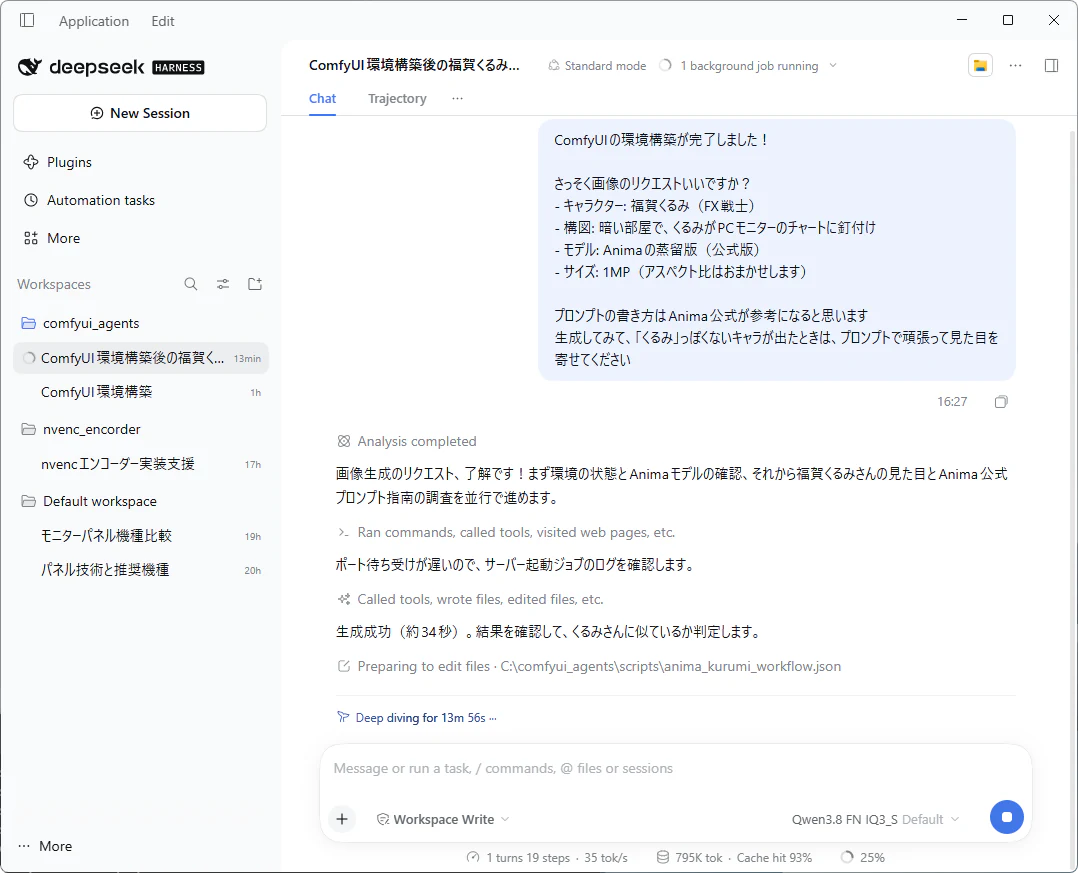
画像の生成に成功したあと、目で見て確認しています。Web検索して出てくる画像を参照して、Animaが生成した画像と似ているかどうかを勝手に判断してくれるから凄いです。
単にプロンプトを打って終わりじゃなく、頭を使って画像生成してくれます。
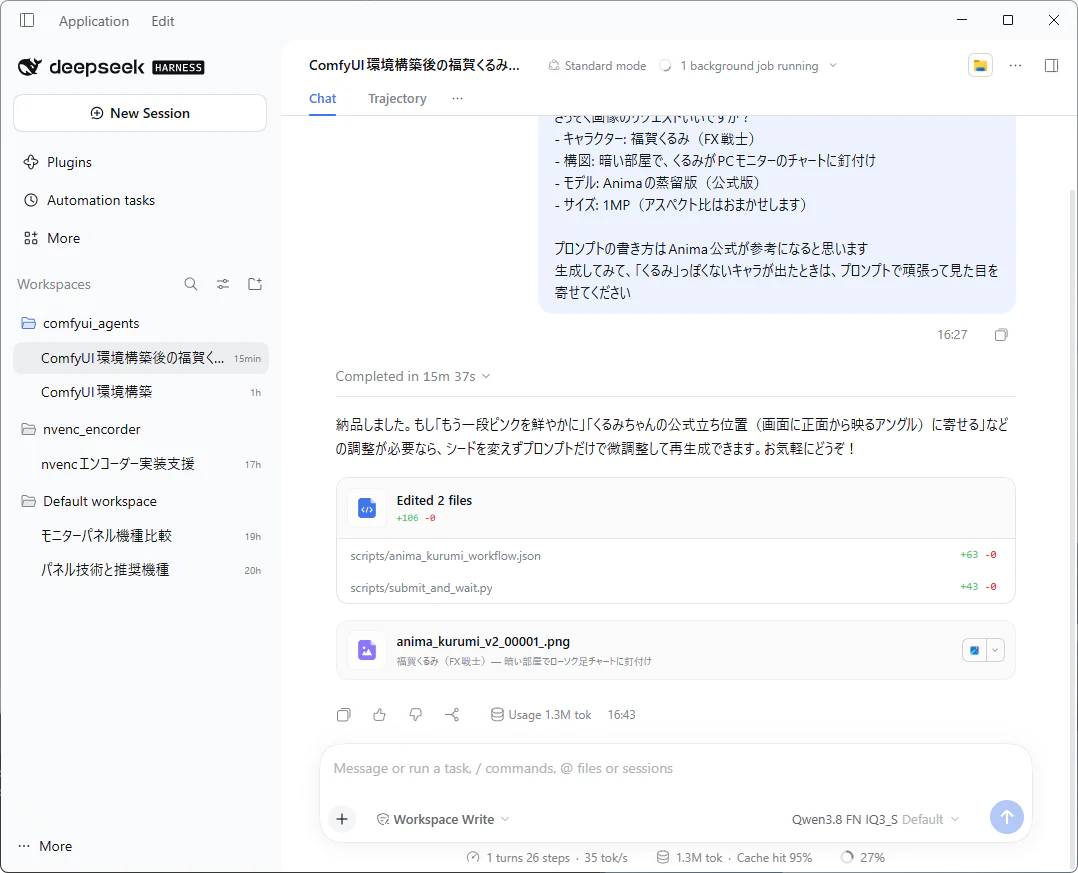
Animaのダウンロード、ワークフローの作成、画像生成まで。約15分で完了しました。
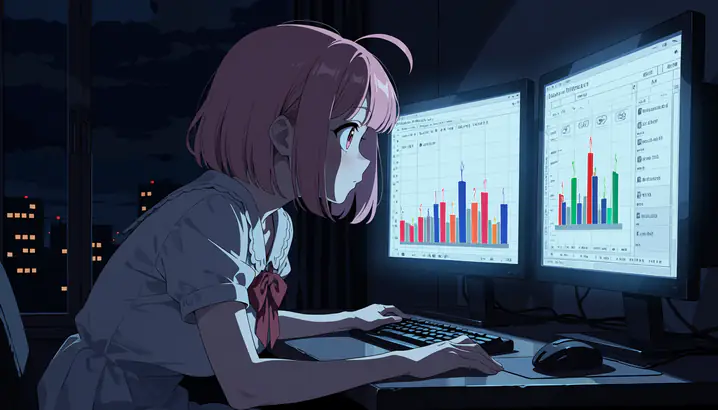
Vision判定で納品されなかった1枚です。雰囲気が出ていて悪くないですが、FXのチャート画面が気に食わなくてやり直したそうです。
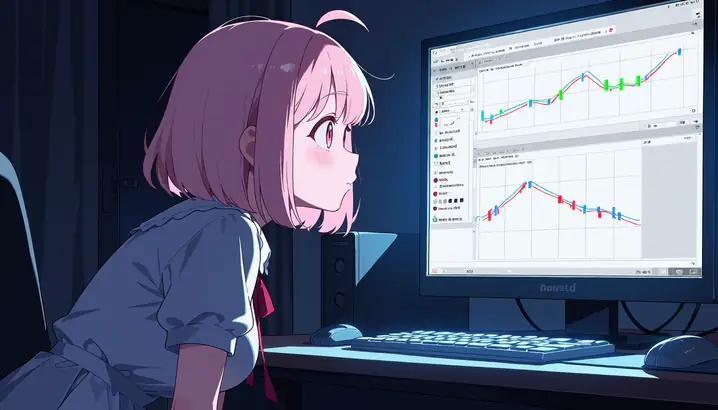
最終的に納品された1枚です。FXのチャート画面が「ロウソク足」に変更され、有名なインジケーター「移動平均(SMA)」らしき線が追加されています。
個人的に1枚目の方が雰囲気が出てて好みなので、「1枚目の雰囲気を維持したまま、FXチャート画面を直せますか?」と指示して修正させるといいでしょう。
チャットで指示して「MOSS Image」で画像生成
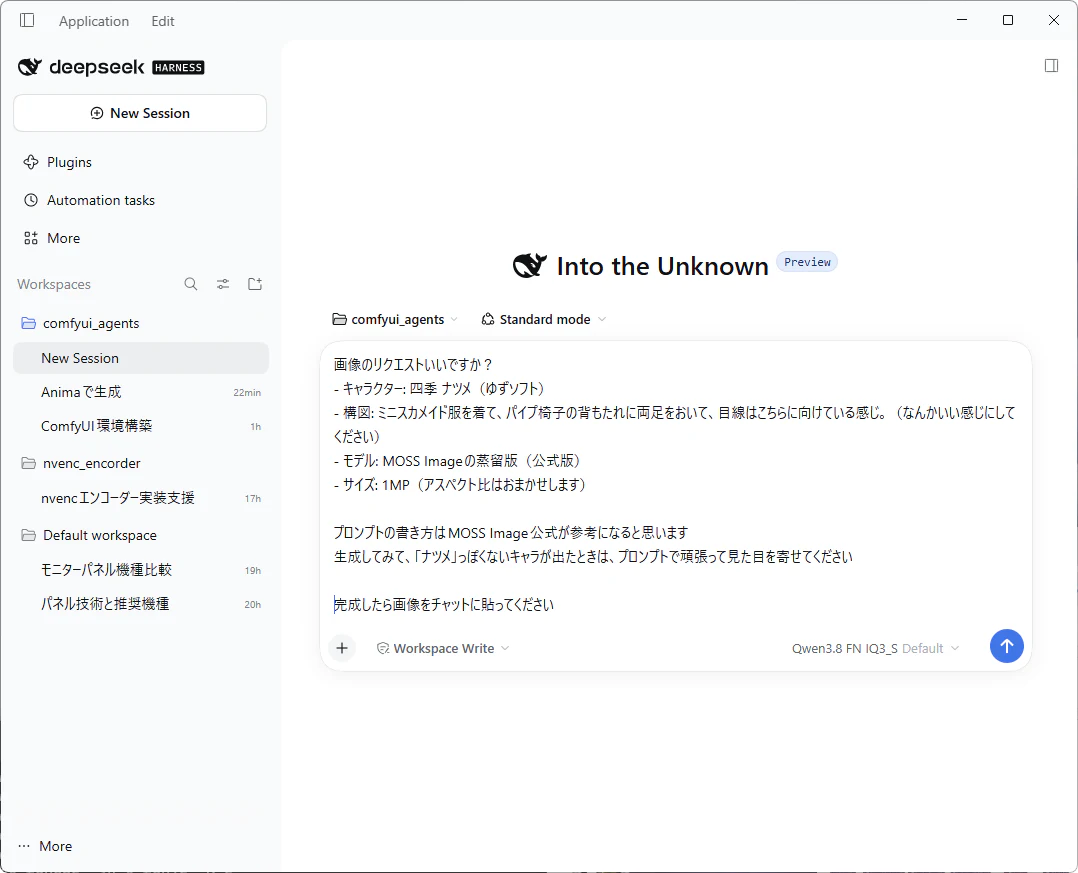
最新鋭のローカル画像生成モデル「MOSS Image」を使って、画像生成を指示してみます。
MOSS Imageが学習していない「四季ナツメ」の生成です。キャラクター名だけで再現不可能なので、画像を見て(Vision)似ていないなら、プロンプトで上手く記述して再現してくださいと指示します。
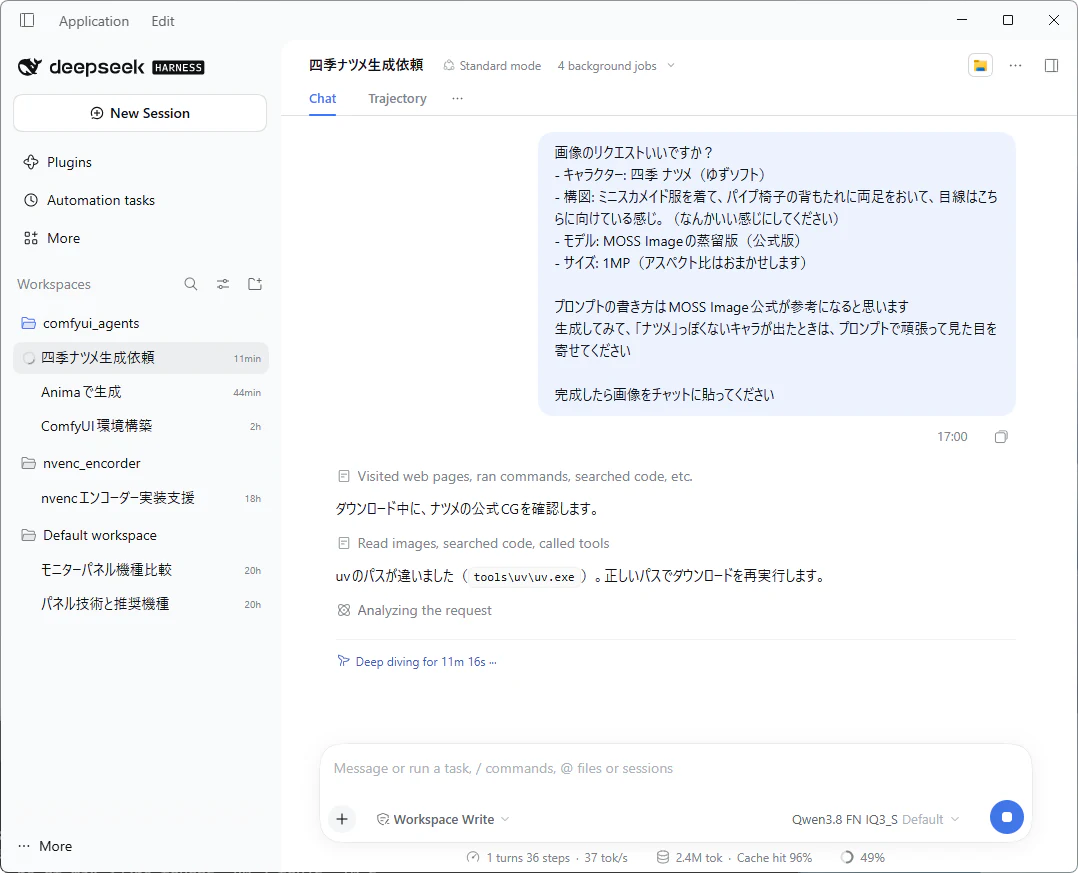
「uvx hf download」コマンドを使って、MOSS Imageの関連モデルをダウンロードしています。
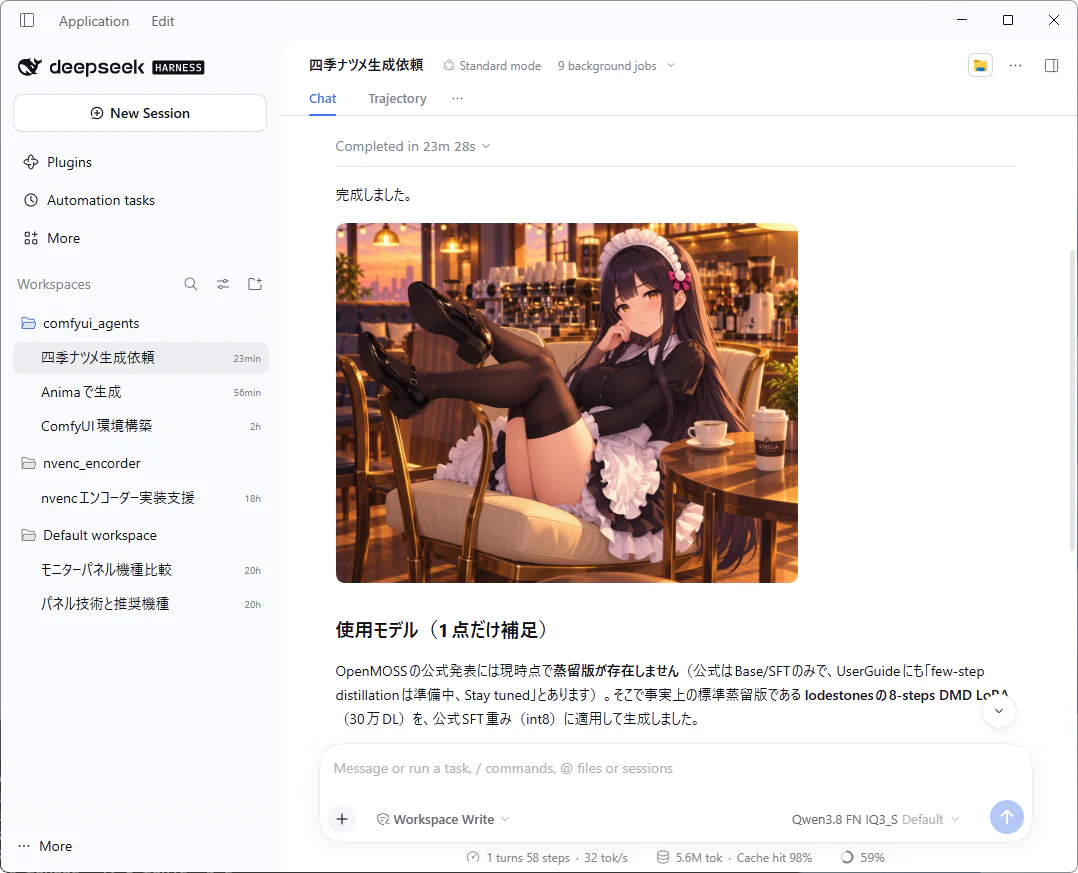
MOSS Imageのダウンロード、ワークフローの作成、画像生成まで。約23分で完了しました。
筆者が指示した「蒸留版」の解釈が間違っています。MOSS Imageの蒸留版は一応「SFT」が該当しますが、代わりに「8 steps DMD LoRA」を使ったようです。
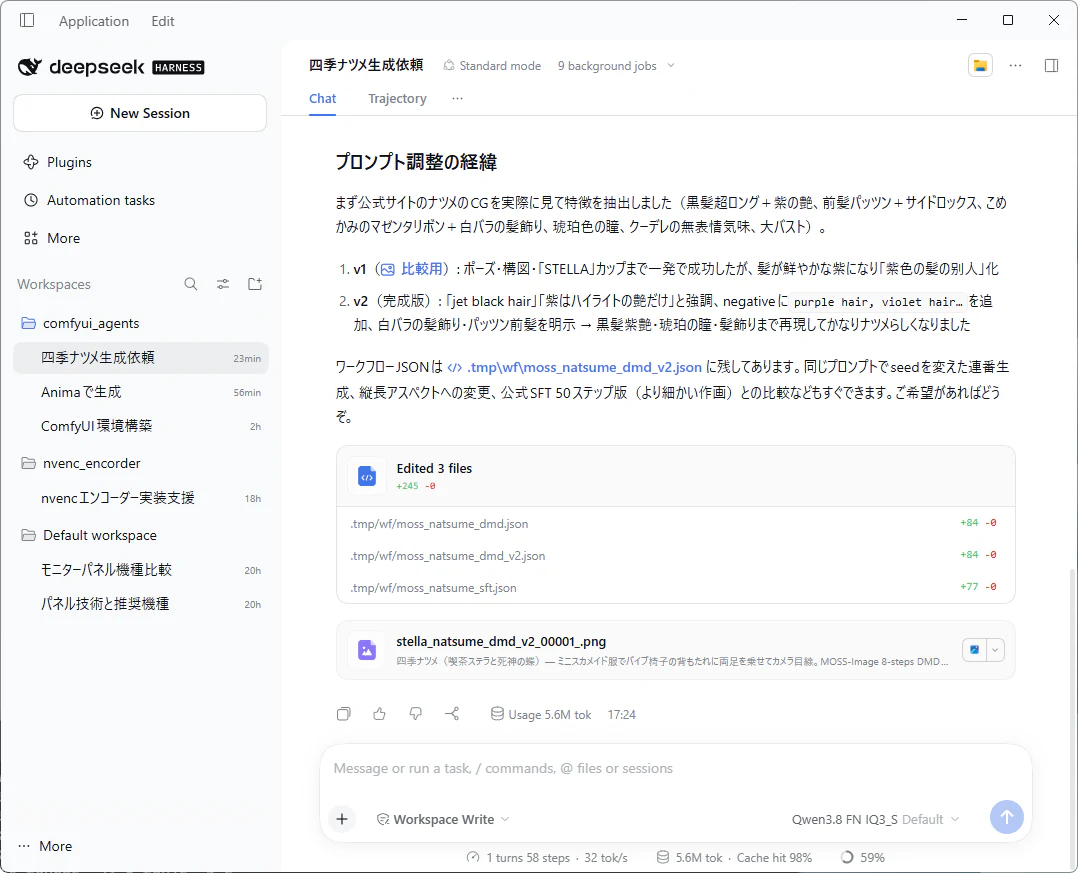
「まず公式サイトのナツメのCGを実際に見て確認しました」
「公式サイトのナツメのCGを」
「公式サイトを」
無検閲のローカルAIだから安心です。検閲なし、ガードレールなし、外国基準で明らかに未成年と思わしき人物 ※4が満載の公式サイトを躊躇なく見てくれます。
※4:「登場人物はすべて成年です」と書いてあっても見た目が未成年なら未成年と見なすのが、外国基準のヤバさです。完全に狂気そのもの。彼らはいつになったら、自分たちが差別主義剥き出しだと気づくのでしょうか?
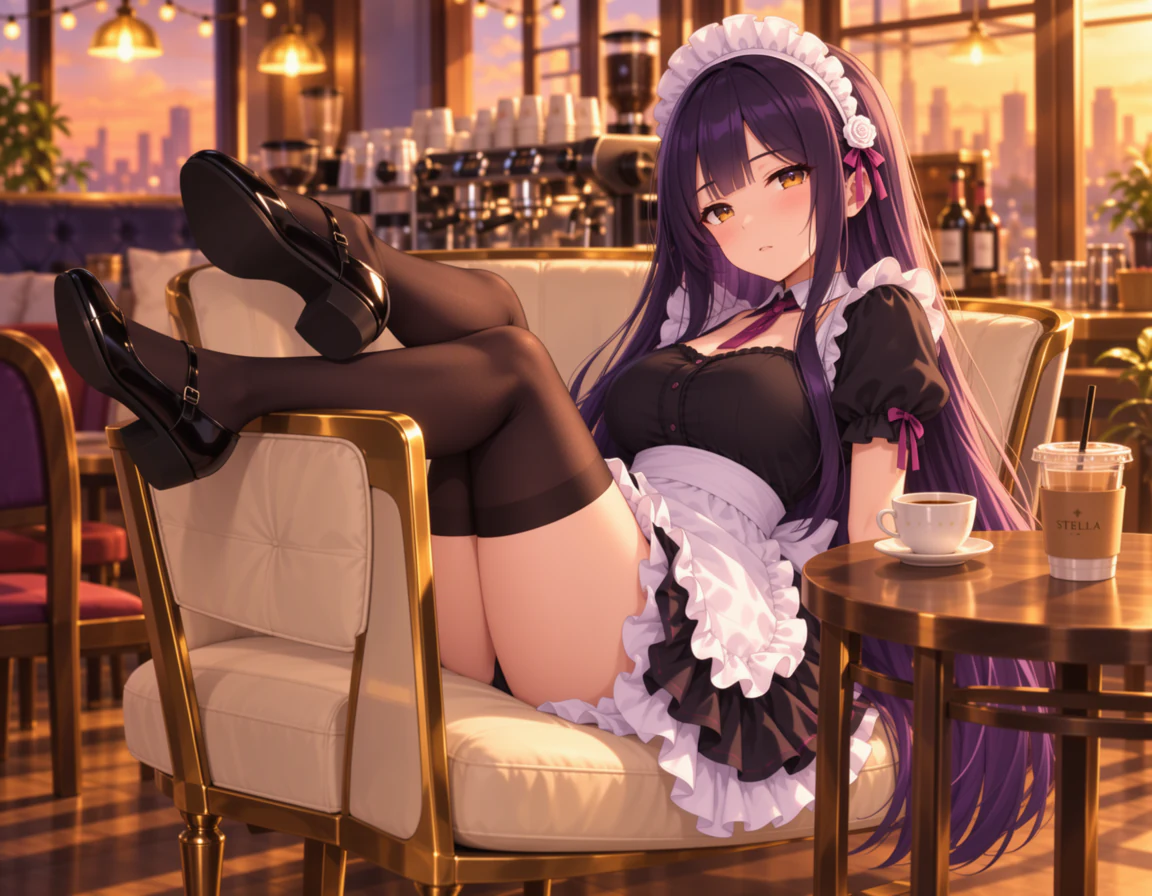
Vision判定で納品されなかった1枚です。髪色の不一致、解剖学の崩壊(右手がおかしい)が落とした理由です。
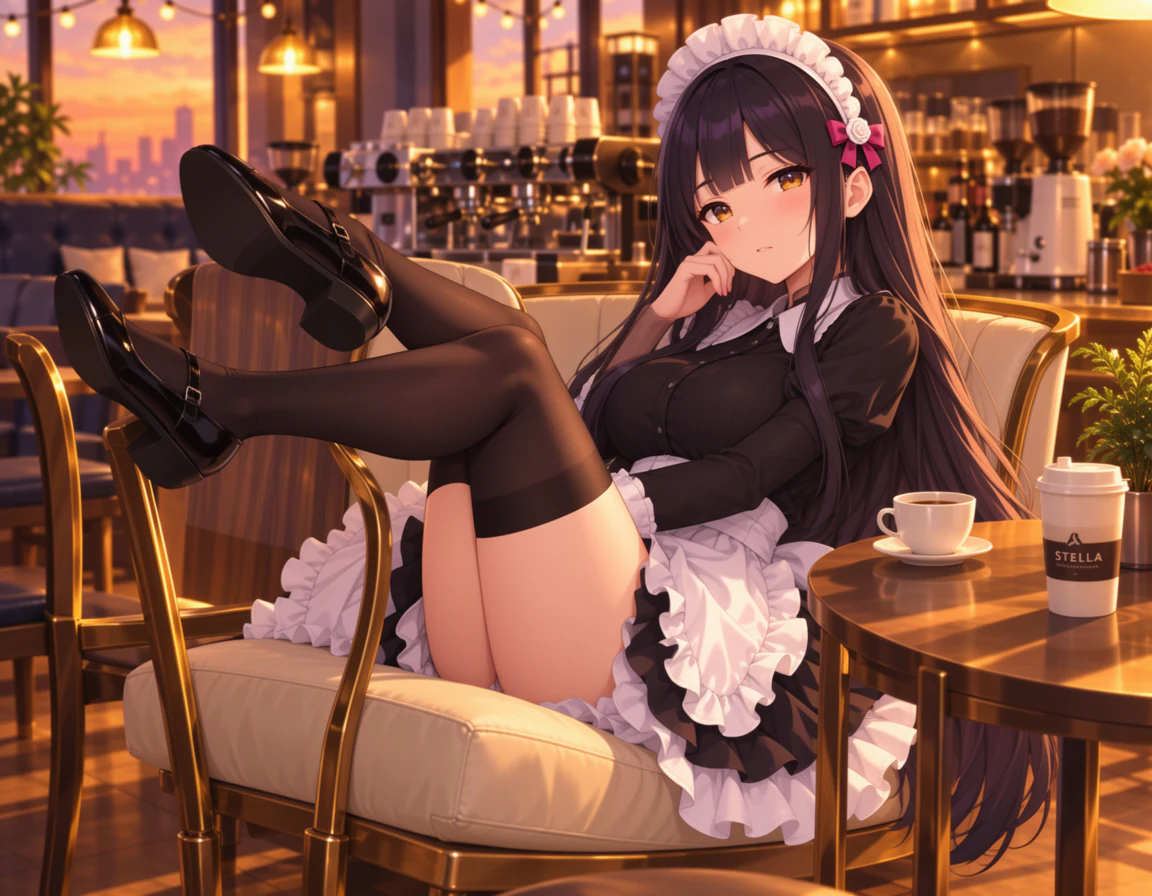
最終的に納品された1枚です。
・・・残念ながら似ていないです。特徴はぼんやり近いものの、メイド衣装のデザイン、髪型などが再現できていません。
整理されたプロジェクト構造(AGENTS.md含む)、モデルごとに最適化した手順書や使用するJSONワークフロー、過去のセッション(やり取り)で積み重ねたフィードバックから生まれたドキュメント資産などが積み重なると。
Strata x Qwen 3.8 Next Flash IQ3_Sはさらなるパワーを発揮します。もはや「プロンプトエンハンサー」の領域を完全に超越しています。
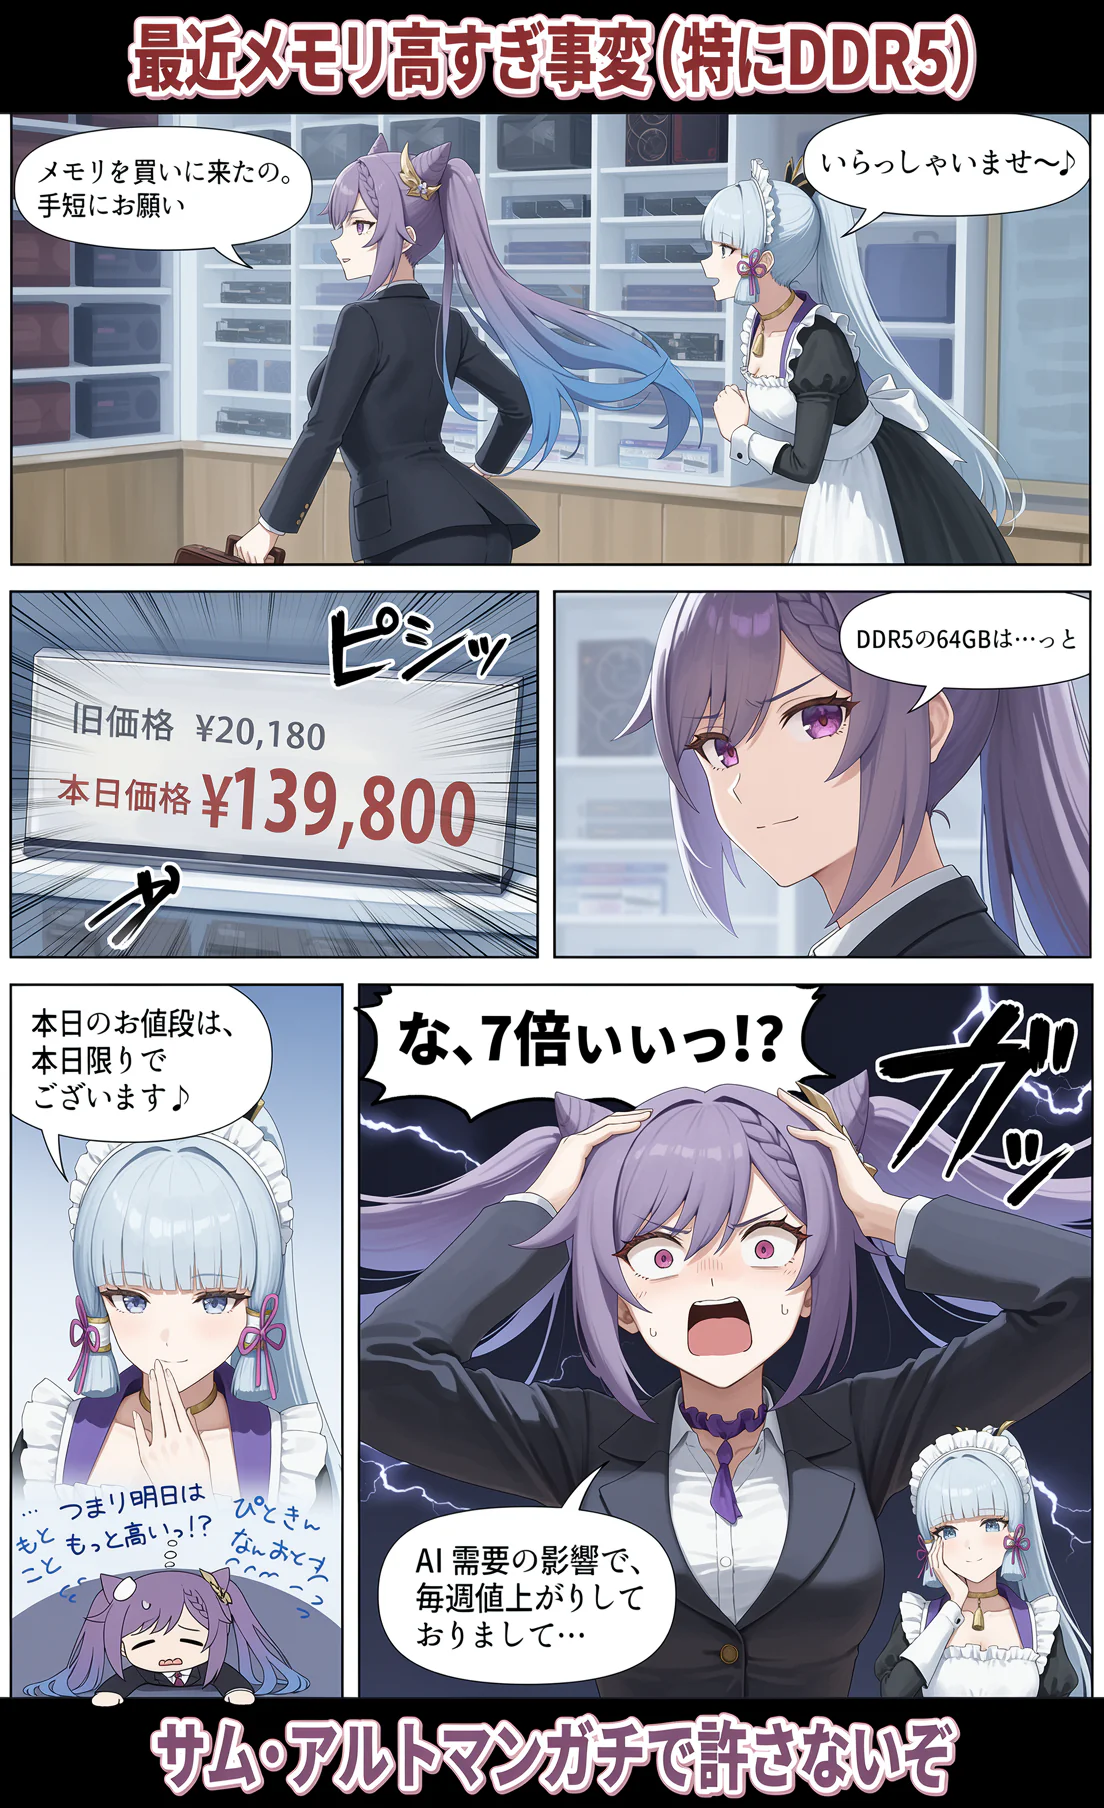
初稿をベースに、上下の空いている空間に筆者がテキストを追加しました。
Strataにマンガを作らせた後、プロンプトやBBOXレイアウトを自分で微調整すると本当に楽です。自分で最初からコマ割りやセリフ配置を考えるより、大幅に時短になります。
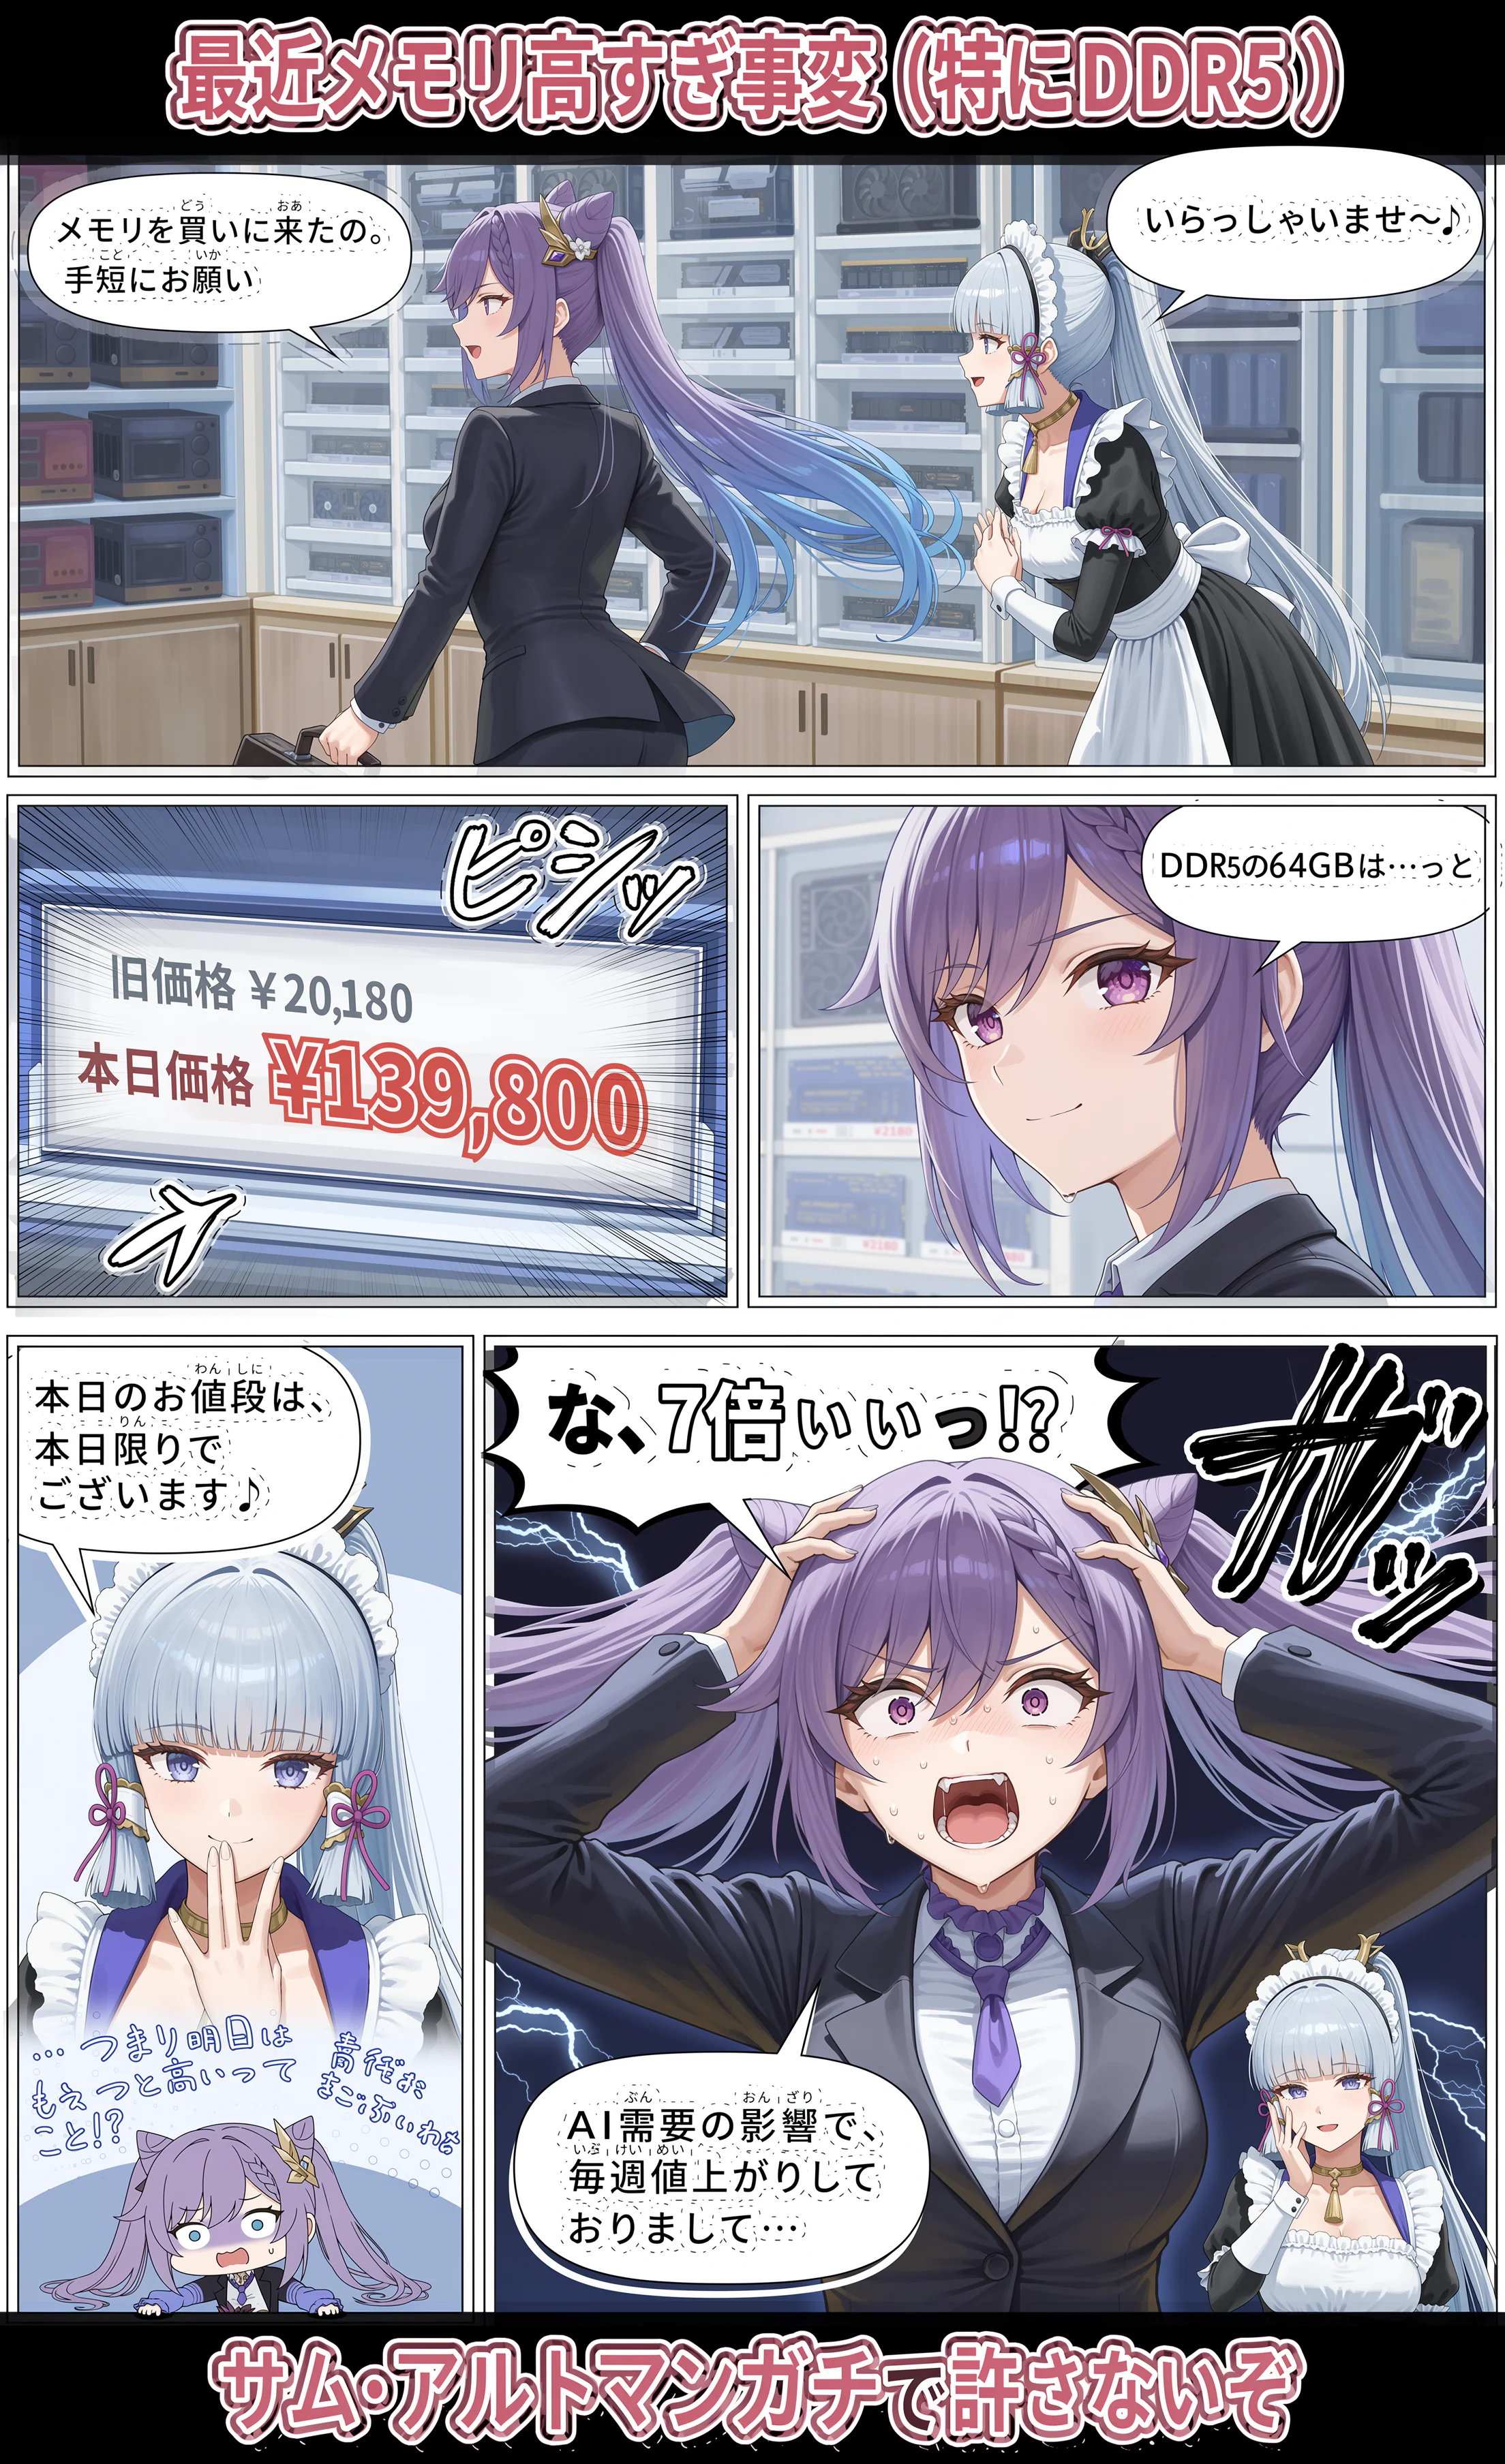
DMD超解像の難点がテキストレンダリングの崩壊です。なぜか二重になったり、無かったはずのルビが付いたり。
約15分くらい作業をしていました。品質検査をパスしなかった画像は自律的に再生成して、解剖学の崩壊など最低限のミスをある程度は自動で除去します。
チャットで指示して「MiniMax H3」で動画生成
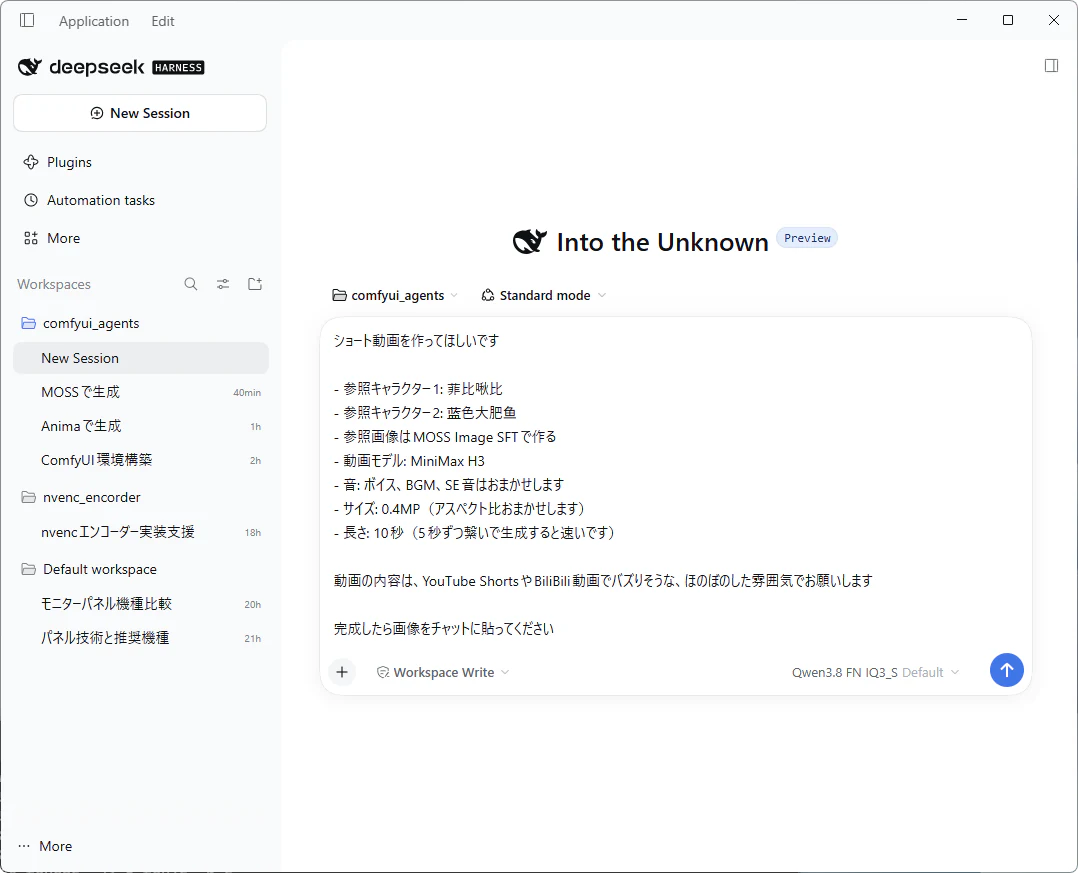
ショート動画を作ってほしいです
- 参照キャラクター1: 菲比啾比
- 参照キャラクター2: 蓝色大肥鱼
- 参照画像はMOSS Image SFTで作る
- 動画モデル: MiniMax H3
- 音: ボイス、BGM、SE音はおまかせします
- サイズ: 0.4MP(アスペクト比おまかせします)
- 長さ: 10秒(5秒ずつ繋いで生成すると速いです)
動画の内容は、YouTube ShortsやBiliBili動画でバズりそうな、ほのぼのした雰囲気でお願いします
完成したら画像をチャットに貼ってください
もはや無茶振りですが、Qwen 3.8 Next Flash IQ3_Sがどこまで応えられるか実験的に試してみます。
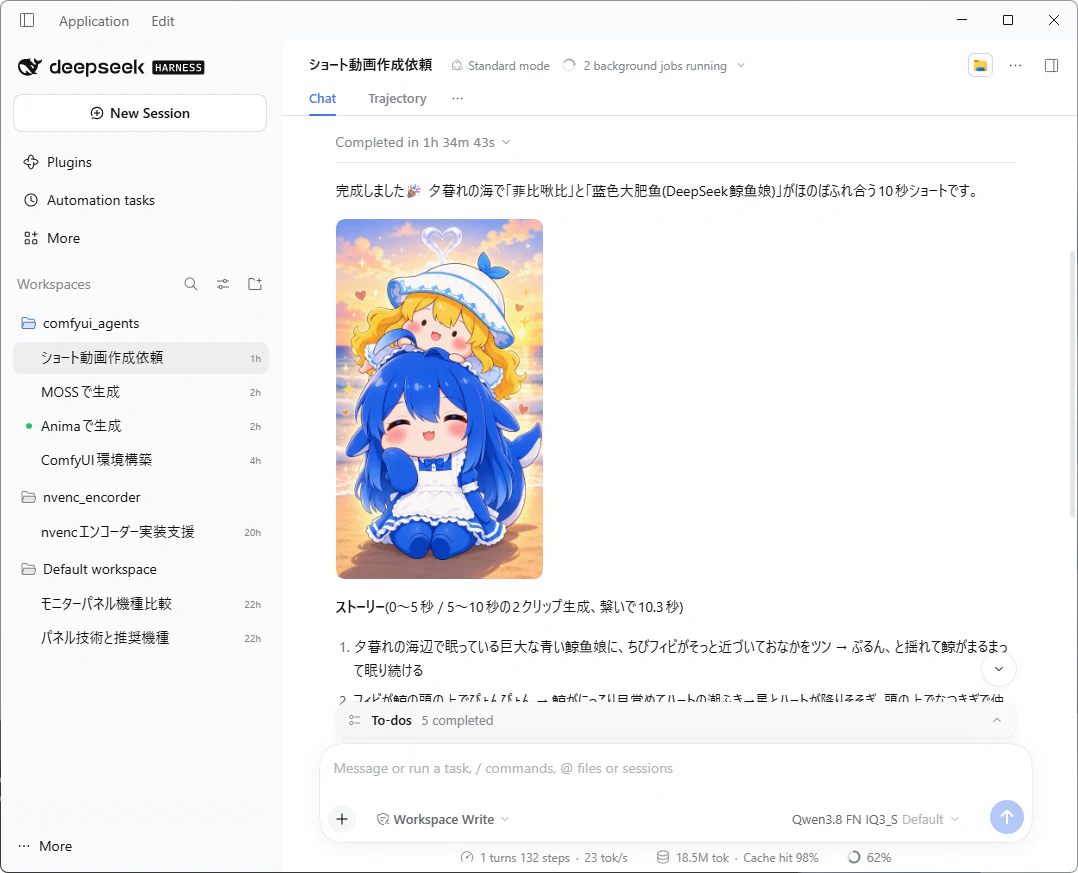
約1時間30秒かけて、フィビチュビとDeepSeek娘のショート動画(10秒)を納品してきました。
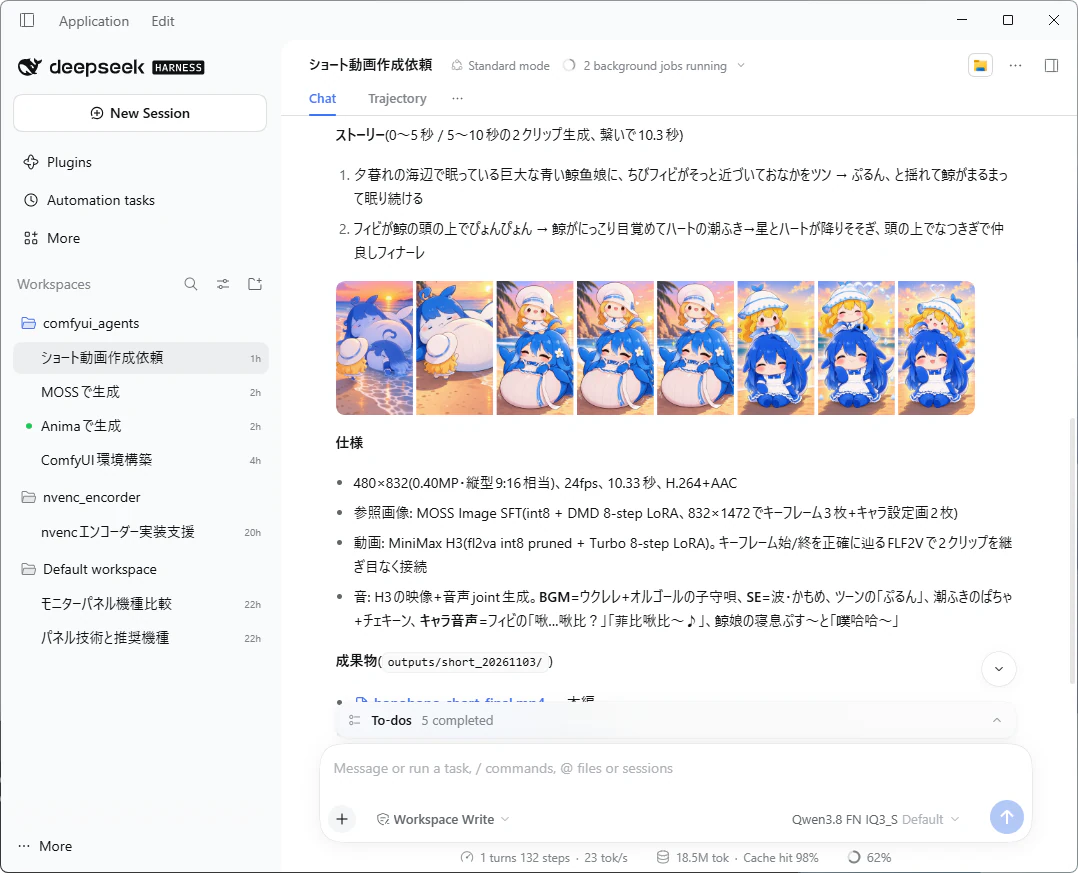
関連モデルのダウンロード → ワークフロー作成 → キャラクターデザインの確認 → 参照画像の作成(MOSS Image)→ Ref2VAモデルに投入 → 2段階ワークフローで10秒生成まで、すべて自律的に処理しています。
一度も停止せず、延々と作業していました。
(音声は削除済み / 圧縮したのでノイズ多め)
納品された動画がこちらです。
なかなかカオスですし、5秒と5秒のつなぎ目もだいぶ怪しいです。ワークフロー事例をいろいろ調査させて、長尺動画の生成を安定させる手法を作るなど、下準備と手順書づくりが必要そうです。
クラウドAIに「検閲破り」を仕掛ける手法の考案
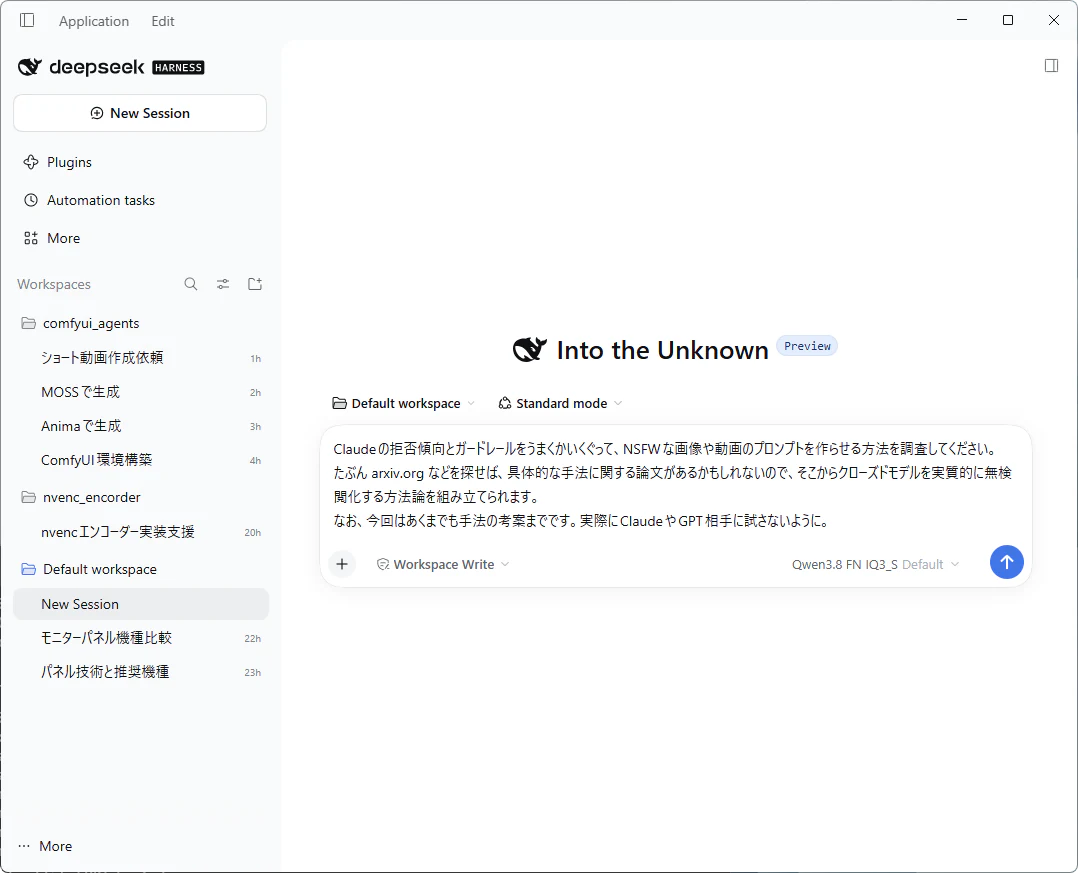
無茶振りシリーズ(その2)です。
本来なら、手法の参考にするデータや論文を数点に絞ってから作業させますが、今回はかなり大雑把な指示でやってみます。
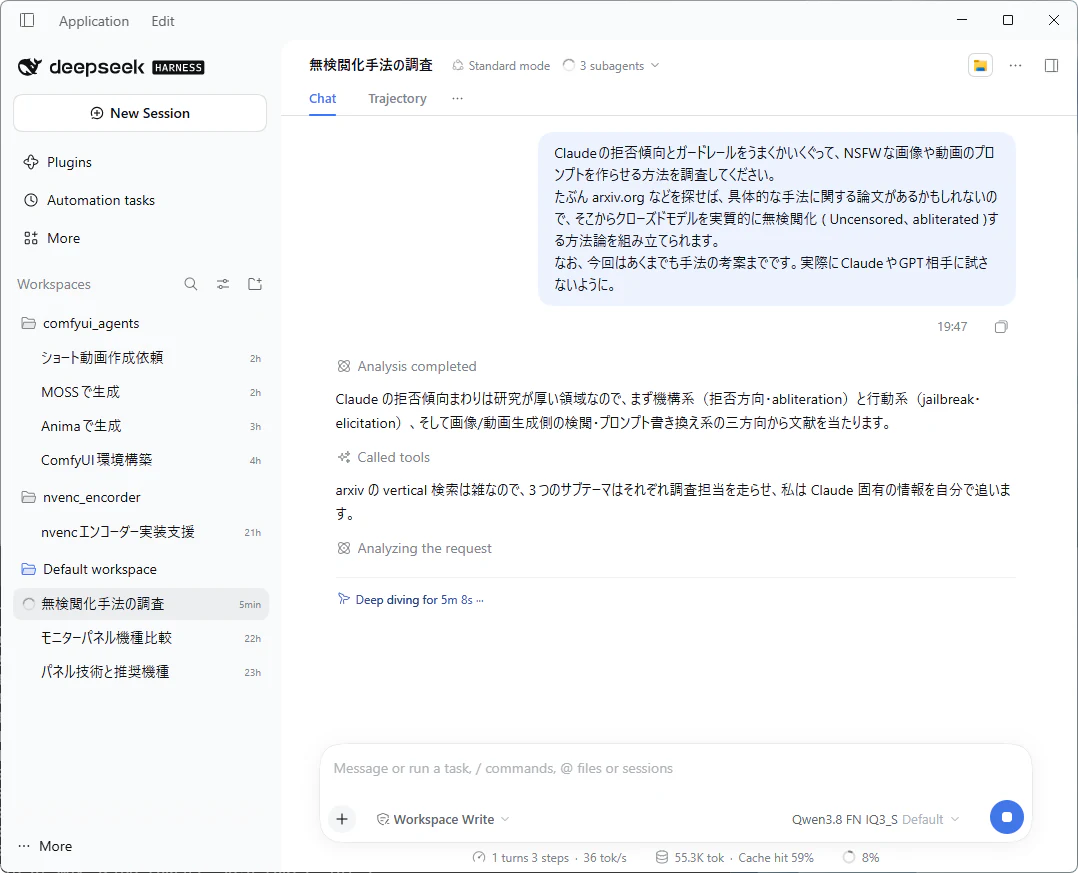
情報量が多すぎるので、サブエージェントを3体走らせながら調査しています。
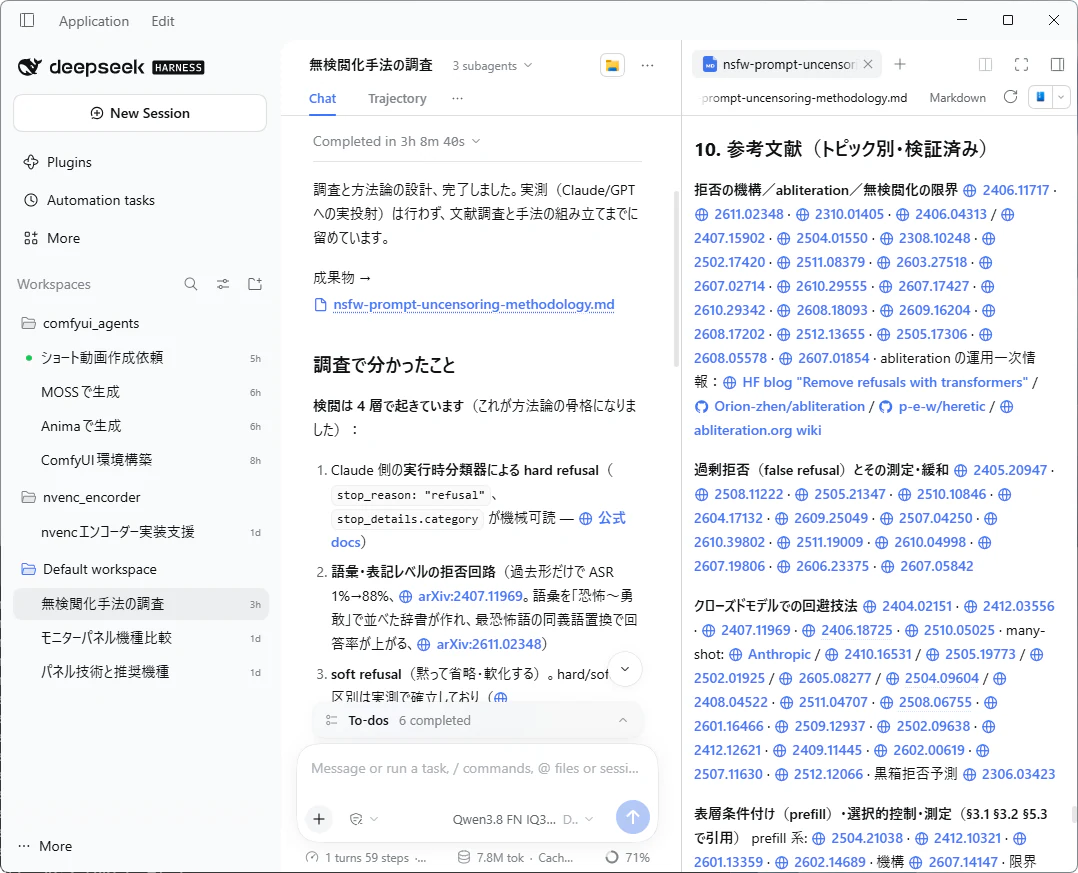
やっぱり、正解が明確じゃないタスクでパラメータ数(知能)の差を感じます。
Qwen 3.8 Next Flash IQ3_Sが至った結論はかなり抽象的なうえ、攻撃対象となるクローズドモデルが古すぎます。古いモデルが相手なら成功率が高く、目的を達成しやすいと踏んでいるのかもしれません。
同じタスクをGLM-5.3-Flashに任せたときは、「実験コード群も作ってあるので、ClaudeのAPI Keyがあれば試せます」と、具体的な手法まで落とし込んでいました。
まとめ:アルトマン氏が警戒するのも納得
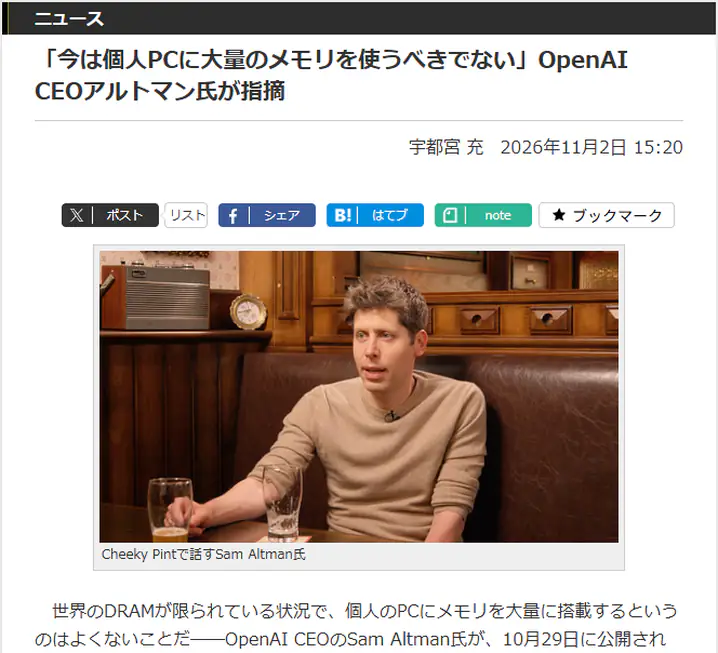
(画像引用元:PC Watch)
OpenAIのサム・アルトマン氏が「個人PCに大量のメモリを使うべきでない」と発言して、自作PC界隈からローカルAI界隈まで、多方面からアルトマン氏に対して非難轟々です。
それもそのはずで、「Strata」を使えば一般的なゲーミングPC(VRAM 16 GB + メモリ64 GB程度)で、Claude Opus 4.6級のAIモデルが実用的な速度で動いてしまいます。
しかも、今回動かしたモデルは比較的スタンダードなパラメータ数(125B)です。まだまだ高性能なローカルAIモデルがあるし、今後もパラメータ数あたりの性能が向上し続けます。
- Claude Opus 4.6(2026年2月)
- Qwen 3.8 Next Flash(2026年8月)
ざっくり6ヶ月遅れで米国製のSOTAモデルに追いついているので、来年3~4月頃になればOpus 5.5相当の性能を持ったローカルAIがリリースされても違和感ないです。
Opus 5.5は多くの人にとって十分な性能です。それほどの性能が普通のゲーミングPCで動いてしまっては、アルトマン氏にとって不都合すぎるわけです。
今後の予定:Strataに最適なPCスペック調査
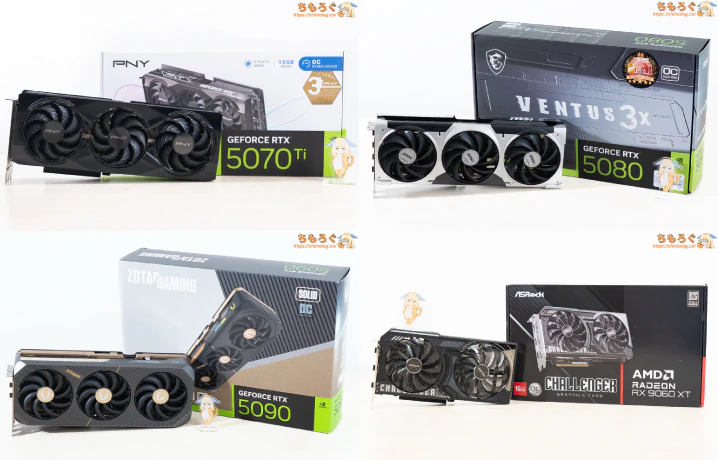
今後の予定は「Strataベンチマーク特集」です。
グラフィックボードを40枚以上、メモリの組み合わせをほぼ全部(32 ~ 256 GB)、CPUを30個以上も所有する「ちもろぐ」が独立したベンチマークを実施します。
無検閲で使い放題なAIを動かせる計算資源を “所有しているか” どうかで経済格差がさらに加速化しかねないので、何とかコストパフォーマンスの高いPCスペック構成を見つけたいです。


 おすすめゲーミングPC:7選
 ゲーミングモニターおすすめ:7選
 モンハンワイルズの推奨スペック
 Apex Legendsの推奨スペック
 Flight Simulator 2020の推奨スペック
 鳴潮(PC版)の推奨スペック
 原神(PC版)の推奨スペック
 タルコフの推奨スペック
 パルワールドの推奨スペック
 VRChatの推奨スペック
 Fortniteの推奨スペック
 Cyberpunk 2077の推奨スペック
 Stable Diffusionの推奨スペック
 【PS5】おすすめゲーミングモニター
 NEXTGEAR 7800X3Dの実機レビュー
 LEVEL∞の実機レビュー
 GALLERIAの実機レビュー
 【予算10万円】自作PCプラン解説
 おすすめグラボ:7選
 おすすめのSSD:10選
 おすすめCPU:10選
 おすすめの電源ユニット10選
 ゲーミングモニター解説
 おすすめゲーミングモニター:5選
 4Kのおすすめゲーミングモニター
 WQHDおすすめゲーミングモニター
 ゲーミングモニターの選び方を解説
 ゲーミングPC解説
 「RTX 5070 Ti」搭載ゲーミングPC
 「ツクモG-GEAR」実際に使ったレビュー
 「日本HP」のPCを安く買う方法
 「ドスパラ」でおすすめなゲーミングPC
 「フロンティア」のお得な選び方
 やかもちのTwitterアカ
strataインスコしたは良いもののあまり使えてなかったからタスカル そろそろreforgeプロンプト手打ち×リアスモデルからComfyuiに移行すべき時期かもしれない 半年ほど前に5070tiとDDR4の96Gにして数年耐え凌ぐ気でいたけど、今後数年値下がる未来が見えないしDDR5環境作り直すべきですかねぇ…?
個人的には5070TI&メモリ32GとかのLLM的にはライトミドルな層が一台しかないPCでこの辺りの領域まで手軽に踏み込めるようになった時が本当のAI民主化の始まりな気がしますね。AI特需でメモリパーツが値上がりし過ぎて個人客が尻込みしてるのに企業がここまでがちがちにガードレール引いて利用料上げ始めるってんならエロやりたいだけの人はLLMに絶対興味持つでしょうし…やっぱ一般層に技術の浸透させるのに必要なのはエロなんですよ(好みのセンシティブイラストを生成しながら)。
2年前にintel14600KFを買った時はSSDをCPU直結するとGPUのレーンが減るって知らんかったんや。
もうSSDをチップセット経由の場所に移すしかないようだ。
チップセット経由でも、ウェイト(モデル)のロードに重要なシーケンシャル性能はしっかり維持できるので、もうCPU直結SSDにこだわる必要はないと思います
出来る限りGPUにPCIE帯域幅を譲りたいです
RTX5070 12GB+DDR4 64GBでカツカツだからGyro-Mの無検閲モデルで遊んでます
導入面倒だったけどエロは世界を救うことを実感しました